
Guía de redes basadas en la nube: arquitectura y ventajas
Descubra qué es una red basada en la nube, cómo funciona su arquitectura y cómo proteger y gestionar el WiFi multisitio WiFi con menos dispositivos locales.
Published 19 de noviembre de 2026
Un invitado le pide la contraseña de la WiFi en una de sus sedes. Usted se la da. En algún lugar de la oficina, un router antiguo hace lo que puede con las reglas de cortafuegos configuradas en 2019, y nadie en la empresa es capaz de recordar cuáles son.
Esa escena se repite en tres o doce ubicaciones, y la fricción se multiplica: un inicio de sesión de administrador independiente para cada equipo, una directiva que existe en un lugar pero no en otro, y una cantidad fija de hardware que permanece inactiva en invierno y al límite de su capacidad en verano. Una red basada en la nube es la solución que eligen la mayoría de los operadores. Ahí es también donde surgen las preguntas clave, ya que trasladar el control a la nube cambia qué funciones siguen operativas cuando una parte deja de funcionar.
Índice de contenidos
- Qué es una red basada en la nube y en qué se diferencia
- Cómo se integran las capas de una red basada en la nube
- Beneficios, costes y dónde se está produciendo la transición
- Protección del tráfico en la capa de DNS
- Qué sigue funcionando cuando falla una red basada en la nube
- Elija una configuración y haga una prueba piloto en un centro
Qué es una red basada en la nube y en qué se diferencia
Imagine una cadena de cafeterías con tres locales. Cada uno cuenta con su propio router, su propio cortafuegos y sus propias credenciales de administrador, y cada uno se configuró una tarde distinta por quien estuviera libre en ese momento. La regla que bloquea el contenido para adultos existe en dos de ellos. Nadie la copió en el tercero y nadie sabe decir cuándo se implementó.
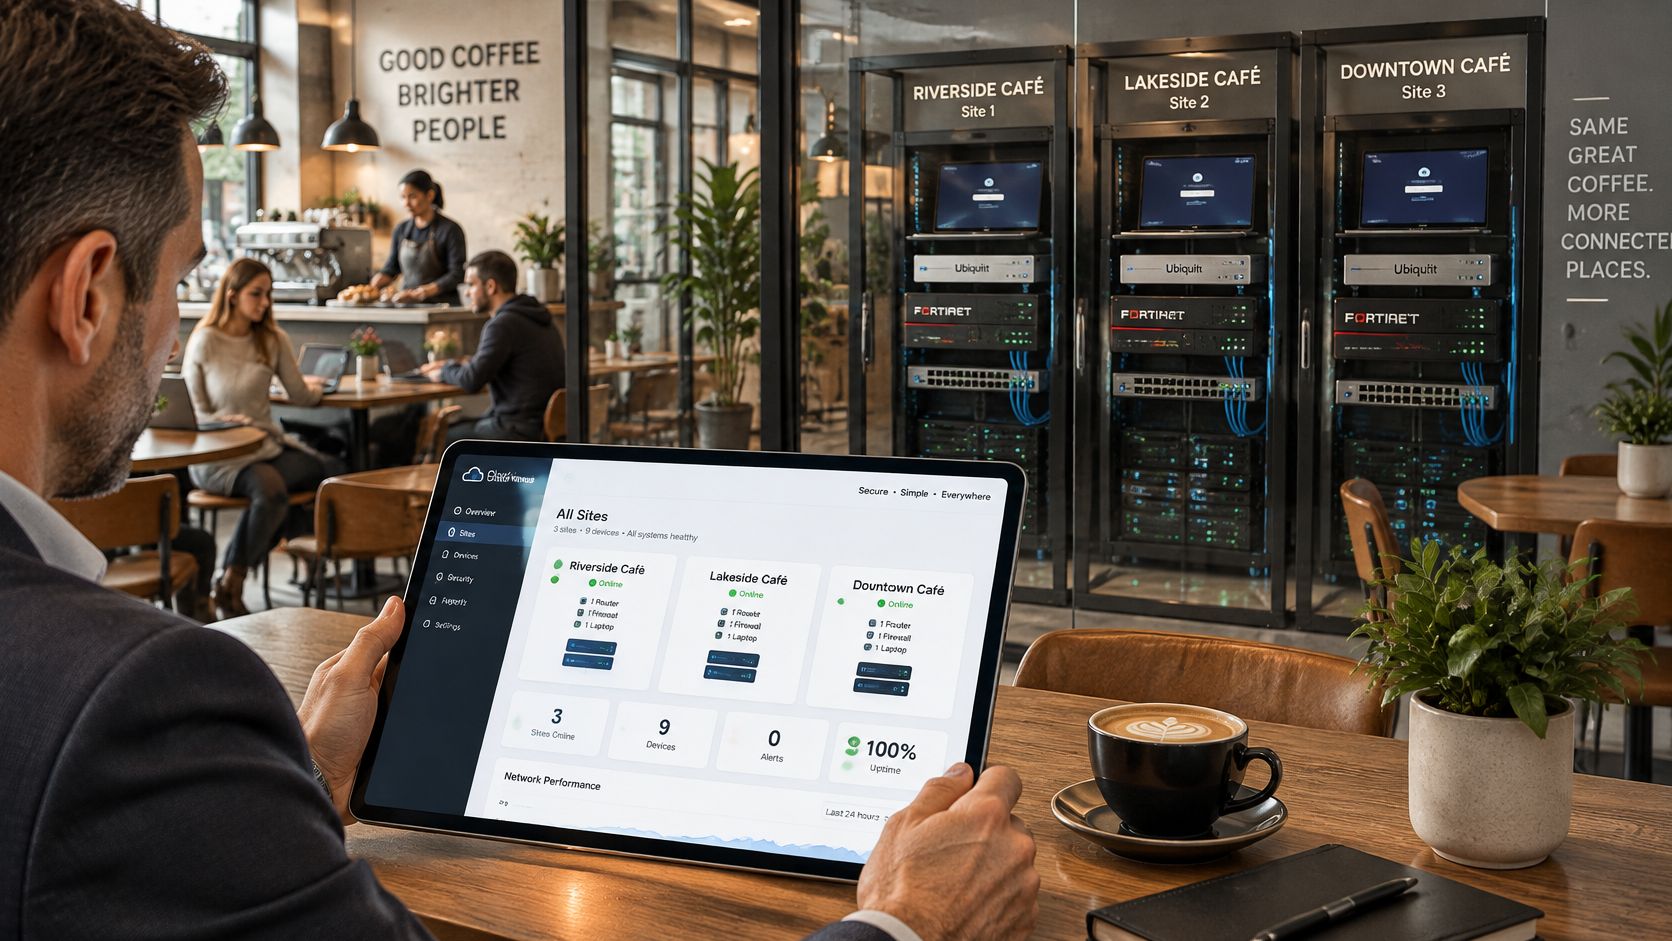
Una red basada en la nube traslada la gestión fuera de las instalaciones. Las directivas, la monitorización, los informes y la configuración residen en una plataforma gestionada por el proveedor. Lo que permanece in situ se simplifica enormemente: puntos de acceso, un switch y un conector ligero que se comunica con la plataforma. Solo tiene que iniciar sesión una vez para ver todas las ubicaciones y modificar una regla para todas ellas al mismo tiempo.
El Instituto Nacional de Estándares y Tecnología de EE. UU. (NIST) publicó en 2011 la definición con la que todavía trabaja la mayor parte del sector, describiendo el cloud computing como el acceso bajo demanda a un fondo común de recursos configurables que pueden aprovisionarse y liberarse con un esfuerzo de gestión mínimo (NIST). Sus cinco características se trasladan con total claridad al ámbito de los recintos. La agrupación de recursos explica por qué comparte la infraestructura con otros clientes en lugar de tenerla en propiedad. La rápida elasticidad explica por qué un recinto en la costa puede admitir más capacidad en agosto sin necesidad de pedir hardware. El servicio medido explica el panel de control y el informe mensual.
Si está valorando qué parte externalizar y qué parte mantener de forma interna, la guía de servicios gestionados en la nube de CEFCore detalla qué cubre en la práctica un modelo gestionado.
Las diferencias que importan a un operador de múltiples ubicaciones se reducen a un puñado de preguntas prácticas.
| Aspecto | Red tradicional | Red basada en la nube |
|---|---|---|
| Dónde reside la política | Hardware in situ en cada ubicación | Plataforma cloud centralizada, aplicada por recinto |
| Añadir un nuevo recinto | Comprar, enviar y configurar hardware in situ | Incorporar el recinto y aplicar las directivas existentes |
| Gestión | Acceso de administración local por dispositivo | Un único panel de control para todos los recintos |
| Escalabilidad de la capacidad | Actualización o sustitución de hardware | El proveedor añade capacidad bajo demanda |
| Dependencia ante fallos | Equipamiento local y enlace local | Ruta de Internet junto con el plano de control del proveedor |
Regla práctica: Si un cambio en una sede debe repetirse manualmente en todas las demás, tiene una red tradicional con una página de inicio de sesión moderna.
Cómo encajan las capas de una red basada en la nube
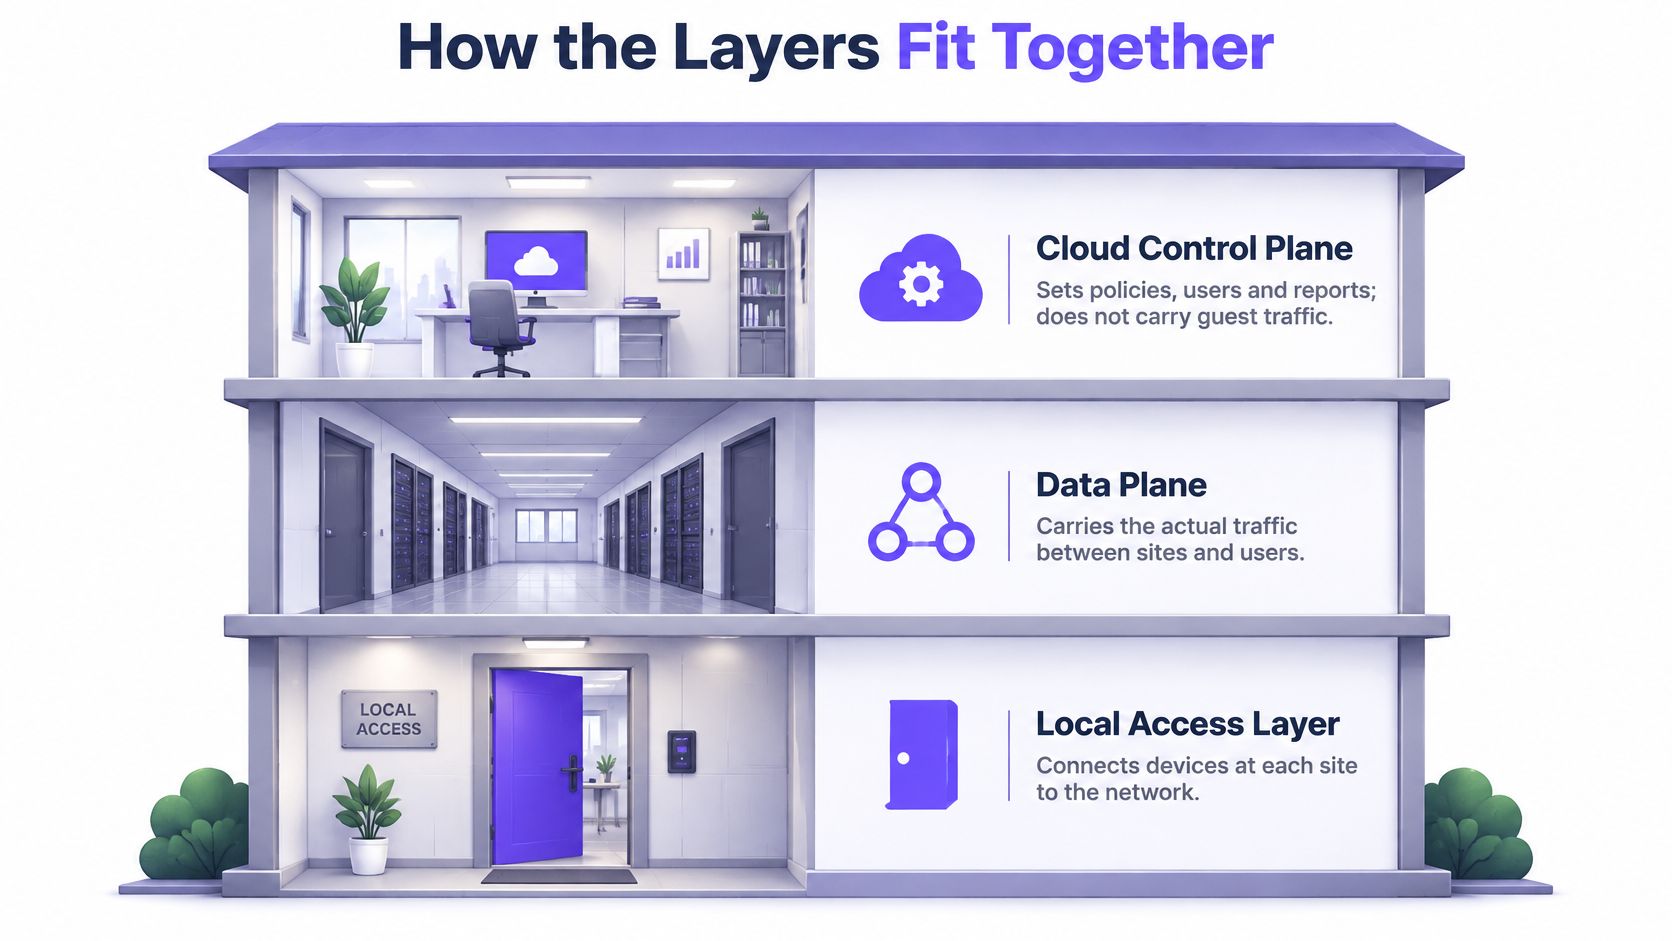
Piense en un edificio de tres plantas. La planta superior es la oficina de administración: este es el plano de control en la nube, donde se configuran las políticas, los grupos de usuarios y los informes. El personal trabaja allí arriba, pero los invitados nunca pasan por ella. El plano de control decide qué debe suceder. No transporta el tráfico de los invitados en sí.
La planta intermedia es el pasillo: el plano de datos. Por aquí circula el tráfico, a través de puntos de acceso, switches y salidas locales en cada ubicación. Aquí es también donde se decide qué dispositivos pueden verse entre sí, y la segmentación de red es la práctica que mantiene los teléfonos de los invitados aislados de los terminales de pago, y estos últimos, separados de los sistemas de gestión interna.
La planta baja es la capa de acceso local: la puerta por la que entra cada dispositivo.
Entre la oficina y el pasillo se encuentra el punto de control por el que pasa primero cada conexión: la capa de DNS. Nada llega al pasillo sin que se resuelva un nombre.
Una conexión de invitado, paso a paso
- El dispositivo se une a la SSID y el punto de acceso local lo acepta. Esto ocurre in situ, no en la nube.
- El dispositivo recibe una dirección IP mediante DHCP. La dirección va primero, antes de cualquier navegación.
- El dispositivo solicita un nombre, y esa búsqueda se dirige al resolutor en la nube en lugar de a lo que el router tenga codificado de forma fija.
- El resolutor responde «permitir» o «bloquear» en milisegundos, según la política establecida para esa SSID.
- Solo entonces se abre la conexión, ya sea para una página web, una aplicación o una sincronización en segundo plano.
De este modo, las tres capas forman una jerarquía. La directiva se decide en la parte superior, la aplicación tiene lugar en el punto de control de DNS y el reenvío se produce en el pasillo. Esta misma arquitectura se utiliza mucho más allá de WiFi; por eso la conectividad IoT para máquinas expendedoras se apoya en una capa de control en la nube con un comportamiento local que resiste a la pérdida del enlace.
Un fallo en la capa de gestión y un fallo en la capa de reenvío no son el mismo evento. Si pierde la oficina no podrá cambiar nada, pero el pasillo seguirá transportando tráfico. Si pierde el pasillo, ningún panel de control del mundo servirá de ayuda al invitado que tenga delante.
Ventajas, costes y dónde se está produciendo el cambio
Este cambio se refleja primero en el gasto. Gartner pronosticó que el gasto mundial de los usuarios finales en servicios de nube pública alcanzaría los 675.400 millones de dólares en 2024, frente a los 561.000 millones de 2023 (un incremento del 20,4 %), proyectando además que la infraestructura como servicio -la categoría más cercana a la capacidad de red virtualizada- crecería un 25,6 % hasta los 180.000 millones de dólares (Gartner).
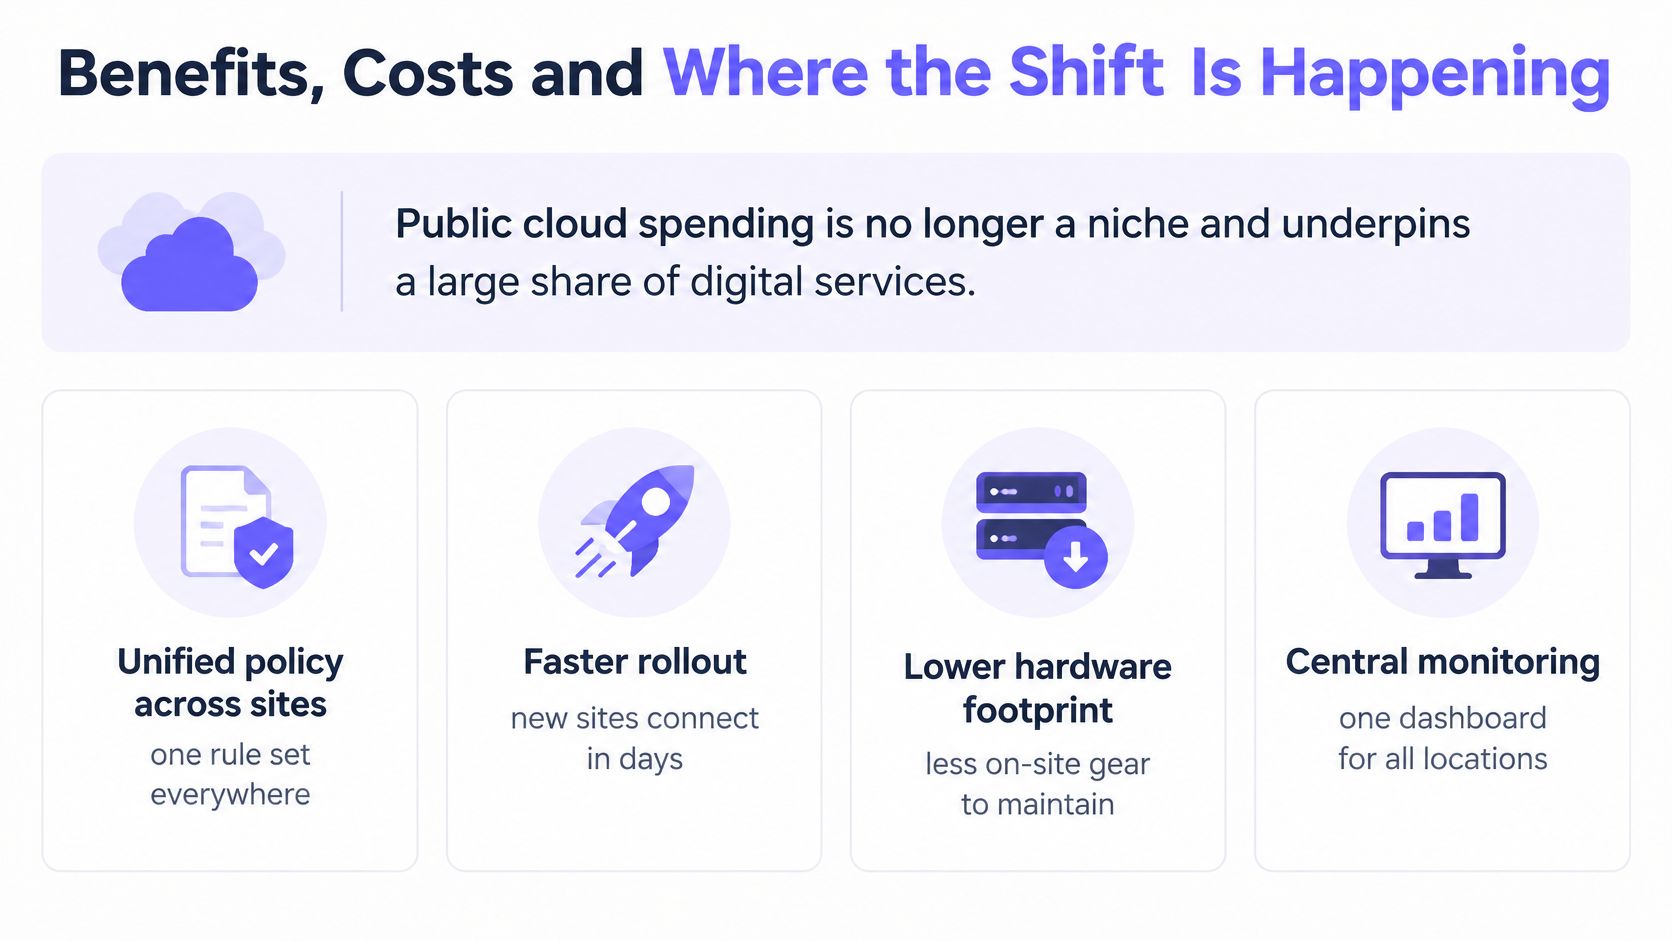
La adopción es generalizada y no se limita a las grandes empresas. Eurostat constató que el 52,7 % de las empresas de la UE utilizaron servicios en la nube de pago en 2025, lo que supone un incremento de 7,4 puntos porcentuales con respecto a 2023 (Eurostat). La Oficina Central de Estadísticas de Irlanda registró que el 42,6 % de las empresas irlandesas adquirieron software de seguridad basado en la nube en 2025 (Central Statistics Office). El gasto también se está concentrando: el 40 % de las empresas encuestadas por Flexera invirtieron más de 12 millones de dólares al año en nube pública, frente al 36 % del año anterior (Flexera).
Si prefiere ver una demostración guiada en lugar de leer el resto, esto explica el modelo en unos minutos.
Para un operador de múltiples ubicaciones, cada ventaja conlleva un coste equivalente.
- Incorporación más rápida, compensada por costes recurrentes. Un nuevo recinto se integra en cuestión de días en lugar de esperar una orden de compra y una visita técnica in situ; sin embargo, una suscripción sustituye el gasto de capital en hardware, y ese coste nunca cesa por completo.
- Un único conjunto de políticas en todas partes, compensado por la formación. Las reglas centralizadas permiten que un cambio de protección se aplique en todos los recintos en cuestión de minutos, pero también exigen que su equipo aprenda a utilizar una nueva consola y confíe en ella.
- Registros centralizados para auditorías, compensados por la dependencia del enlace. Los informes se extraen de un único lugar, pero el tráfico sigue circulando a través de la conexión a Internet propia de cada recinto, y ninguna plataforma puede solucionar una mala línea.
Supongamos que un grupo hotelero con doce establecimientos pasa de controladores locales a una gestión centralizada. Incorporar una nueva propiedad pasa a ser una entrada en la plataforma más una política aplicada a partir de una plantilla existente, y la administración rutinaria se reduce de un recorrido por doce inicios de sesión a una sola cola de revisión.
| Métrica | Cifra | Comparación | Fuente |
|---|---|---|---|
| Gasto mundial de usuarios finales en nube pública en 2024 | 675.400 millones de dólares | 561.000 millones de dólares en 2023, un 20,4 % más | Gartner |
| Gasto en IaaS en 2024 | 180.000 millones de dólares | 143.300 millones de dólares en 2023, un 25,6 % más | Gartner |
| Gasto en PaaS en 2024 | 172.400 millones de dólares | un 20,6 % más | Gartner |
| Gasto en SaaS en 2024 | 247.200 millones de dólares | un 20,0 % más | Gartner |
| Gasto de usuarios finales en nube pública en 2025 | 723.400 millones de dólares | previsión posterior a la cifra de 2024 | Gartner |
| Empresas de la UE que utilizan servicios en la nube de pago en 2025 | 52,7 % | 7,4 puntos porcentuales más que en 2023 | Eurostat |
| Empresas irlandesas que adquieren software de seguridad basado en la nube en 2025 | 42,6 % | Solo Irlanda | Oficina Central de Estadísticas |
| Empresas que gastan más de 12 millones de dólares al año en nube pública | 40 % | 36 % en el año anterior | Flexera 2025 |
Las ventajas son mayores cuando las sedes son numerosas, similares y están gestionadas por un equipo pequeño. Doce redes de hotel prácticamente idénticas rentabilizan una gestión centralizada. Un edificio atípico con equipamiento a medida puede no hacerlo.
Protección del tráfico en la capa de DNS
El DNS es el primer punto práctico donde denegar algo. Se puede rechazar un dominio durante la resolución de nombres, antes de que el dispositivo tenga una dirección de destino y antes de que se inicie una sesión web, TLS o de comando y control. Para entonces, el dispositivo ya tiene una dirección IP. Simplemente no tiene la que deseaba.
Una capa de DNS en la nube cumple tres funciones, y merece la pena nombrarlas por separado porque los proveedores tienden a confundirlas.
- Filtrado por categorías. Contenido para adultos, juegos de azar, alojamiento de malware o lo que determine la política, aplicado por cada SSID para que una red de empleados y una sala de lectura infantil no compartan el mismo conjunto de reglas.
- Bloqueo de amenazas. Dominios de suplantación de identidad (phishing), servidores de distribución de malware y llamadas de retorno de comando y control (C2), neutralizados en la búsqueda en lugar de tras la entrega de la carga útil.
- Eliminación de anuncios y rastreadores. Un menor número de solicitudes a terceros se traduce en páginas más ligeras y menos datos consumidos en el teléfono del invitado.
Qué debe protegerse para que esto funcione
Un DNS seguro presenta tres requisitos independientes, que a menudo se venden como uno solo: integridad, confidencialidad y disponibilidad. DNSSEC abarca la integridad al validar que una respuesta firmada no haya sido manipulada. La confidencialidad es más fácil de descuidar, ya que incluso una respuesta correcta puede filtrar la consulta cuando las búsquedas viajan en texto sin cifrar. La disponibilidad requiere una planificación propia, por lo que los operadores siguen implementando resolutores dispersos, tolerancia a fallos y más de un resolutor recursivo en la configuración.
Esto ofrece una breve lista de verificación para cualquier red pública o de invitados:
- Enrute todo el DNS de los clientes hacia resolutores bajo su control, en lugar de permitir que los dispositivos elijan el suyo.
- Evite omisiones de seguridad cuando el hardware lo permita, bloqueando el tráfico DNS saliente hacia otros servidores.
- Valide las respuestas DNSSEC para que se rechace cualquier respuesta falsificada.
- Proteja el transporte de consultas donde apliquen normativas de privacidad, de modo que las búsquedas no sean legibles en tránsito.
- Conserve los registros el tiempo suficiente para determinar a qué intentó acceder un dispositivo y cuándo.
Cada elemento es un modo de fallo que conviene probar antes de que un incidente lo haga por usted. Dirija un dispositivo a un sistema de resolución externo y compruebe si la regla de bypass lo detecta. A continuación, pregúntese qué sucede cuando los sistemas de resolución dejan de responder: optar por el modo «fail open» mantiene a los invitados conectados pero desactiva todas las directivas, mientras que el modo «fail closed» mantiene las directivas pero convierte un fallo del sistema de resolución en una interrupción del servicio. Purple Shield funciona en modo «fail closed» y se ejecuta en varios centros de datos, por lo que un fallo en uno de ellos no interrumpe el servicio.
Consulte el registro antes de confiar en el filtro. Una página de bloqueo no demuestra nada por sí sola. El registro de resolución demuestra qué se denegó, en qué red y a qué hora.
El filtrado de DNS convive con la protección de endpoints, los cortafuegos y los controles de aplicaciones, y los argumentos a favor de la seguridad DNS como capa de control se basan en que se trata de una capa entre varias, y no de un sustituto de estas.
Qué sigue funcionando cuando una red basada en la nube falla
Una ubicación puede perder su panel de control en la nube y seguir transmitiendo tráfico. También puede mantener el panel de control y perder la ruta DNS que aplica el filtrado. Estos fallos parecen similares a simple vista, pero afectan a partes diferentes de la red. Diseñe cada uno por separado.
Un estudio del sector reveló que el 60 % de los profesionales de TI había sufrido una interrupción en su red en la nube en los 12 meses anteriores. Entre las causas reportadas figuraban caídas del proveedor de nube, errores humanos, integraciones de terceros, ciberataques y errores de configuración (estudio del sector de Aviatrix de 2025).
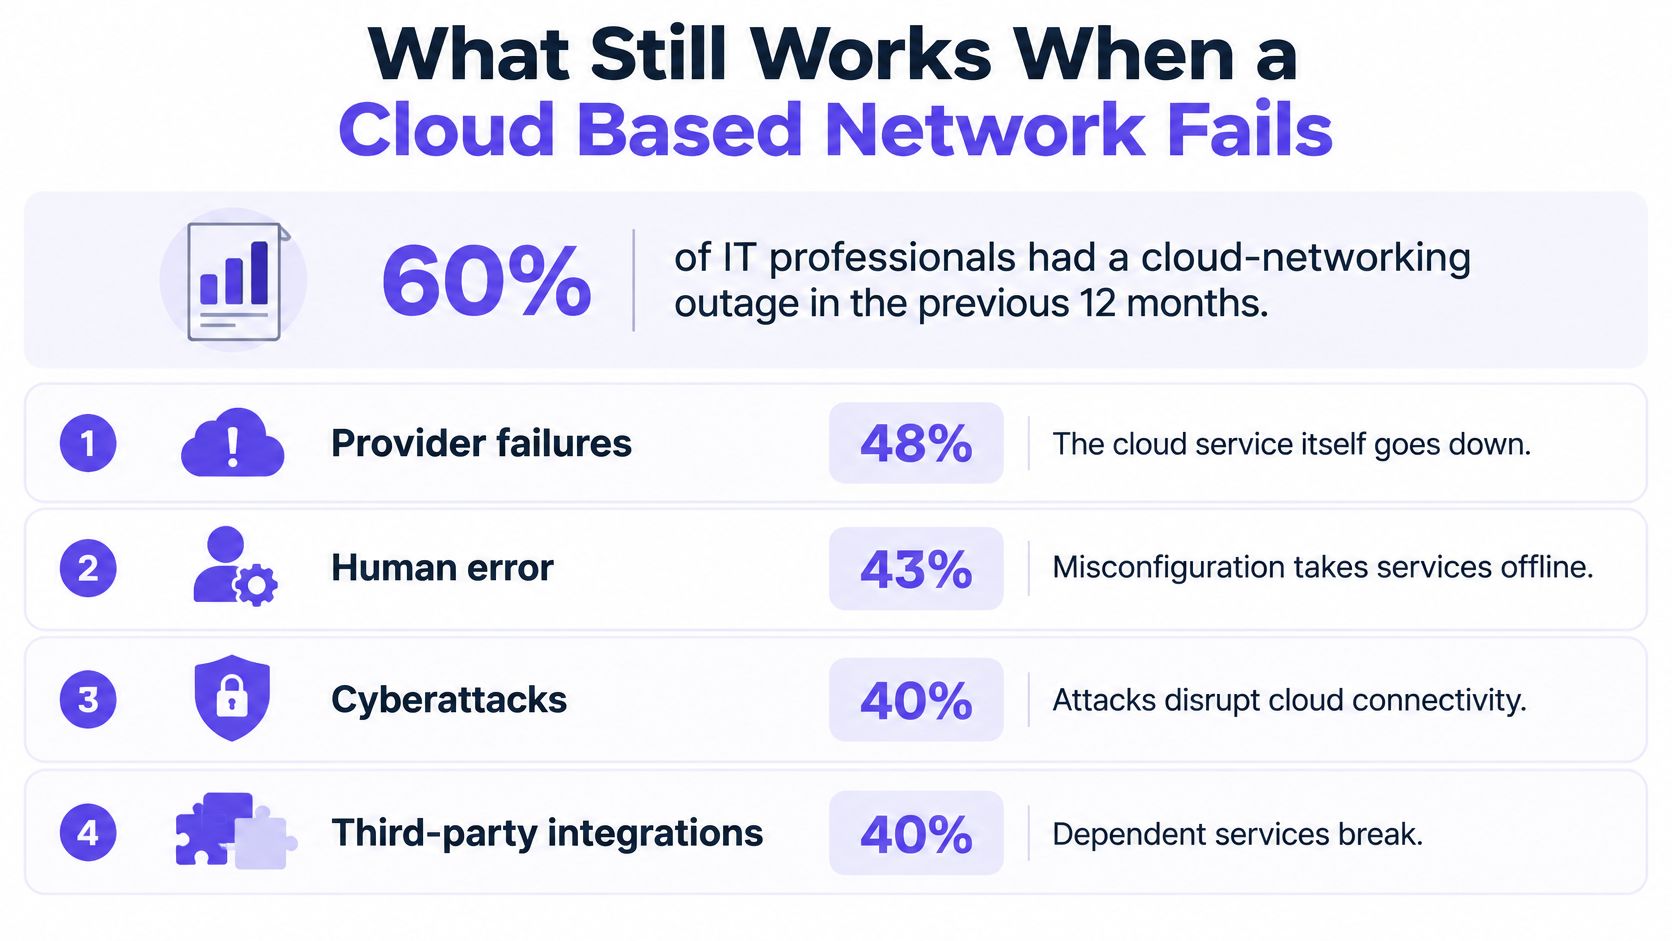
La cifra de tiempo de actividad de un proveedor describe su plataforma, no si su sede puede seguir aplicando políticas cuando dicha plataforma no está accesible. El panel de control es la sala de mandos; el equipamiento de la sede todavía tiene que cursar el tráfico y aplicar las reglas que ya había recibido.
Un SLA describe lo que promete el proveedor. No le dice qué harán sus puntos de acceso cuando el plano de control sea inaccesible.
Dos caídas que parecen iguales, pero no lo son
Si falla el plano de gestión, es posible que no pueda modificar directivas, consultar informes actualizados o incorporar una nueva sede. El tráfico y la aplicación de directivas existentes pueden continuar porque las reglas ya se habían transmitido al perímetro de la red.
Si falla la capa de aplicación, habitualmente el DNS o su ruta de resolución, los usuarios lo notan de inmediato. Es posible que algunas páginas dejen de resolverse o, por el contrario, que todo se resuelva debido a que el filtrado se ha omitido.
Esa es la disyuntiva entre fail-open y fail-closed. El modo fail-open restablece la conectividad mediante resolución recursiva ordinaria si el servicio en la nube no está disponible, pero las medidas de protección dejan de aplicarse. El modo fail-closed mantiene la política activa, pero un fallo de DNS también puede bloquear servicios legítimos, como los pagos con tarjeta o los sistemas de reservas, a menos que la red cuente con alternativas de contingencia probadas. Ninguno de los dos comportamientos se adapta a todos los recintos. Lo importante es saber cuál utiliza su red y qué experimentarán los usuarios (guía sobre filtrado fail-open frente a fail-closed).
Diseñe el plan de contingencia antes de necesitarlo
Configure más de un servidor de resolución y supervise si funcionan correctamente. Identifique los servicios que deben permanecer disponibles y pruebe una ruta alternativa para ellos. Si los invitados pierden el acceso a internet, configure el portal cautivo para que explique la interrupción en lugar de dejarlos con un icono de carga indefinido.
La gestión en la nube no elimina los equipos locales. Los puntos de acceso, los conmutadores y la conexión a internet de la ubicación siguen formando parte del servicio, y una caída de la conexión puede dejar al establecimiento sin servicio. La generación de informes también depende de los registros, del periodo de retención y de un formato que el personal pueda interpretar.
| Fallo | Qué sigue funcionando | Comportamiento de la directiva | Prueba previa a la puesta en marcha |
|---|---|---|---|
| Caída del plano de gestión en la nube | Tráfico existente y aplicación de directivas, si las reglas ya están implementadas | Por lo general, sin cambios | Corte el acceso de gestión y confirme que el tráfico sigue fluyendo |
| Caída del resolutor DNS | Caché local y resolutores secundarios, si están configurados | Permitir o bloquear por defecto (fail open / fail closed), según la configuración | Bloquee el resolutor primario y confirme que el secundario responde |
| Caída del enlace de Internet de la sede | Únicamente servicios locales | No aplicable | Desconecte el enlace WAN y confirme que aparece el mensaje de contingencia |
| Fallo del operador o del proveedor ascendente | Tráfico por una ruta alternativa, si existe | Sin cambios si una segunda ruta asume el tráfico | Simule la pérdida de conexión ascendente y compruebe la ruta de conmutación por error |
| Caída del proveedor de identidades | SSID abiertos o con clave precompartida | El acceso autenticado puede interrumpirse | Pruebe la contingencia de inicio de sesión para el personal y los invitados |
Tres pasos para demostrarlo
- Ejecute cada prueba en una sola ubicación. Hágalo durante el horario comercial, de modo que pueda observar la experiencia de los invitados y lo que registra la red.
- Registre el resultado. Anote qué siguió funcionando, si la directiva recurrió al modo «fail open» o «fail closed», la fecha y quién realizó la prueba.
- Repita el proceso tras modificar las directivas. Un nuevo conjunto de reglas puede alterar el comportamiento del sistema de respaldo.
Los costes de suscripción y la dependencia del enlace a internet influyen en lo que se puede implementar, pero no responden a qué ocurre durante una interrupción del servicio. Si solo puede realizar pruebas en una sede, empiece por aquella con más invitados o con el deber de protección más estricto.
Elija una configuración y haga una prueba piloto en una ubicación
Antes de comparar productos, decida para qué sirve su red. El orden importa más que la herramienta.
- Enumere cada sede y cada grupo que la utiliza. Invitados, personal, estudiantes, residentes, planes de pago. Anote la lista por escrito; la mayoría de los operadores descubren dos grupos que habían olvidado.
- Asigne a cada grupo su propio SSID o VLAN desde el primer día. Una red de personal que comparte un conjunto de reglas con una red de invitados es un incidente de seguridad y protección a punto de ocurrir. Durante la incorporación se debe asignar a cada red de clientes su propia directiva, de forma independiente para invitados, personal, estudiantes, residentes y planes de pago.
- Marque las pruebas de fallo que sean relevantes para usted. Pérdida del plano de gestión, conmutación por error de DNS, una WAN desconectada, pérdida de conexión ascendente y una caída del proveedor de identidades. Si una prueba no procede, indíquelo explícitamente en lugar de omitirla.
- Realice un piloto en una sola red y registre los resultados antes de cualquier despliegue más amplio. Una sede, una semana, una página de conclusiones.
Purple Shield se integra después de ese trabajo, no en lugar de él. Una capa de DNS filtra el contenido, frena las amenazas y elimina los anuncios en cada dispositivo de cada red, con una política por SSID, VLAN y ubicación, y un único panel de control. Puede probarlo gratis durante 30 días en una red o realizar un piloto en un único SSID planificado con nuestro equipo, y solo entonces recibir un presupuesto personalizado.
Por lo tanto, elija una ubicación esta semana. Registre sus grupos de usuarios, complete la tabla de fallos únicamente para esa ubicación y reserve el piloto una vez que sepa qué se supone que debe hacer su red cuando algo falle.
Purple Shield es una solución de filtrado de contenidos y DNS protector diseñada para recintos y redes WiFi públicas y de invitados, que funciona de forma independiente en cualquier red WiFi o junto con Purple Access, con una directiva independiente para cada SSID, VLAN y recinto, y con informes que muestran con exactitud qué se ha bloqueado. Se ejecuta en múltiples centros de datos y cuenta con bloqueo por fallo (fail-closed), de modo que un problema en el resolver no desactiva sus medidas de protección. Comience una prueba gratuita de 30 días en una red en Purple Shield y compruebe las pruebas de tolerancia a fallos antes de firmar nada.