
Analice el tráfico de red: capture, lea y solucione problemas
Aprenda a analizar el tráfico de red paso a paso: capture datos, cree una línea base, lea flujos cifrados y detecte problemas de seguridad o rendimiento.
Published 20 de noviembre de 2026
Son las 2:10 de un martes y la recepción ya ha llamado dos veces quejándose de la lentitud del WiFi. No se modificó nada durante la noche. Los puntos de acceso están activos, la gráfica de enlace ascendente se ve muy parecida a la de ayer y el proveedor indica que el circuito está limpio. Tiene unos veinte minutos antes de que alguien decida que el problema es responsabilidad del equipo de redes.
Para esos veinte minutos es para lo que sirve el análisis de tráfico. No para recopilar cada paquete, sino para demostrar rápidamente una serie de aspectos específicos: si el enlace está saturado, si un dispositivo funciona mal, si algo interno se comunica con un host con el que no debería, o si la queja en realidad se debe a la cobertura en un rincón del edificio.
El orden importa. Obtenga las métricas correctas, realice una captura que responda a una sola pregunta, cree una línea base con la que pueda comparar y mantenga registros que se sienta cómodo defendiendo.
Tabla de contenido
- Métricas de tráfico que debe monitorear y qué significan
- Cómo capturar el tráfico paso a paso
- Establecer una línea base para el tráfico normal
- Interpretar el tráfico cuando está cifrado
- Detección de problemas de seguridad y rendimiento
- Conservar evidencias sin recopilar datos en exceso
- Elija su primera configuración de monitoreo
Métricas de tráfico para monitorear y qué significan
Un WiFi lento a las 2:00 p. m. rara vez significa que la red se haya caído. Por lo general, significa una de tres cosas: la demanda alcanzó un pico, un solo dispositivo comenzó a hacer algo inusual o un host en la red comenzó a comunicarse con un destino no debido. Puede distinguir esas posibilidades con un puñado de métricas que probablemente ya recopila.
La cantidad y diversidad de dispositivos hace que esto sea más difícil que antes. El pronóstico de 2017 a 2022 de Cisco proyectó que el tráfico fijo y de WiFi alcanzaría el 51% del tráfico IP total para 2022, frente al 43% en 2017, y que los dispositivos que no son computadoras generarían el 81% del tráfico IP global (pronóstico de conexiones globales de Cisco). Teléfonos, smart TVs, terminales de cobro y controladores de edificios ahora concentran la mayor parte del volumen, y ninguno de ellos aparece en un registro de activos.
| Métrica | Lo que revela | Señal de advertencia |
|---|---|---|
| Utilización del enlace | Qué tan saturado está un enlace a lo largo del tiempo | Sostenida por encima del 70-80% de la capacidad |
| Principales emisores (top talkers) | Hosts o SSIDs que consumen el mayor volumen | Un solo dispositivo utilizando una proporción desmesurada |
| Combinación de protocolos y puertos | Si el tráfico coincide con los servicios esperados | Puertos o protocolos inesperados a gran escala |
| Volumen de consultas DNS | Actividad de resolución por host | Picos repentinos o consultas repetidas a un mismo dominio |
| Proporción de NXDOMAIN | Errores en la resolución de nombres | Proporción en aumento, a menudo debido a malware o mala configuración |
| Nuevas conexiones por minuto | Tasa de creación de sesiones | Aumento drástico que sugiere escaneo o inundación (flooding) |
| Retransmisiones | Paquetes perdidos o repetidos | Por encima del 1-2% de los paquetes |
| Latencia y fluctuación (jitter) | Retraso y cuánto varía | Fluctuación que interrumpe llamadas de voz o video |
Interprete esa lista como un orden de triaje, no como una tarjeta de puntuación. A las 2:00 p. m., comience con la utilización del enlace durante esa hora y compárela con la misma hora en semanas habituales. Si la utilización se encuentra en su pico habitual y las retransmisiones son normales, la causa es la capacidad, y la solución es la programación, la modelación del tráfico (traffic shaping) o un mayor ancho de banda, en lugar de buscar malware.
Si la utilización es normal y un dispositivo domina a los principales emisores, ese dispositivo es su siguiente punto a revisar, no el enlace ascendente. Si las retransmisiones aumentan mientras la utilización se mantiene estable, deje de analizar el tráfico y comience a inspeccionar la infraestructura: un cable defectuoso, una discrepancia de dúplex o un punto de acceso que lidia con interferencias en un canal congestionado.
La regla definitiva: una sola lectura no demuestra nada. Un valor solo tiene sentido en comparación con el rango habitual del mismo sitio a la misma hora.
Cómo capturar tráfico paso a paso
El objetivo es una muestra representativa, no una copia de la red. Veinte minutos tomados en el momento adecuado superan a una semana de archivos que nadie abre, y su tamaño se mantiene lo bastante pequeño como para entregárselo a un colega.
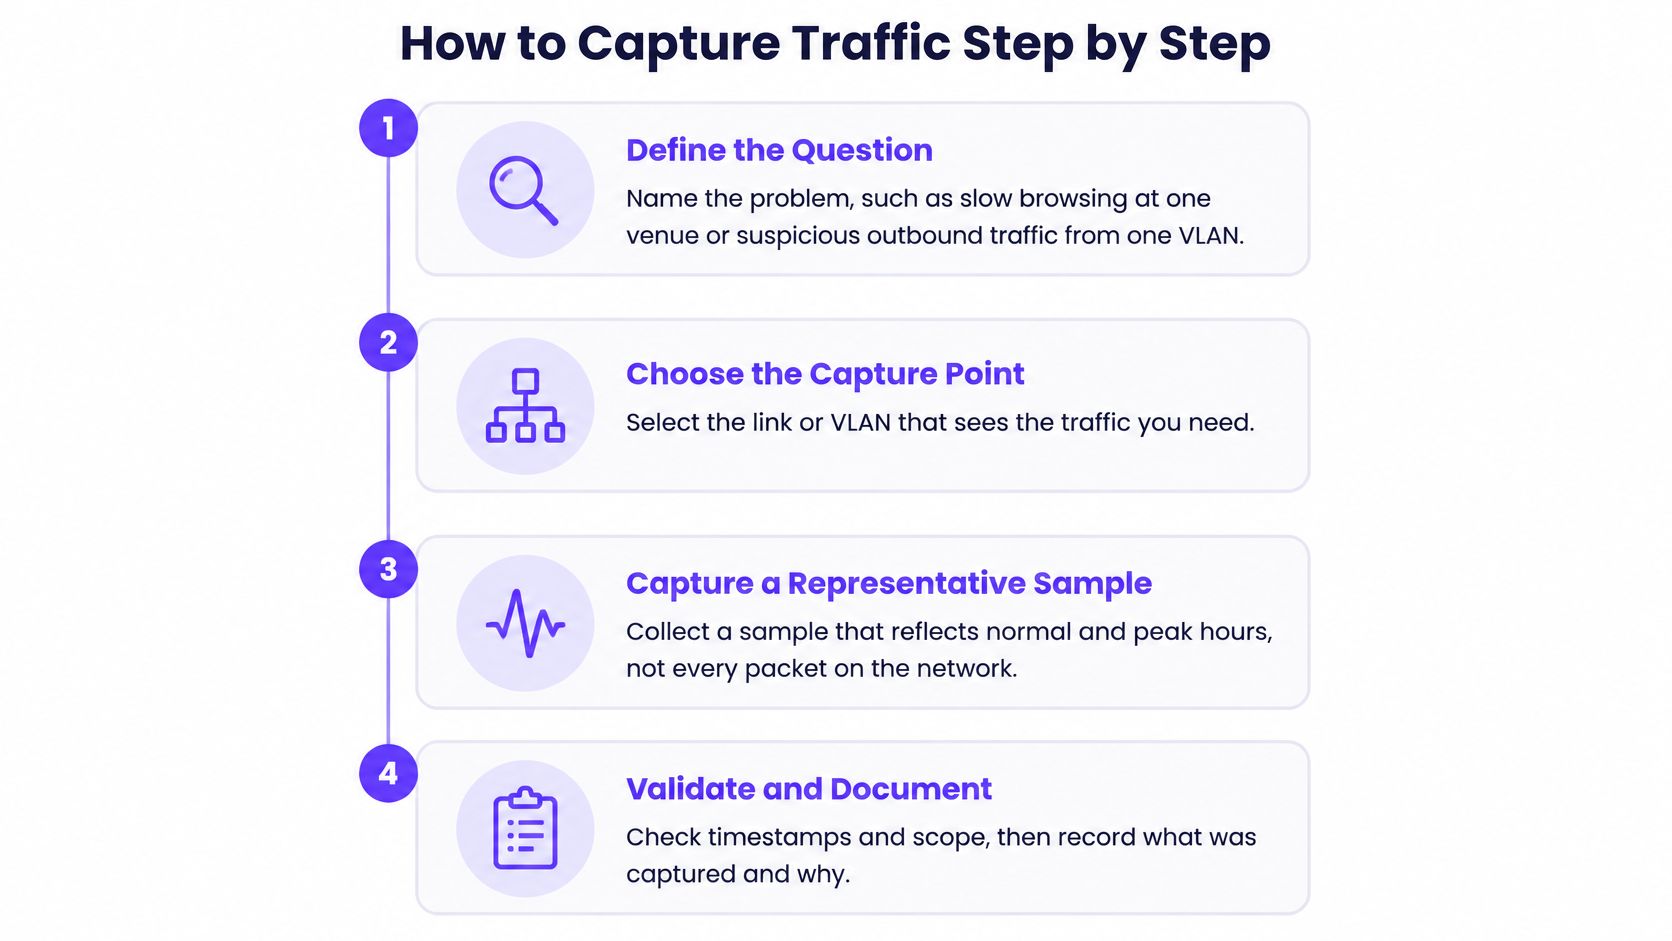
Defina la pregunta. "Navegación lenta en la red de invitados SSID en una ubicación" y "tráfico saliente inesperado desde la red de pagos VLAN" requieren distintos puntos de captura, filtros y duraciones. Escriba la pregunta antes de iniciar sesión en un switch. El error común es capturar primero y esperar a que la pregunta aparezca en el archivo.
Elija un punto que vea ambas direcciones. Un puerto SPAN en el switch, un TAP en línea en el enlace ascendente (uplink) o la exportación de flujos desde el router o firewall. La exportación de flujos es la forma más económica de monitorear un sitio continuamente, y la captura de paquetes es el recurso al que recurre cuando los flujos muestran algo inusual. Replicar un puerto que solo transmite en una dirección le da la mitad de una conversación y un recuento de retransmisiones que no significa nada.
Filtre antes de grabar. Delimite la captura a una sola subred, VLAN o host. Eso mantiene el archivo lo suficientemente pequeño como para abrirse en segundos y evita que recopile tráfico del personal y de los invitados que no forman parte del problema.
Capture una ventana fija. De quince a treinta minutos durante la hora pico, y luego una captura más corta durante un período tranquilo. La combinación permite hacer comparaciones más adelante; una sola captura es solo una anécdota.
Incluya el sitio, la fecha y la hora en el nombre del archivo. Esto parece trivial hasta que tiene cuarenta capturas y no puede identificar qué ubicación llamó.
Analice con filtros de visualización, no desplazándose por la pantalla. Comience con la jerarquía de protocolos (Protocol Hierarchy) y las conversaciones (Conversations) para ver qué está presente, y luego enfóquese en retransmisiones o búsquedas de nombres. Desplazarse manualmente por una captura con mucho tráfico es la forma en que muchos concluyen erróneamente que no pasa nada.
Registre el contexto junto con el archivo. Punto de captura, filtro, tiempos, lo que reportaron los usuarios y lo que ya descartó.
Un hábito hace que los datos sean útiles más adelante. Normalice los flujos por interfaz, SSID o VLAN, sitio, ventana de tiempo y dirección, y tome en cuenta NAT, enrutamiento asimétrico, túneles y dispositivos compartidos antes de establecer cualquier umbral (guía de Vectra para el análisis de tráfico cifrado). El contexto de la red no es ruido alrededor del análisis, es parte de él.
Si desea tener toda la rutina en una sola página para el equipo, esta es la secuencia:
| Punto de captura | Ideal para | Desventaja |
|---|---|---|
| Puerto SPAN o espejo | Captura de paquetes de un solo puerto o VLAN | Solo observa el tráfico duplicado y puede perder una de las direcciones |
| TAP de red | Captura completa de paquetes en un solo enlace | Hardware dedicado; captura ambas direcciones de forma confiable |
| Exportación de flujo (NetFlow, sFlow, IPFIX) | Monitoreo a largo plazo desde router o firewall | La más económica; conserva resúmenes de flujos, no paquetes |
Creación de una línea base para el tráfico normal
Un número se convierte en señal solo cuando usted sabe cuál suele ser ese número. Las líneas base se omiten porque son tediosas, y el costo llega más tarde en forma de una cola de alertas que todos silencian.
Monitorear los totales en tiempo real es la parte fácil. Saber qué totales son incorrectos para esta hora en este sitio es la otra mitad.
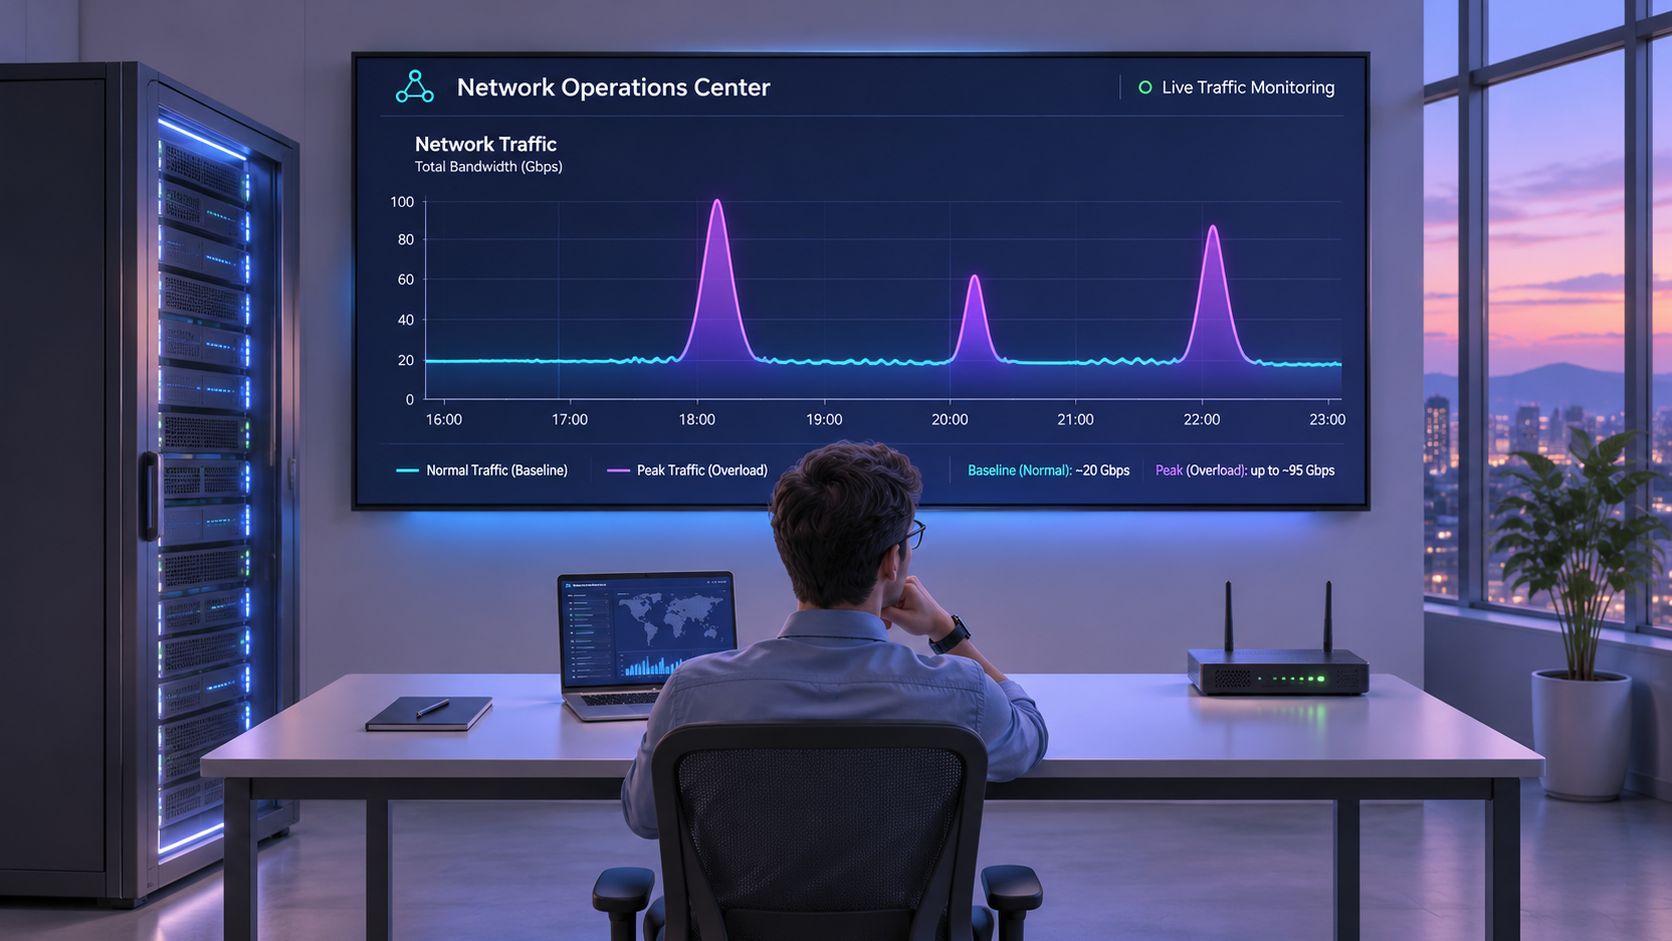
El crecimiento hace que cualquier línea base pierda vigencia. La previsión de Cisco proyectó que el tráfico IP mundial pasaría de 122.4 exabytes al mes en 2017 a 396.0 exabytes al mes en 2022, una tasa de crecimiento anual compuesto del 26%, y situó el tráfico en horas pico en cerca de 7.2 petabits por segundo frente a un promedio cercano a 1 petabit por segundo (Global IP Traffic Forecast de Cisco). La diferencia entre el promedio y los picos es lo que satura los enlaces.
El incremento no se ha estabilizado. Cloudflare Radar registró un crecimiento del 17.2 % en el tráfico global de Internet durante 2024 (balance de Cloudflare Radar de 2024), lo cual es suficiente para que una línea base de hace dos años describa una red que ya no existe.
Qué registrar cada hora
- Volumen por SSID y VLAN, no solo por enlace ascendente, ya que un enlace ascendente plano oculta el segmento que experimentó crecimiento.
- Tasa de consultas DNS y porcentaje de NXDOMAIN, calculados por cada mil búsquedas para que la proporción no pierda relevancia ante el incremento del tráfico.
- Destinos principales y nuevas conexiones por minuto, registrados respecto a la hora de la semana en lugar del día.
- Contexto del calendario, para que los periodos escolares, noches de eventos y patrones de hotel de fin de semana sean identificados correctamente en lugar de tratarse como anomalías.
Constrúyala a lo largo de al menos dos semanas, cubriendo el comportamiento en días laborales y fines de semana, así como las horas pico y de baja actividad. Establezca umbrales por hora de la semana, para que un pico de viernes por la noche en un hotel no genere un incidente cada siete días.
Vale la pena investigar tres días consecutivos fuera del rango para la misma hora. Un valor atípico aislado suele ser la transmisión de un partido, el despliegue de software o la conferencia magistral de un evento, y debe registrarse en las notas en lugar de escalarse.
Cómo interpretar el tráfico cuando está cifrado
TLS 1.3, QUIC sobre UDP/443, HTTP/3, las VPN y el DNS cifrado han dejado la mayoría de las cargas útiles fuera del alcance. Cualquier plan basado en leer el contenido de la página es ahora un plan para decepcionar a quien lo solicitó.
El panel sigue siendo útil. Responde a preguntas diferentes a las que solía responder.
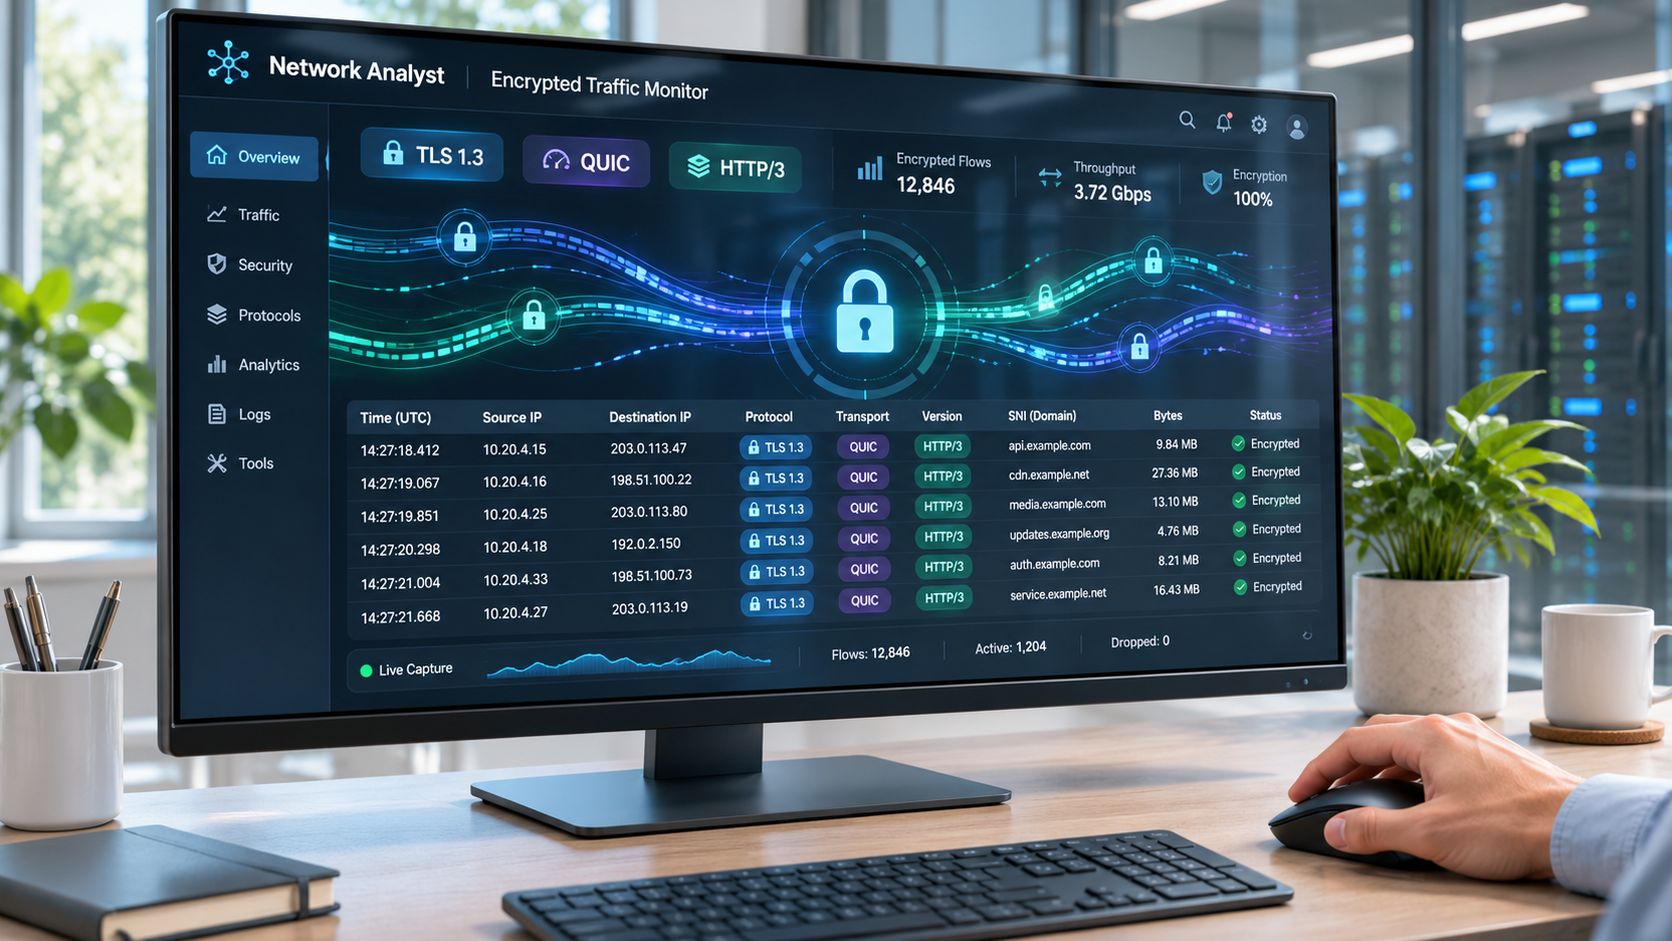
Los metadatos revelan más de lo que parece. Investigadores que entrenaron un modelo con 500 sitios habilitados para QUIC identificaron el 70% de los sitios web monitoreados con una precisión del 90% usando únicamente paquetes DNS, cifra que aumentó a cerca del 80% de exhaustividad (recall) con una precisión del 90% cuando se combinó DNS-over-QUIC con tráfico HTTP/3 (investigación de A*STAR sobre tráfico cifrado). El tamaño, los tiempos y la dirección de los paquetes todavía transmiten muchísima información.
Lo que esto respalda es la detección de anomalías, la clasificación de aplicaciones y la priorización de amenazas. Lo que no respalda es afirmar qué leyó, escribió o pretendía hacer una persona. Deje clara esa distinción antes de prometer a un gerente un informe sobre el contenido de navegación.
Para ver una guía práctica sobre cuánto sobrevive al cifrado en una captura real:
La evaluación es donde suele fallar el trabajo con tráfico cifrado. Divida los datos de entrenamiento y prueba por flujo completo, no por paquete, ya que la división por paquetes filtra datos de sesión casi idénticos en ambos conjuntos; una evaluación reciente cayó a apenas un 40% de precisión una vez que se aplicó la separación a nivel de flujo (evaluación de clasificación de tráfico cifrado en arXiv).
Los registros de resolución solo son tan confiables como el punto donde finaliza el DNS. Si parte de su infraestructura se conecta a resolutores DNS cifrados y endpoints DoH que usted no controla, documente esa brecha en lugar de asumir una visibilidad que no tiene.
Identificación de problemas de seguridad y rendimiento
Un host que envía señales a un dominio de comando y control y un host que satura un enlace se ven similares desde un panel de control. Ambos generan tráfico. Requieren comprobaciones iniciales distintas, y una suposición errónea puede desperdiciar la primera hora.
Las amenazas en una red son lo suficientemente comunes como para planificar en función de ellas. Akamai reportó en 2023 que entre el 10% y el 16% de las organizaciones detectaron tráfico de comando y control en sus redes en cualquier trimestre dado (investigación de Akamai sobre tráfico malicioso de DNS). El tráfico de balizamiento (beaconing) está diseñado para parecerse a la navegación ordinaria, por lo que se descubre por patrones y no por volumen.
| Síntoma | Causa probable | Primera comprobación |
|---|---|---|
| Navegación lenta en horas pico | Saturación del enlace | Utilización por hora frente a la línea base |
| Conexiones periódicas pequeñas a un dominio desconocido | Balizamiento (beaconing) de comando y control | Intervalo de conexión e historial de DNS para el host |
| Carga grande de datos desde un host por la noche | Exfiltración o respaldo no programado | Volumen saliente normal del host |
| Pico en respuestas NXDOMAIN | Búsquedas de malware o fallo en el servidor de resolución | Dominios más consultados y registros del servidor de resolución |
| Aumento de retransmisiones con utilización normal | Cable defectuoso o interferencia de WiFi | Contadores de errores y pérdida por punto de acceso (AP) |
| Búsquedas repetidas de un dominio por parte de muchos hosts | Aplicación comprometida o dispositivo mal configurado | Hosts de origen y reputación del destino |
Cómo se ve el beaconing en un registro de flujo
Un dispositivo que se comunica con un dominio a intervalos constantes, con tamaños de solicitud y respuesta pequeños y uniformes, no se parece en nada al patrón diurno de ese mismo host. Extraiga los intervalos de conexión y el historial de DNS de ese host antes de bloquear cualquier cosa. Una Smart TV que busca actualizaciones de firmware en un horario fijo imitará el mismo comportamiento y le hará perder un día de su semana.
Las cargas masivas durante la noche requieren contexto en lugar de alarmismo. Compare el volumen de salida del host con su propio comportamiento normal y, a continuación, verifique si se cambió la ventana de respaldo o si se instaló un nuevo cliente de sincronización en la nube. La pregunta útil es si la transferencia es inusual para ese host, no si es grande en términos absolutos.
Revise la lista de bloqueo y las fuentes de amenazas antes de culpar a la red. Registre el hallazgo con marca de tiempo, host y destino para que la siguiente persona pueda verificarlo en lugar de repetir el proceso. Esa evidencia es también lo que le permite demostrar qué fue lo que se detuvo, en lugar de discutir a partir de una alerta imprecisa.
Cuando el síntoma resulta ser congestión en lugar de un compromiso de seguridad, los mecanismos cambian. El bloqueo de anuncios y rastreadores a nivel de DNS puede reducir el tráfico web entre un 20% y un 40% y acelerar la carga de páginas, sin necesidad de realizar cambios en los dispositivos (Reducción del uso de ancho de banda). Esa es una primera comprobación práctica porque reduce la demanda sin modificar la configuración del cliente, mientras que la utilización por hora sigue mostrando si la línea base en sí ha cambiado.
Cómo conservar evidencias sin recopilar datos en exceso
Más datos de paquetes no garantizan automáticamente una mayor seguridad. Las capturas completas incrementan el costo de almacenamiento, la exposición de la privacidad y la carga de trabajo de los analistas, y aun así no pueden leer una carga útil cifrada. La pregunta que vale la pena plantear sobre cada registro es más puntual: ¿aporta esto a la contención, la protección, una auditoría o la resolución de problemas?
La visibilidad suele esfumarse con facilidad. Cuando el DNS no termina en servidores controlados por la empresa, las organizaciones pierden visibilidad sobre las consultas y generan puntos ciegos ante actividades de exfiltración y denegación de servicio (análisis de infraestructura DNS de EfficientIP). Esto demuestra la importancia de mantener la evidencia del resolvedor bajo su propio control, no de capturar absolutamente todo.
El conjunto mínimo defendible:
- Marca de tiempo y red o SSID, de modo que cada registro se vincule a una ubicación y a una política.
- Categoría de la política y acción tomada, incluidos los bloqueos y la explicación mostrada al usuario.
- Dominio consultado, clasificación de amenazas y estado del sistema, lo cual suele ser suficiente para reconstruir lo sucedido.
- No URLs completas, cargas útiles (payloads) ni historiales de navegación, a menos que exista una base legal clara y un período de retención definido.
La retención es una decisión, no un valor predeterminado. Conserve registros resumidos de flujo y de DNS durante un período establecido, mantenga las capturas completas únicamente mientras un incidente esté activo y elimínelas cuando el caso se cierre.
Antes de que comience la recopilación: quién puede leer los registros, cuánto tiempo se conservan y qué se les informó a los usuarios. Si no puede responder a las tres preguntas, tiene un hábito de almacenamiento en lugar de una política de gobernanza.
Donde el DNS también realiza el filtrado, la capa de informes aporta la mayor parte de las pruebas. Vale la pena leer una guía sobre registros e informes de filtrado de DNS antes de diseñar el formato de los registros, ya que adaptar categorías y motivos de directivas a los registros a posteriori resulta problemático.
Elija su primera configuración de monitoreo
El punto de partida depende de lo que esté protegiendo, y las redes públicas se están convirtiendo en la norma y no en la excepción. La Wireless Broadband Alliance reportó en 2025 que el 46% de los encuestados planeaba implementar WiFi pública para toda la ciudad en 2025 o 2026, mientras que el 15% ya había implementado una red de este tipo (informe de la industria WBA 2025).
Para una oficina pequeña, comience con la exportación de flujos desde el router, registros de DNS y una línea base de dos semanas; luego, cree un panel que muestre el uso del enlace, los principales generadores de tráfico y la proporción de NXDOMAIN. Esa única vista responde a la mayoría de las quejas entre semana sin necesidad de abrir un archivo de captura.
Para un recinto o campus multisitio, agregue vistas por SSID y por VLAN, umbrales de ventanas de tiempo y un registro en la capa DNS que documente cada dominio bloqueado junto con la política que actuó sobre él. El trabajo adicional radica en la normalización, no en las herramientas.
Para redes públicas o WiFi para invitados WiFi, mantenga la misma política y registro por SSID, e informe con claridad a los usuarios qué se registra y por cuánto tiempo. La divulgación no cuesta nada y desactiva la mayoría de las quejas antes de que lleguen a un gerente.
La captura de paquetes sigue siendo una herramienta para incidentes activos, no una fuente permanente de datos. Evalúe la configuración según la rapidez con la que responda a una pregunta: ¿este período de lentitud se debe a la capacidad, a una falla del dispositivo o a una amenaza?
Purple Shield se ejecuta como DNS de protección en cualquier red WiFi o en redes de acceso Purple, con una política para cada una, y es posible proteger una red de forma gratuita durante 30 días.
Elija una red esta semana, capture su hora pico, compárela con la misma hora en la línea base y anote el primer hallazgo con su marca de tiempo, host y destino. Ese único documento vale más que otro panel de control.
Purple Shield responde a cada búsqueda de DNS en las redes que protege, de modo que se verifica un dominio antes de abrir una conexión, y el panel muestra qué se bloqueó, qué amenazas se detuvieron y cómo se utilizó la red en diferentes ubicaciones y SSID. Si prefiere comprobar lo ocurrido a partir de la evidencia de las búsquedas en vez de ejecutar capturas de paquetes de forma continua, comience con la prueba gratuita para una red. Visite Purple Shield para conocer cómo se verían las políticas y los informes por SSID en sus instalaciones.