
Leitfaden zu cloudbasierten Netzwerken: Architektur und Vorteile
Erfahren Sie, was ein cloudbasiertes Netzwerk ist, wie seine Architektur funktioniert und wie Sie standortübergreifendes WiFi mit weniger Geräten vor Ort sichern und verwalten.
Published 19. November 2026
Ein Gast fragt an einem Ihrer Standorte nach dem WiFi-Passwort. Sie geben es heraus. Irgendwo in einem Hinterzimmer gibt ein in die Jahre gekommener Router sein Bestes mit den Firewall-Regeln, die 2019 eingerichtet wurden, und niemand im Unternehmen kann diese Regeln aus dem Gedächtnis aufzählen.
Dieses Szenario wiederholt sich an drei oder zwölf Standorten, und der operative Aufwand steigt exponentiell: ein separater Administrator-Login für jedes Gerät, Richtlinien, die an einem Standort gelten, am anderen jedoch nicht, und eine starre Hardwareausstattung, die im Winter ungenutzt bleibt und im Sommer überlastet ist. Ein cloudbasiertes Netzwerk ist die Lösung der meisten Betreiber. Genau hier stellen sich jedoch die entscheidenden Fragen, denn die Verlagerung der Steuerung in die Cloud verändert, welche Funktionen bei Teilausfällen weiterhin verfügbar bleiben.
Inhaltsverzeichnis
- Was ein Cloud-basiertes Netzwerk ist und wie es sich unterscheidet
- Wie die Schichten eines Cloud-basierten Netzwerks ineinandergreifen
- Vorteile, Kosten und wo der Wandel stattfindet
- Verkehrsabsicherung auf DNS-Ebene
- Was bei einem Ausfall eines Cloud-basierten Netzwerks weiterhin funktioniert
- Wählen Sie ein Setup und starten Sie ein Pilotprojekt an einem Standort
Was ein cloudbasiertes Netzwerk ist und wie es sich unterscheidet
Stellen Sie sich eine Café-Kette mit drei Standorten vor. Jeder Standort nutzt einen eigenen Router, eine eigene Firewall und eigene Administrator-Anmeldedaten - und jeder wurde an einem anderen Nachmittag von demjenigen konfiguriert, der gerade Zeit hatte. Die Regel zur Sperrung jugendgefährdender Inhalte existiert an zwei Standorten. Niemand hat sie auf den dritten übertragen, und niemand weiß mehr, wann dies geschah.
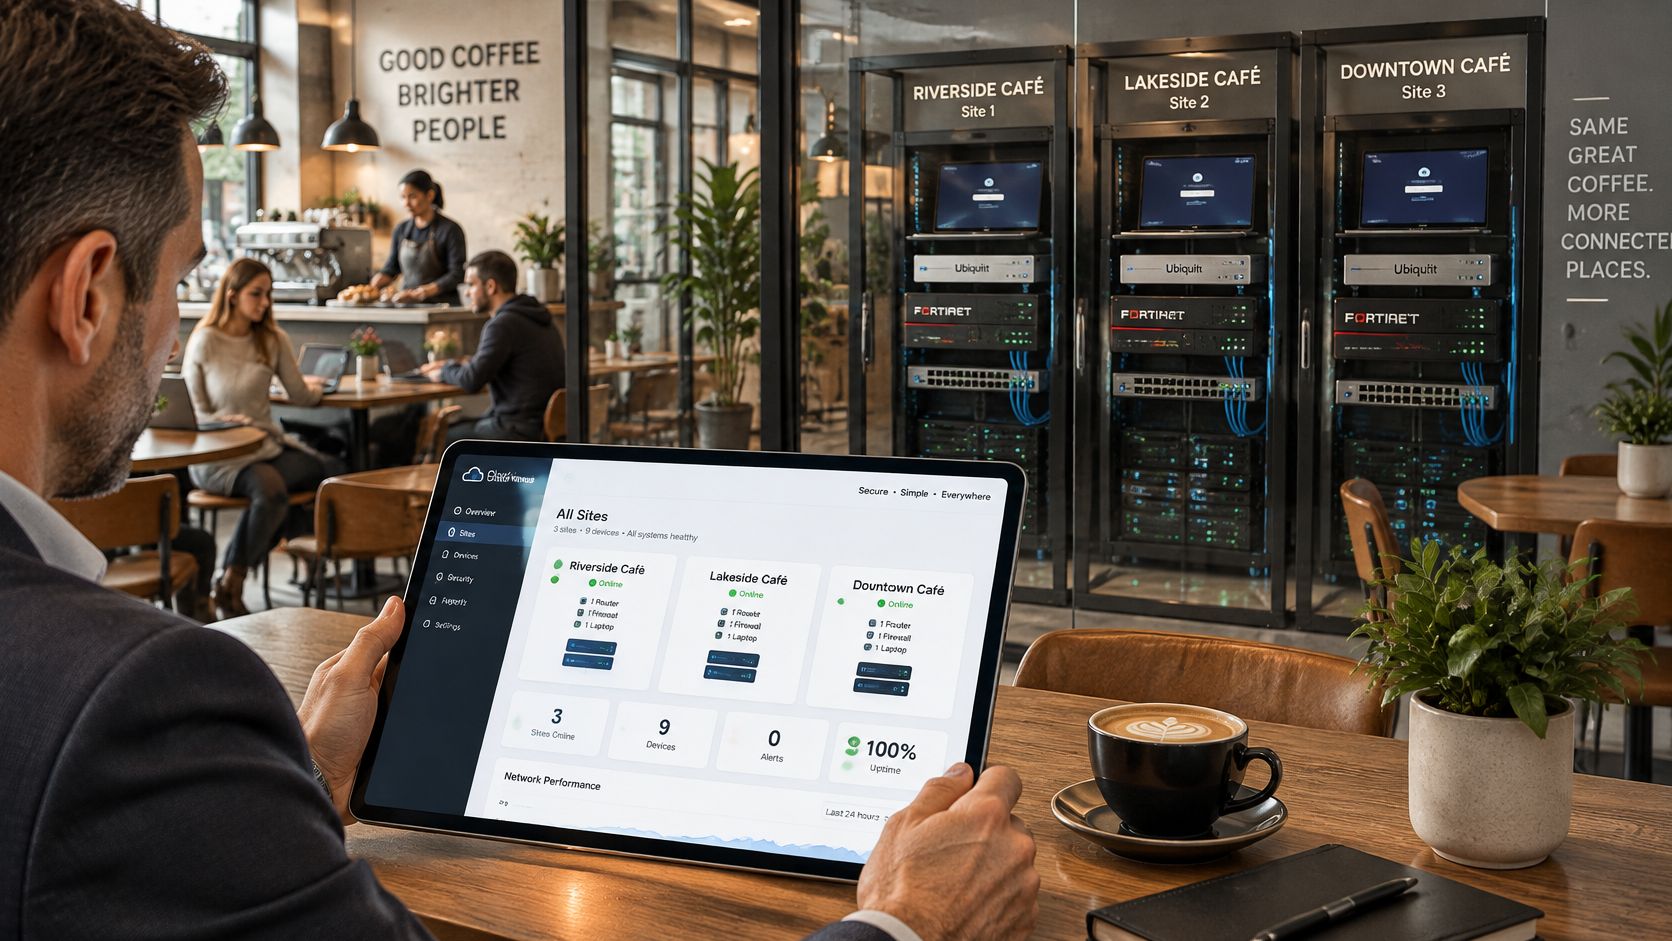
Ein cloudbasiertes Netzwerk verlagert die zentrale Verwaltung weg vom lokalen Standort. Richtlinien, Monitoring, Reporting und Konfiguration laufen auf einer vom Anbieter betriebenen Plattform. Die Hardware vor Ort wird deutlich vereinfacht: Access Points, ein Switch und ein schlanker Konnektor, der mit der Plattform kommuniziert. Sie melden sich einmal an, überblicken jeden Standort und ändern Regeln für alle Standorte gleichzeitig.
Das U.S. National Institute of Standards and Technology veröffentlichte 2011 die Definition, nach der die Branche größtenteils immer noch arbeitet. Sie beschreibt Cloud Computing als bedarfsgerechten Zugriff auf einen gemeinsamen Pool konfigurierbarer Ressourcen, die mit minimalem Verwaltungsaufwand bereitgestellt und freigegeben werden können (NIST). Die fünf Merkmale lassen sich nahtlos auf Veranstaltungsorte übertragen. Ressourcen-Pooling erklärt, warum Sie die Infrastruktur mit anderen Kunden teilen, anstatt sie zu besitzen. Schnelle Elastizität erklärt, warum ein Standort an der Küste im August ohne Hardware-Bestellung mehr Kapazität bereitstellen kann. Gemessener Service erklärt das Dashboard und den monatlichen Bericht.
Wenn Sie abwägen, wie viel Sie auslagern und wie viel Sie intern behalten möchten, erläutert der Leitfaden für Managed-Cloud-Services von CEFCore, was ein Managed-Modell in der Praxis abdeckt.
Die Unterschiede, auf die es für einen standortübergreifenden Betreiber ankommt, lassen sich auf eine Handvoll praktischer Fragen reduzieren.
| Aspekt | Traditionelles Netzwerk | Cloud-basiertes Netzwerk |
|---|---|---|
| Standort der Richtlinien | Hardware vor Ort an jedem Standort | Zentrale Cloud-Plattform, angewendet pro Standort |
| Hinzufügen eines neuen Standorts | Hardware vor Ort kaufen, versenden und konfigurieren | Den Standort einbinden und bestehende Richtlinien anwenden |
| Verwaltung | Lokales Admin-Login pro Gerät | Ein einziges Dashboard für alle Standorte |
| Kapazitätsskalierung | Hardware-Upgrade oder -Austausch | Anbieter fügt Kapazität nach Bedarf hinzu |
| Ausfallabhängigkeit | Lokale Geräte und die lokale Anbindung | Internetpfad plus die Steuerungsebene des Anbieters |
Praktische Faustregel: Wenn eine Änderung an einem Standort an jedem anderen Standort manuell wiederholt werden muss, betreiben Sie ein traditionelles Netzwerk mit einer modernen Anmeldeseite.
Wie die Schichten eines Cloud-basierten Netzwerks ineinandergreifen
Stellen Sie sich ein dreistöckiges Gebäude vor. Die oberste Etage ist die Verwaltung: Dies ist die Cloud-Control-Plane, in der Richtlinien, Benutzergruppen und Berichte definiert werden. Dort arbeiten die Mitarbeiter, aber Gäste haben keinen Zutritt. Die Control Plane bestimmt, was geschehen soll. Sie leitet den Datenverkehr der Gäste nicht selbst weiter.
Die mittlere Ebene ist der Korridor, die Data Plane. Hier fließt der Datenverkehr über Access Points, Switches und lokale Breakouts an jedem Standort. Hier legen Sie auch fest, welche Geräte miteinander kommunizieren dürfen. Die Netzwerksegmentierung sorgt dafür, dass Gast-Smartphones von Zahlungsterminals und Terminals von Backoffice-Systemen getrennt bleiben.
Die unterste Ebene ist die lokale Zugriffsschicht: die Tür, durch die jedes Gerät hereinkommt.
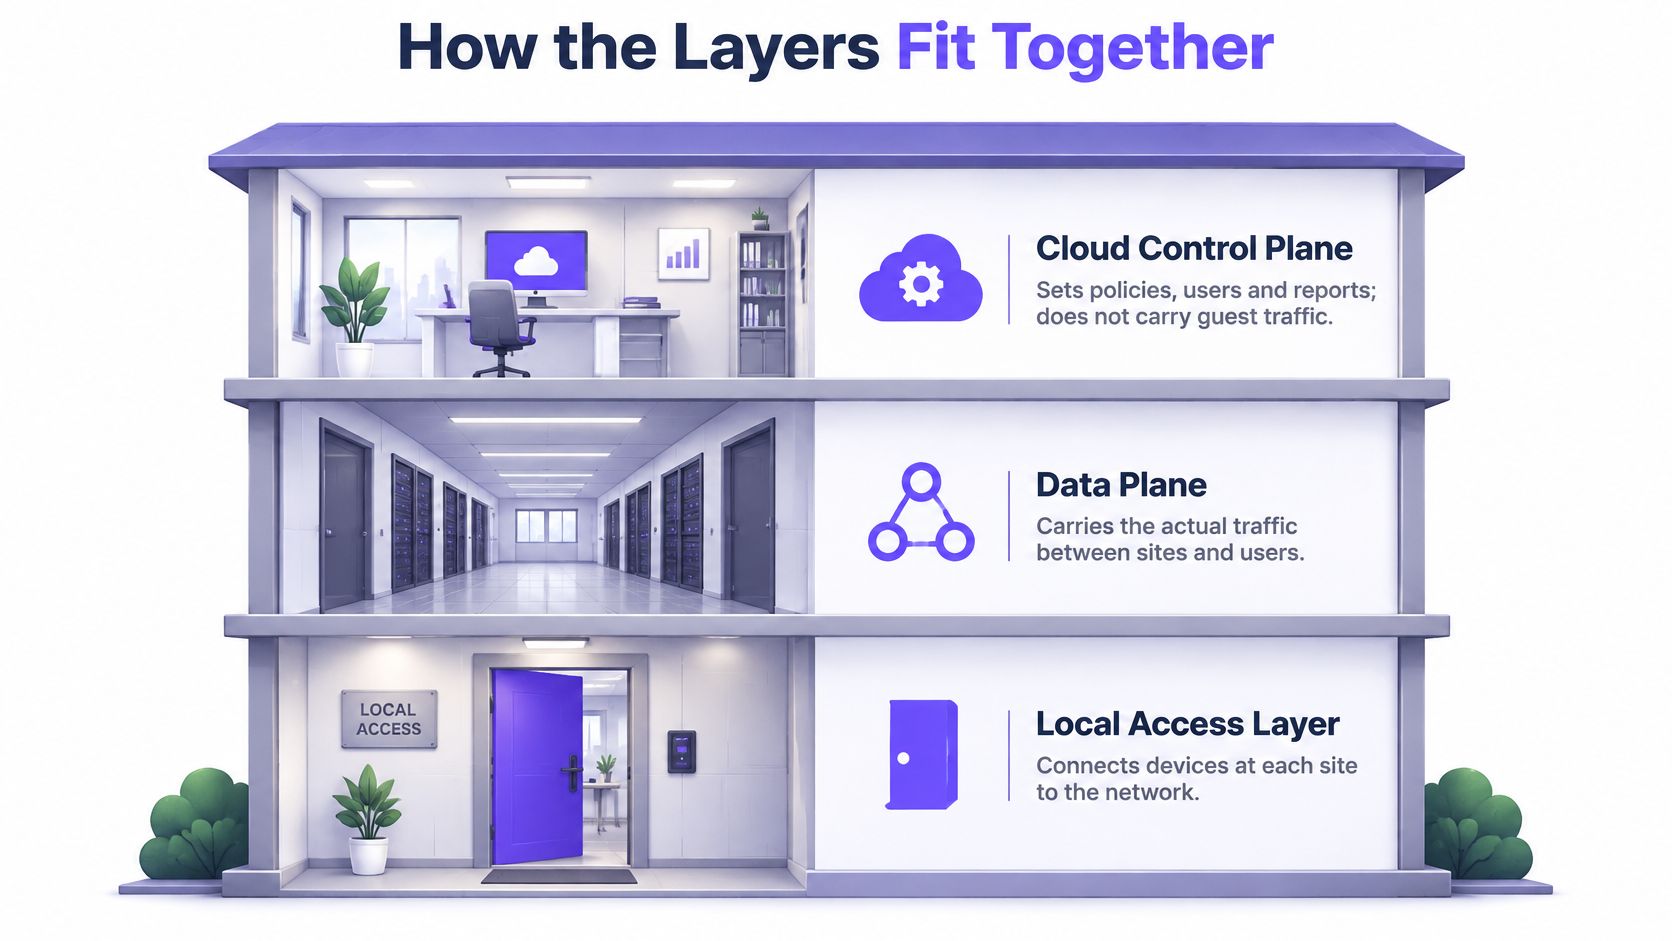
Zwischen dem Büro und dem Korridor befindet sich der Kontrollpunkt, den jede Verbindung zuerst passiert: die DNS-Schicht. Nichts gelangt in den Korridor, ohne dass ein Name aufgelöst wurde.
Eine Gästeverbindung, Schritt für Schritt
- Das Gerät verbindet sich mit dem SSID und der lokale Access Point akzeptiert es. Dies geschieht vor Ort, nicht in der Cloud.
- Das Gerät erhält eine IP-Adresse über DHCP. Die Adresse wird zuerst zugewiesen, noch vor jedem Surfvorgang.
- Das Gerät fragt einen Namen an, und diese Abfrage geht an den Cloud-Resolver statt an das, was im Router fest hinterlegt ist.
- Der Resolver antwortet mit „Zulassen“ oder „Blockieren“ innerhalb von Millisekunden, basierend auf der für diese SSID festgelegten Richtlinie.
- Erst dann wird die Verbindung aufgebaut, sei es eine Webseite, eine App oder ein Hintergrundabgleich.
Die drei Ebenen bilden somit eine Hierarchie. Richtlinien werden ganz oben definiert, die Durchsetzung erfolgt am DNS-Kontrollpunkt und die Weiterleitung findet im Korridor statt. Dieselbe Architektur findet sich auch weit außerhalb von WiFi wieder - weshalb IoT-Konnektivität für Verkaufsautomaten auf eine Cloud-Steuerungsebene mit lokalem Verhalten setzt, das auch einen Verbindungsausfall übersteht.
Ein Ausfall der Verwaltungsebene ist nicht dasselbe wie ein Ausfall der Weiterleitungsebene. Fällt das Büro aus, können Sie keine Änderungen vornehmen, aber der Datenverkehr im Korridor fließt weiter. Fällt der Korridor aus, hilft dem Gast vor Ort auch das beste Dashboard der Welt nicht weiter.
Vorteile, Kosten und wo der Wandel stattfindet
Der Wandel spiegelt sich zuerst in den Ausgaben wider. Gartner prognostizierte die weltweiten Endnutzerausgaben für Public-Cloud-Dienste auf 675,4 Milliarden US-Dollar im Jahr 2024, verglichen mit 561 Milliarden US-Dollar im Jahr 2023 - ein Anstieg um 20,4 %. Für Infrastructure as a Service, die Kategorie, die virtualisierten Netzwerkkapazitäten am nächsten kommt, wurde ein Wachstum von 25,6 % auf 180,0 Milliarden US-Dollar prognostiziert (Gartner).
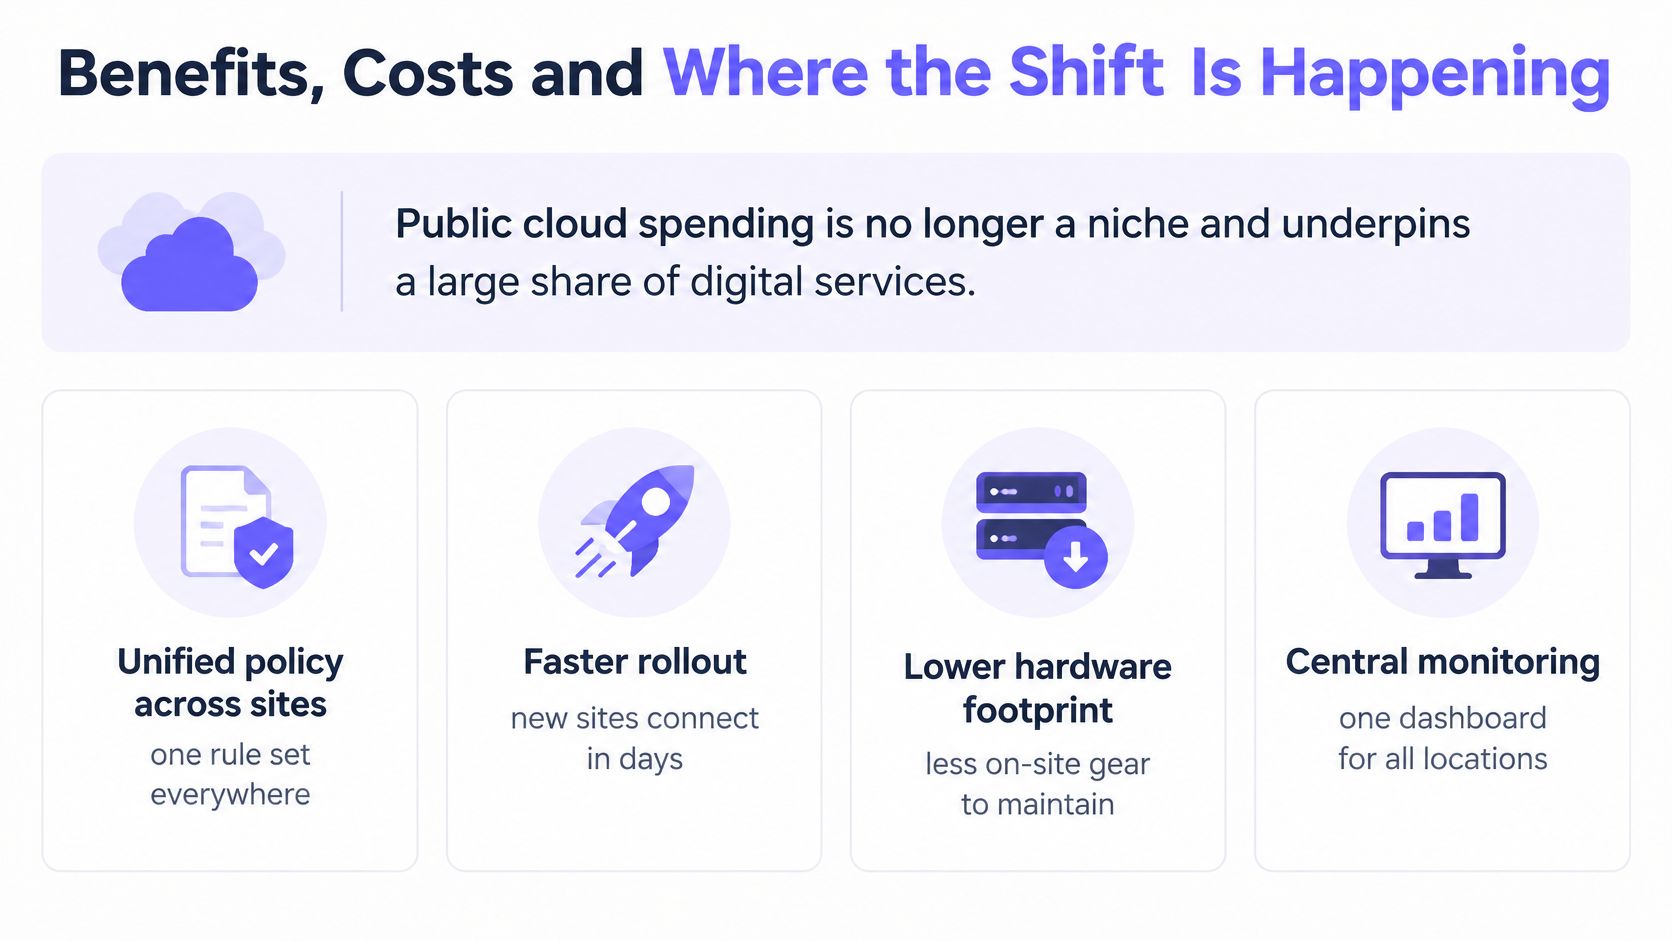
Die Einführung ist breit gefächert und nicht auf Großunternehmen beschränkt. Laut Eurostat nutzten im Jahr 2025 52,7 % der EU-Unternehmen kostenpflichtige Cloud-Dienste, was einem Anstieg von 7,4 Prozentpunkten gegenüber 2023 entspricht (Eurostat). Das irische Central Statistics Office verzeichnete, dass 42,6 % der irischen Unternehmen im Jahr 2025 cloudbasierte Sicherheitssoftware kauften (Central Statistics Office). Auch die Ausgaben konzentrieren sich zunehmend: 40 % der von Flexera befragten Unternehmen gaben jährlich mehr als 12 Millionen US-Dollar für Public Cloud aus, gegenüber 36 % im Vorjahr (Flexera).
Wenn Sie lieber eine exemplarische Anleitung ansehen möchten, anstatt den Rest zu lesen: Dieses Video erläutert das Modell in wenigen Minuten.
Für einen standortübergreifenden Betreiber geht jeder Vorteil mit entsprechenden Kosten einher.
- Schnelleres Onboarding, ausgeglichen durch wiederkehrende Gebühren. Ein neuer Veranstaltungsort wird innerhalb von Tagen angebunden statt nach einer Bestellung und einem Vor-Ort-Termin. Ein Abonnement ersetzt jedoch die Investitionsausgaben für Hardware, und diese Kosten enden nie ganz.
- Ein einheitlicher Richtliniensatz überall, ausgeglichen durch Schulungsaufwand. Zentrale Regeln bedeuten, dass eine Schutzänderung an jedem Standort innerhalb von Minuten wirksam wird. Sie bedeuten aber auch, dass Ihr Team eine neue Konsole erlernen und ihr vertrauen muss.
- Zentrale Protokolle für Audits, ausgeglichen durch Anbindungsabhängigkeit. Berichte werden von einem zentralen Ort bezogen, aber der Datenverkehr läuft weiterhin über die eigene Internetverbindung des jeweiligen Standorts - und keine Plattform kann eine schlechte Leitung reparieren.
Angenommen, eine Hotelgruppe mit zwölf Häusern wechselt von lokalen Controllern zu einem zentralen Management. Die Einbindung eines neuen Standorts reduziert sich auf einen Eintrag auf der Plattform und eine Richtlinie aus einer bestehenden Vorlage. Gleichzeitig verkürzt sich die routinemäßige Administration von zwölf separaten Logins auf eine einzige Prüfwarteschlange.
| Kennzahl | Wert | Vergleich | Quelle |
|---|---|---|---|
| Weltweite Endnutzerausgaben für Public Cloud 2024 | 675,4 Mrd. USD | 561 Mrd. USD im Jahr 2023, plus 20,4 % | Gartner |
| IaaS-Ausgaben 2024 | 180,0 Mrd. USD | 143,3 Mrd. USD im Jahr 2023, plus 25,6 % | Gartner |
| PaaS-Ausgaben 2024 | 172,4 Mrd. USD | plus 20,6 % | Gartner |
| SaaS-Ausgaben 2024 | 247,2 Mrd. USD | plus 20,0 % | Gartner |
| Public-Cloud-Endnutzerausgaben 2025 | 723,4 Mrd. USD | spätere Prognose nach dem Wert für 2024 | Gartner |
| EU-Unternehmen, die 2025 kostenpflichtige Cloud-Dienste nutzen | 52,7 % | plus 7,4 Prozentpunkte gegenüber 2023 | Eurostat |
| Irische Unternehmen, die 2025 cloudbasierte Sicherheitssoftware kaufen | 42,6 % | nur Irland | Central Statistics Office |
| Unternehmen, die jährlich über 12 Mio. USD für Public Cloud ausgeben | 40 % | 36 % im Vorjahr | Flexera 2025 |
Die Vorteile sind dort am größten, wo Standorte zahlreich und ähnlich sind und von einem kleinen Team betrieben werden. Zwölf nahezu identische Hotelnetzwerke profitieren von einer zentralen Verwaltung. Ein ungewöhnliches Gebäude mit maßgeschneiderter Ausstattung hingegen möglicherweise nicht.
Absicherung des Datenverkehrs auf der DNS-Ebene
DNS ist der frühestmögliche Punkt, um Anfragen abzuweisen. Eine Domain kann bereits während der Namensauflösung blockiert werden - noch bevor das Gerät eine Zieladresse hat und bevor eine Web-, TLS- oder Command-and-Control-Sitzung überhaupt beginnt. Das Gerät besitzt zu diesem Zeitpunkt zwar bereits eine IP-Adresse, nur eben nicht die gewünschte.
Eine Cloud-DNS-Ebene erfüllt drei Aufgaben, und es lohnt sich, diese separat zu benennen, da Anbieter sie oft miteinander vermischen.
- Kategoriefilterung. Inhalte für Erwachsene, Glücksspiel, Malware-Hosting oder was auch immer die Richtlinie vorsieht - angewendet pro SSID, damit ein Mitarbeiternetzwerk und ein Lesezimmer für Kinder nicht denselben Regelsatz nutzen.
- Bedrohungsblockierung. Phishing-Domains, Malware-Distributions-Hosts und Command-and-Control-Rückverbindungen werden direkt bei der Abfrage gestoppt und nicht erst nach Eintreffen der Nutzlast.
- Entfernung von Werbung und Trackern. Weniger Drittanbieter-Anfragen bedeuten schlankere Seiten und einen geringeren Datenverbrauch auf dem Smartphone eines Gasts.
Was geschützt werden muss, damit dies funktioniert
Sicheres DNS umfasst drei separate Anforderungen, die oft als Einheit vermarktet werden: Integrität, Vertraulichkeit und Verfügbarkeit. DNSSEC gewährleistet die Integrität, indem validiert wird, dass eine signierte Antwort nicht manipuliert wurde. Die Vertraulichkeit wird leichter übersehen, da selbst bei einer korrekten Antwort die Abfrage preisgegeben werden kann, wenn Anfragen im Klartext übertragen werden. Die Verfügbarkeit erfordert ein eigenes Konzept, weshalb Betreiber weiterhin verteilt arbeitende Resolver, Fehlertoleranz und mehr als einen rekursiven Resolver in der Konfiguration einsetzen.
Daraus ergibt sich eine kurze Checkliste für jedes Gäste- oder öffentliche Netzwerk:
- Leiten Sie sämtlichen Client-DNS an von Ihnen kontrollierte Resolver weiter, anstatt Geräten die eigene Wahl zu überlassen.
- Verhindern Sie Umgehungen dort, wo die Hardware es zulässt, indem Sie ausgehenden DNS-Traffic zu anderen Servern blockieren.
- Validieren Sie DNSSEC-Antworten, damit manipulierte Antworten abgelehnt werden.
- Schützen Sie den Abfragetransport dort, wo Datenschutzbestimmungen gelten, damit Anfragen während der Übertragung nicht lesbar sind.
- Bewahren Sie Protokolle lange genug auf, um nachzuvollziehen, welches Gerät wann versucht hat, ein Ziel zu erreichen.
Jeder Punkt ist ein Fehlerszenario, das Sie testen sollten, bevor es ein echter Vorfall für Sie tut. Richten Sie ein Gerät auf einen externen Resolver und prüfen Sie, ob die Bypass-Regel greift. Fragen Sie sich dann, was passiert, wenn die Resolver nicht mehr reagieren: Fail-Open hält Gäste online, setzt jedoch alle Richtlinien außer Kraft; Fail-Closed behält die Richtlinien bei, verwandelt jedoch einen Resolver-Fehler in einen Komplettausfall. Purple Shield setzt auf Fail-Closed und läuft über mehrere Rechenzentren hinweg, sodass ein Ausfall an einem Standort nicht den gesamten Dienst lahmlegt.
Prüfen Sie das Protokoll, bevor Sie dem Filter vertrauen. Eine Sperrseite allein beweist nichts. Der Lookup-Datensatz beweist, was für welches Netzwerk zu welcher Zeit abgelehnt wurde.
DNS-Filtering greift ergänzend zu Endpoint Protection, Firewalls und Anwendungskontrollen. Der Nutzen von DNS-Sicherheit als Steuerungsebene basiert darauf, dass sie eine Schutzschicht unter vielen darstellt und diese keineswegs ersetzt.
Was bei einem Ausfall eines cloudbasierten Netzwerks weiterhin funktioniert
Ein Standort kann das Cloud-Dashboard verlieren und dennoch Datenverkehr durchleiten. Ebenso kann das Dashboard verfügbar bleiben, während der DNS-Pfad zur Filterung unterbrochen ist. Diese Ausfälle wirken aus der Ferne betrachtet ähnlich, betreffen jedoch unterschiedliche Netzwerkkomponenten. Konzipieren Sie die Ausfallsicherheit für jedes dieser Szenarien separat.
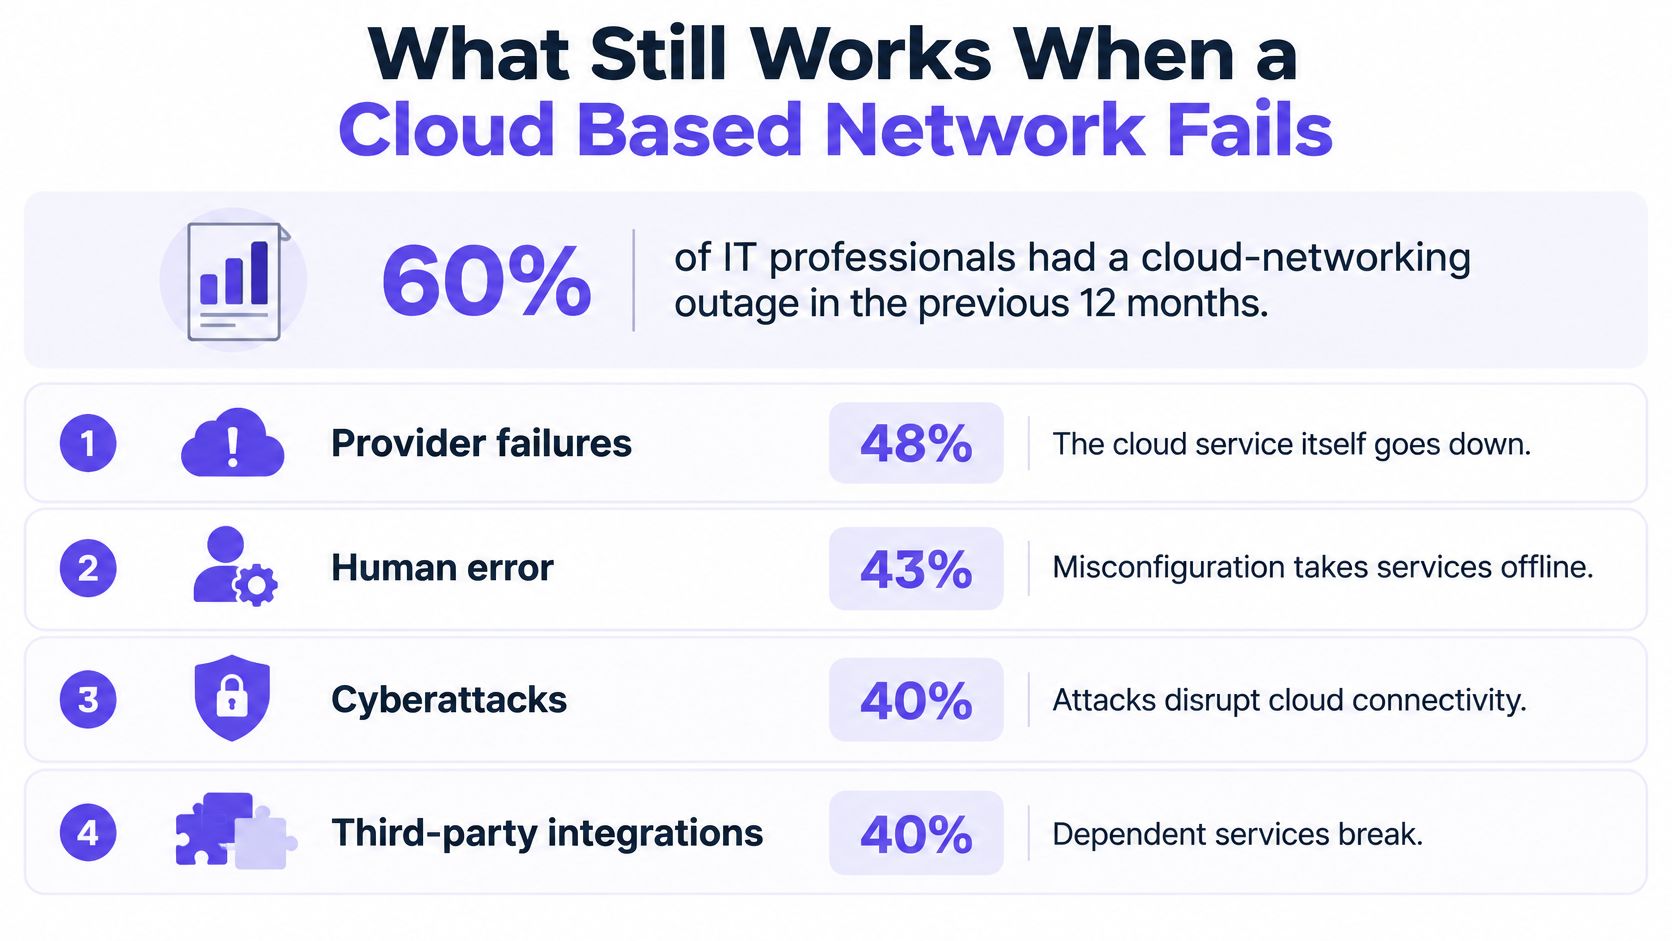
Eine Branchenumfrage ergab, dass 60 % der IT-Fachkräfte in den vergangenen 12 Monaten einen Ausfall ihres Cloud-Netzwerks erlebt haben. Als Ursachen wurden unter anderem Ausfälle von Cloud-Providern, menschliches Versagen, Drittanbieter-Integrationen, Cyberangriffe und Fehlkonfigurationen genannt (Aviatrix-Branchenumfrage 2025).
Die Uptime-Angabe eines Anbieters beschreibt dessen Plattform, nicht aber, ob Ihr Standort Richtlinien weiter anwenden kann, wenn diese Plattform nicht erreichbar ist. Das Dashboard ist die Schaltzentrale; die Geräte vor Ort müssen weiterhin Datenverkehr bewältigen und die bereits erhaltenen Regeln durchsetzen.
Ein SLA beschreibt, was der Anbieter verspricht. Es sagt Ihnen jedoch nicht, was Ihre Access Points tun, wenn die Control Plane nicht erreichbar ist.
Zwei Ausfälle, die gleich aussehen, es aber nicht sind
Wenn die Management-Ebene ausfällt, können Sie möglicherweise keine Richtlinien ändern, keine aktuellen Berichte einsehen oder keinen neuen Standort einbinden. Der bestehende Datenverkehr und die Regeldurchsetzung können fortgesetzt werden, da die Regeln bereits an den Netzwerkrand übertragen wurden.
Wenn die Durchsetzungsebene, meist das DNS oder dessen Resolver-Pfad, ausfällt, bemerken die Benutzer dies sofort. Einige Websites werden möglicherweise nicht mehr aufgelöst; alternativ wird möglicherweise alles aufgelöst, da die Filterung umgangen wurde.
Das ist die Entscheidung zwischen Fail-Open und Fail-Closed. Fail-Open stellt die Konnektivität über eine gewöhnliche rekursive Auflösung wieder her, falls der Cloud-Dienst nicht verfügbar ist; Schutzmechanismen greifen dann jedoch nicht mehr. Fail-Closed hält die Richtlinien aufrecht, aber ein DNS-Ausfall kann auch legitime Dienste wie Kartenzahlungen oder Buchungssysteme blockieren, es sei denn, das Netzwerk verfügt über getestete Fallback-Vorkehrungen. Keines der beiden Verhaltensweisen eignet sich für jeden Veranstaltungsort. Entscheidend ist, dass Sie wissen, welches Verhalten Ihr Netzwerk nutzt und welche Erfahrungen die Nutzer machen werden (Leitfaden zur Filterung nach Fail-Open im Vergleich zu Fail-Closed).
Planen Sie das Fallback, bevor Sie es benötigen
Konfigurieren Sie mehr als einen Resolver und überwachen Sie dessen Funktionsfähigkeit. Bestimmen Sie die Dienste, die verfügbar bleiben müssen, und testen Sie einen Fallback-Pfad für diese. Wenn Gäste den Internetzugang verlieren, sollte das Captive Portal den Ausfall erklären, anstatt nur ein Ladesymbol anzuzeigen.
Cloud-Management macht die Hardware vor Ort nicht überflüssig. Access Points, Switches und die Internetverbindung des Standorts bleiben unverzichtbare Bestandteile des Dienstes, und ein Ausfall der Anbindung kann den Standort weiterhin lahmlegen. Auch das Reporting hängt von Protokollen, Aufbewahrungsfristen und einem Format ab, das Mitarbeiter interpretieren können.
| Ausfall | Was weiterhin funktioniert | Richtlinienverhalten | Vor dem Go-Live testen |
|---|---|---|---|
| Ausfall der Cloud-Management-Ebene | Bestehender Datenverkehr und Durchsetzung, sofern Regeln bereits aktiv sind | In der Regel unverändert | Management-Zugriff trennen und sicherstellen, dass der Datenverkehr weiter fließt |
| Ausfall des DNS-Resolvers | Lokaler Cache und sekundäre Resolver, sofern konfiguriert | Fail-Open oder Fail-Closed, je nach Konfiguration | Primären Resolver blockieren und prüfen, ob der sekundäre antwortet |
| Internetanbindung des Standorts ausgefallen | Nur lokale Dienste | Nicht zutreffend | WAN-Verbindung trennen und bestätigen, dass die Fallback-Nachricht angezeigt wird |
| Störung beim Netzbetreiber oder Upstream-Provider | Datenverkehr über einen alternativen Pfad, sofern vorhanden | Unverändert, wenn ein zweiter Pfad den Datenverkehr übernimmt | Upstream-Ausfall simulieren und die Failover-Route überprüfen |
| Ausfall des Identity-Providers | Offene oder Pre-Shared SSIDs | Authentifizierter Zugriff wird möglicherweise unterbrochen | Login-Fallback für Mitarbeiter und Gäste testen |
Drei Schritte zum Nachweis
- Führen Sie jeden Test an einem Standort durch. Machen Sie dies während der Geschäftszeiten, um sowohl die tatsächliche Nutzererfahrung der Gäste als auch die Netzwerkmetriken zu überprüfen.
- Dokumentieren Sie das Ergebnis. Halten Sie fest, welche Dienste weiterhin funktionierten, ob Richtlinien per Fail-Open oder Fail-Closed reagierten, das Datum sowie die testende Person.
- Wiederholen Sie den Test nach Richtlinienänderungen. Ein neues Regelwerk kann das Fallback-Verhalten verändern.
Abonnementkosten und die Abhängigkeit von der Internetverbindung beeinflussen, was Sie bereitstellen können, beantworten aber nicht, was bei einem Ausfall passiert. Wenn Sie nur einen Standort testen können, beginnen Sie mit dem Standort, der die meisten Gäste oder die strengste Sorgfaltspflicht hat.
Setup auswählen und Pilotprojekt an einem Standort durchführen
Bevor Sie Produkte vergleichen, legen Sie fest, wozu Ihr Netzwerk dient. Die Reihenfolge ist wichtiger als das Tool.
- Erfassen Sie jeden Standort und jede Nutzergruppe. Gäste, Mitarbeiter, Studenten, Bewohner, zahlende Tarife. Schreiben Sie die Liste auf; die meisten Betreiber entdecken zwei Gruppen, die sie vergessen hatten.
- Weisen Sie jeder Gruppe vom ersten Tag an eine eigene SSID oder VLAN zu. Ein Mitarbeiternetzwerk, das denselben Regelsatz wie ein Gästenetzwerk nutzt, ist ein vorprogrammierter Sicherheitsvorfall. Beim Onboarding sollte jedes Kundennetzwerk eine eigene Richtlinie erhalten - getrennt für Gäste, Mitarbeiter, Studenten, Bewohner und zahlende Tarife.
- Kennzeichnen Sie die für Sie relevanten Ausfalltests. Ausfall der Management-Ebene, DNS-Failover, getrenntes WAN, Upstream-Ausfall und Ausfall des Identity-Providers. Wenn ein Test nicht zutrifft, geben Sie dies explizit an, anstatt ihn wegzulassen.
- Führen Sie ein Pilotprojekt in einem einzelnen Netzwerk durch und dokumentieren Sie das Ergebnis, bevor Sie mit dem weiteren Rollout fortfahren. Ein Standort, eine Woche, eine Seite mit Erkenntnissen.
Purple Shield setzt genau nach diesen Schritten an - nicht anstelle dieser. Eine einzige DNS-Schicht filtert Inhalte, blockiert Bedrohungen und entfernt Werbung auf jedem Gerät in jedem Netzwerk, mit Richtlinien pro SSID, VLAN und Standort sowie einem zentralen Dashboard. Sie können die Lösung 30 Tage lang kostenlos in einem Netzwerk testen oder gemeinsam mit unserem Team einen Piloten für ein einzelnes SSID durchführen - und erst danach ein individuelles Angebot erhalten.
Wählen Sie diese Woche also einen Standort aus. Erfassen Sie dessen Benutzergruppen, füllen Sie die Ausfalltabelle nur für diesen Standort aus und buchen Sie das Pilotprojekt, sobald Sie wissen, wie sich Ihr Netzwerk bei einem Ausfall verhalten soll.
Purple Shield ist schützendes DNS und Inhaltsfilterung, entwickelt für Veranstaltungsorte, Gäste- und öffentliches WiFi. Es läuft eigenständig auf jedem WiFi-Netzwerk oder zusammen mit Purple Access, mit einer separaten Richtlinie für jeden SSID, VLAN und Veranstaltungsort sowie Berichten, die genau zeigen, was blockiert wurde. Es läuft über mehrere Rechenzentren und schlägt im Zweifel sicher fehl (Fail-Closed), sodass ein Resolver-Problem Ihre Schutzmaßnahmen nicht deaktiviert. Starten Sie eine 30-tägige kostenlose Testphase in einem Netzwerk unter Purple Shield und testen Sie das Ausfallverhalten in der Praxis, bevor Sie sich vertraglich binden.