
Netzwerkverkehr analysieren: Erfassen, Lesen und Beheben von Problemen
Erfahren Sie Schritt für Schritt, wie Sie Netzwerkverkehr analysieren: Daten erfassen, eine Baseline erstellen, verschlüsselte Datenflüsse lesen und Sicherheits- oder Leistungsprobleme erkennen.
Published 20. November 2026
Es ist Dienstag, 14:10 Uhr, und der Empfang hat sich bereits zweimal über langsames WiFi beschwert. Über Nacht wurde nichts geändert. Die Access Points sind betriebsbereit, der Uplink-Graph sieht fast genauso aus wie gestern, und der Provider meldet eine einwandfreie Leitung. Sie haben rund zwanzig Minuten Zeit, bevor jemand entscheidet, dass das Problem in der Verantwortung des Netzwerkteams liegt.
Genau für diese zwanzig Minuten ist die Traffic-Analyse da. Es geht nicht darum, jedes einzelne Paket zu erfassen, sondern darum, einige wesentliche Punkte schnell nachzuweisen: ob die Verbindung ausgelastet ist, ob sich ein Gerät auffällig verhält, ob eine interne Komponente mit einem unzulässigen Host kommuniziert oder ob sich die Beschwerde schlicht auf die Netzabdeckung in einer bestimmten Gebäudeecke bezieht.
Die Reihenfolge ist entscheidend. Definieren Sie die richtigen Metriken, führen Sie eine Erfassung durch, die eine konkrete Frage beantwortet, erstellen Sie eine vergleichbare Baseline und führen Sie Aufzeichnungen, die Sie jederzeit problemlos rechtfertigen können.
Inhaltsverzeichnis
- Relevante Traffic-Metriken und ihre Bedeutung
- Schritt-für-Schritt-Erfassung von Traffic
- Erstellung einer Baseline für normalen Datenverkehr
- Analyse von verschlüsseltem Datenverkehr
- Erkennen von Sicherheits- und Performance-Problemen
- Beweissicherung ohne übermäßige Datenerhebung
- Wählen Sie Ihr erstes Monitoring-Setup
Wichtige Traffic-Metriken und ihre Bedeutung
Langsames WiFi um 14:00 Uhr bedeutet selten, dass das Netzwerk ausgefallen ist. Meistens bedeutet es eines von drei Dingen: Die Nachfrage hat ihren Höhepunkt erreicht, ein einzelnes Gerät verhält sich ungewöhnlich oder ein Host im Netzwerk hat begonnen, mit einem unzulässigen Ziel zu kommunizieren. Diese Möglichkeiten lassen sich mit wenigen Kennzahlen voneinander abgrenzen, die Sie wahrscheinlich ohnehin schon erfassen.
Die wachsende Gerätevielfalt erschwert dies zunehmend. Die Prognose von Cisco für 2017 bis 2022 sagte voraus, dass der Festnetz- und WiFi-Verkehr bis 2022 51 % des gesamten IP-Datenverkehrs erreichen würde (gegenüber 43 % im Jahr 2017) und dass Nicht-PC-Geräte 81 % des weltweiten IP-Datenverkehrs generieren würden (Cisco Global Connections Forecast). Smartphones, Smart-TVs, Kassensysteme und Gebäudesteuerungen machen heute den Großteil des Volumens aus - und keines dieser Geräte taucht in einem Asset-Register auf.
| Metrik | Was sie aufzeigt | Warnzeichen |
|---|---|---|
| Link-Auslastung | Wie ausgelastet eine Verbindung im Zeitverlauf ist | Dauerhaft über 70-80 % der Kapazität |
| Top-Talker | Hosts oder SSIDs mit dem höchsten Datenvolumen | Ein einzelnes Gerät verbraucht einen unverhältnismäßig großen Anteil |
| Protokoll- und Port-Mix | Ob der Datenverkehr den erwarteten Diensten entspricht | Unerwartete Ports oder Protokolle in großem Umfang |
| DNS-Abfragevolumen | Lookup-Aktivität pro Host | Plötzliche Spitzen oder wiederholte Lookups einer einzelnen Domain |
| NXDOMAIN-Anteil | Fehlgeschlagene Namensauflösungen | Steigender Anteil, oft Malware oder Fehlkonfiguration |
| Neue Verbindungen pro Minute | Rate der Sitzungserstellung | Deutlicher Anstieg, der auf Scans oder Flooding hinweist |
| Retransmissions | Verlorene oder wiederholte Pakete | Über 1-2 % der Pakete |
| Latenz und Jitter | Verzögerung und deren Schwankungsbreite | Jitter, der Sprach- oder Videoanrufe unterbricht |
Betrachten Sie diese Liste als Triage-Reihenfolge, nicht als Scorecard. Beginnen Sie um 14:00 Uhr mit der Link-Auslastung der letzten Stunde und vergleichen Sie diese mit derselben Stunde in normalen Wochen. Befindet sich die Auslastung auf ihrem gewohnten Höchststand und sind die erneuten Übertragungen normal, liegt die Ursache in der Kapazität. Die Lösung besteht dann in Scheduling, Shaping oder zusätzlicher Bandbreite - anstatt auf Malware-Suche zu gehen.
Wenn die Auslastung unauffällig ist und ein einzelnes Gerät die Top-Talker anführt, sollten Sie als Nächstes dieses Gerät überprüfen - nicht den Uplink. Wenn die erneuten Übertragungen steigen, während die Auslastung unverändert bleibt, beenden Sie die Analyse des Datenverkehrs und überprüfen Sie die Infrastruktur: ein fehlerhaftes Kabel, eine Duplex-Fehlkonfiguration oder ein Access Point, der auf einem überlasteten Kanal mit Interferenzen kämpft.
Die Regel, die Diskussionen beendet: Ein einzelner Messwert beweist gar nichts. Eine Zahl ist nur im Vergleich zum Normalbereich desselben Standorts zur gleichen Stunde aussagekräftig.
Traffic erfassen - Schritt für Schritt
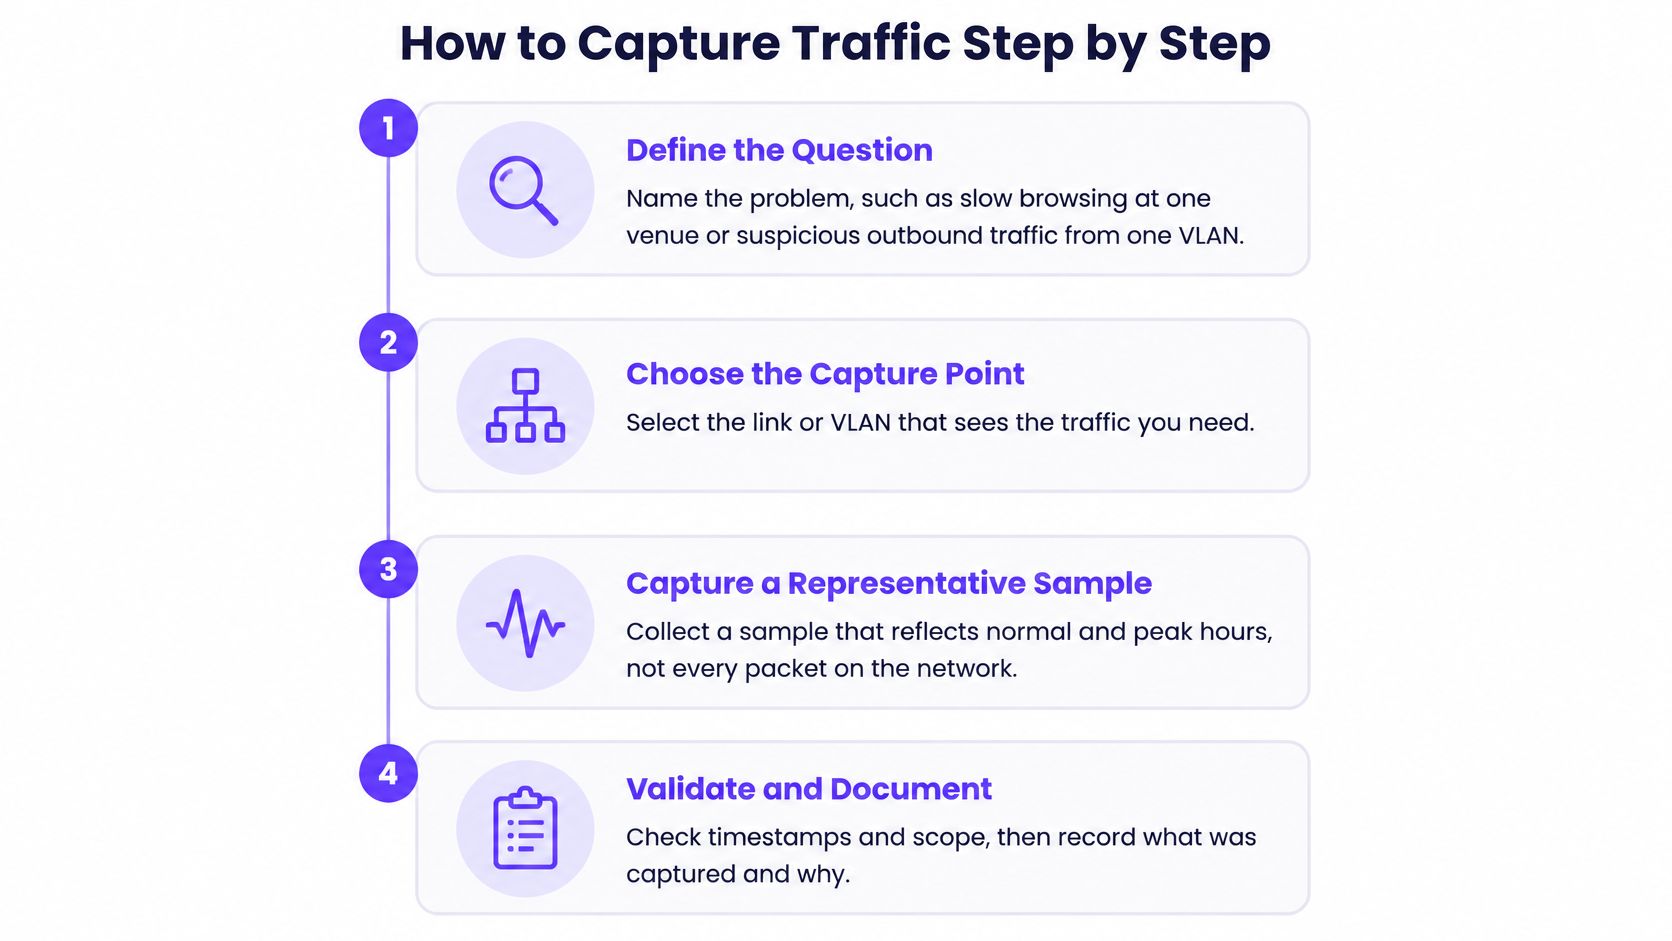
Ziel ist eine repräsentative Stichprobe, kein vollständiges Abbild des Netzwerks. Zwanzig Minuten zur richtigen Zeit erfasst sind besser als eine Woche voller Dateien, die niemand öffnet - und der Datensatz bleibt klein genug, um ihn an Kollegen weiterzuleiten.
Definieren Sie die Fragestellung. "Langsames Surfen im Gäste-SSID an einem Standort" und "unerwarteter ausgehender Datenverkehr aus dem Zahlungs-VLAN" erfordern unterschiedliche Erfassungspunkte, Filter und Dauern. Notieren Sie sich die Fragestellung, bevor Sie sich an einem Switch anmelden. Der häufige Fehler besteht darin, zuerst aufzuzeichnen und zu hoffen, dass sich die Frage in der Datei wiederfindet.
Wählen Sie einen Punkt, der beide Richtungen erfasst. Ein SPAN-Port am Switch, ein Inline-TAP am Uplink oder Flow-Export vom Router oder der Firewall. Flow-Export ist der kostengünstigste Weg, einen Standort kontinuierlich zu überwachen, und die Paketerfassung ist das Mittel der Wahl, wenn Flows Auffälligkeiten zeigen. Das Spiegeln eines Ports, der nur eine Richtung überträgt, liefert Ihnen nur ein halbes Gespräch und eine Retransmission-Anzahl ohne Aussagekraft.
Filtern Sie vor der Aufzeichnung. Begrenzen Sie die Erfassung auf ein Subnetz, ein VLAN oder einen Host. So bleibt die Datei klein genug, um sich in Sekundenschnelle öffnen zu lassen, und Sie erfassen keinen Datenverkehr von Mitarbeitern und Gästen, die nicht Teil des Problems sind.
Erfassen Sie ein festes Zeitfenster. Fünfzehn bis dreißig Minuten während der Spitzenzeiten, dann eine kürzere Erfassung während einer ruhigen Phase. Der Vergleich beider ermöglicht spätere Analysen; eine einzelne Erfassung ist lediglich eine Momentaufnahme.
Geben Sie Standort, Datum und Uhrzeit im Dateinamen an. Das wirkt nebensächlich, bis Sie vierzig Erfassungen vorliegen haben und nicht mehr wissen, welcher Standort angerufen hat.
Arbeiten Sie mit Anzeigefiltern statt mit Scrollen. Beginnen Sie mit der Protokollhierarchie und den Verbindungen, um zu sehen, was vorhanden ist, und grenzen Sie dann auf Retransmissions oder Namensauflösungen ein. Wer eine stark ausgelastete Erfassung manuell durchscrollt, kommt schnell fälschlicherweise zu dem Schluss, dass kein Problem vorliegt.
Dokumentieren Sie den Kontext zusammen mit der Datei. Erfassungspunkt, Filter, Zeitpunkt, was Benutzer gemeldet haben und was Sie bereits ausgeschlossen haben.
Eine Gewohnheit sorgt dafür, dass die Daten später nutzbar sind. Normalisieren Sie Flows nach Schnittstelle, SSID oder VLAN, Standort, Zeitfenster sowie Richtung und berücksichtigen Sie NAT, asymmetrisches Routing, Tunneling und gemeinsam genutzte Geräte, bevor Sie Schwellenwerte festlegen (Vectras Leitfaden zur Analyse von verschlüsseltem Datenverkehr). Der Netzwerkkontext ist kein Störgeräusch bei der Analyse, sondern ein wesentlicher Bestandteil davon.
Wenn Sie den gesamten Ablauf auf einer einzigen Seite für Ihr Team zusammenfassen möchten, folgt hier die Reihenfolge:
| Erfassungspunkt | Ideal für | Kompromiss |
|---|---|---|
| SPAN- oder Mirror-Port | Paketerfassung an einem Port oder VLAN | Erfasst nur gespiegelten Datenverkehr und kann eine Richtung verpassen |
| Netzwerk-TAP | Vollständige Paketerfassung auf einer einzelnen Verbindung | Dedizierte Hardware; erfasst beide Richtungen zuverlässig |
| Flow-Export (NetFlow, sFlow, IPFIX) | Langzeitüberwachung über Router oder Firewall | Kostengünstigste Option; speichert Flow-Zusammenfassungen, keine Pakete |
Erstellung einer Baseline für normalen Traffic
Ein Messwert wird erst dann zu einem aussagekräftigen Signal, wenn Sie wissen, wie dieser Wert üblicherweise aussieht. Baselines werden oft vernachlässigt, weil sie mühsam sind - die Folge ist später eine Flut von Warnmeldungen, die jeder stummschaltet.
Gesamtzahlen live zu beobachten, ist die leichtere Hälfte. Zu wissen, welche Gesamtzahlen für diese Stunde an diesem Standort ungewöhnlich sind, ist die andere.
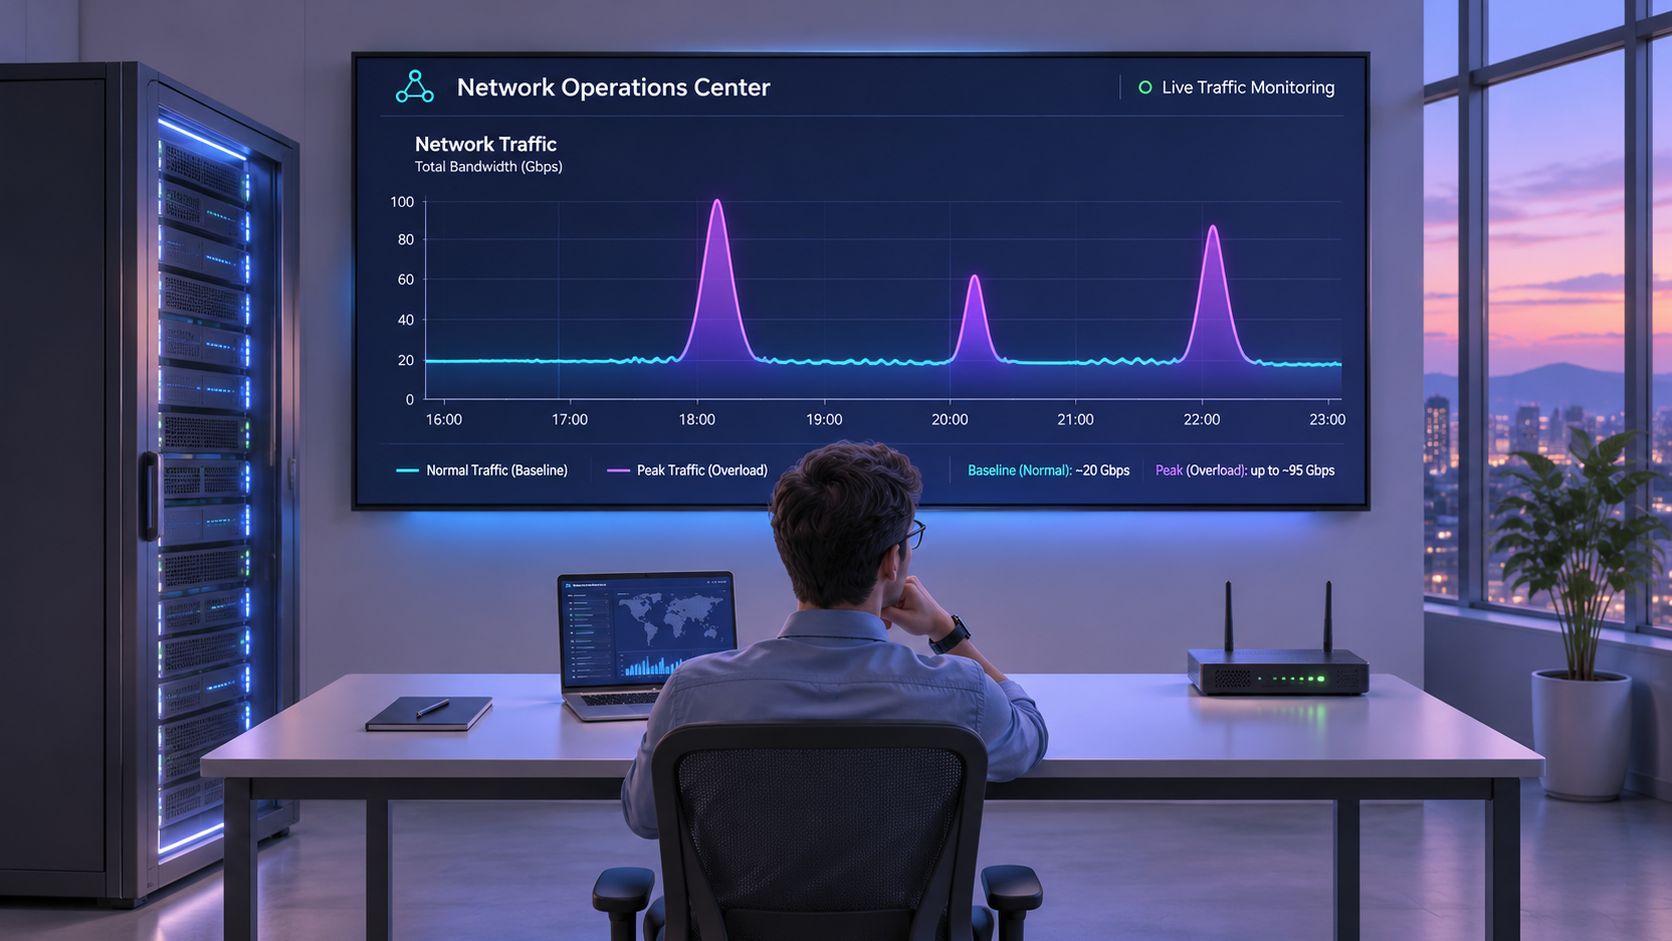
Wachstum führt dazu, dass jede Baseline schnell veraltet. Laut der Prognose von Cisco sollte der weltweite IP-Datenverkehr von 122,4 Exabyte pro Monat im Jahr 2017 auf 396,0 Exabyte pro Monat im Jahr 2022 steigen - eine jährliche Wachstumsrate (CAGR) von 26 %. Der Datenverkehr in Spitzenzeiten wurde auf etwa 7,2 Petabit pro Sekunde gegenüber einem Durchschnitt von fast 1 Petabit pro Sekunde geschätzt (Cisco Global IP Traffic Forecast). Die Differenz zwischen Durchschnitt und Spitzenlast ist der Grund dafür, dass Verbindungen überlastet werden.
Der Anstieg hält unvermindert an. Cloudflare Radar verzeichnete im Jahr 2024 ein Wachstum des weltweiten Internet-Traffics von 17,2 % (Cloudflare Radar: Rückblick auf 2024) - das reicht aus, um eine zwei Jahre alte Baseline ein Netzwerk beschreiben zu lassen, das in dieser Form gar nicht mehr existiert.
Was stündlich erfasst werden sollte
- Volumen pro SSID und VLAN, nicht nur pro Uplink - denn ein gleichbleibender Uplink verschleiert, welches Segment gewachsen ist.
- DNS-Abfragerate und NXDOMAIN-Anteil, gemessen pro tausend Lookups, damit das Verhältnis auch bei Traffic-Wachstum aussagekräftig bleibt.
- Top-Ziele und neue Verbindungen pro Minute, bezogen auf die Stunde der Woche und nicht nur des Tages.
- Zeitplan-Kontext, damit Schulzeiten, Veranstaltungstage und Wochenendauslastungen von Hotels klar zugeordnet und nicht fälschlicherweise als Anomalien eingestuft werden.
Erstellen Sie die Baseline über mindestens zwei Wochen hinweg und decken Sie dabei Wochentage, Wochenenden sowie verkehrsstarke und ruhige Zeiten ab. Legen Sie Schwellenwerte pro Wochenstunde fest, damit eine Auslastungsspitze am Freitagabend in einem Hotel nicht alle sieben Tage einen Incident auslöst.
Drei aufeinanderfolgende Tage außerhalb des Normbereichs zur gleichen Stunde sind eine Untersuchung wert. Ein einzelner Ausreißer ist meist auf einen Streaming-Stream eines Spiels, ein Software-Rollout oder eine Konferenz-Keynote zurückzuführen und gehört in die Notizen, nicht in eine Eskalation.
Traffic analysieren bei Verschlüsselung
TLS 1.3, QUIC über UDP/443, HTTP/3, VPNs und verschlüsseltes DNS machen die meisten Payloads unzugänglich. Jeder Plan, der auf dem Auslesen von Seiteninhalten basiert, führt unweigerlich zu Enttäuschungen bei den Auftraggebern.
Das Dashboard bleibt weiterhin nützlich. Es liefert nun Antworten auf andere Fragestellungen als zuvor.
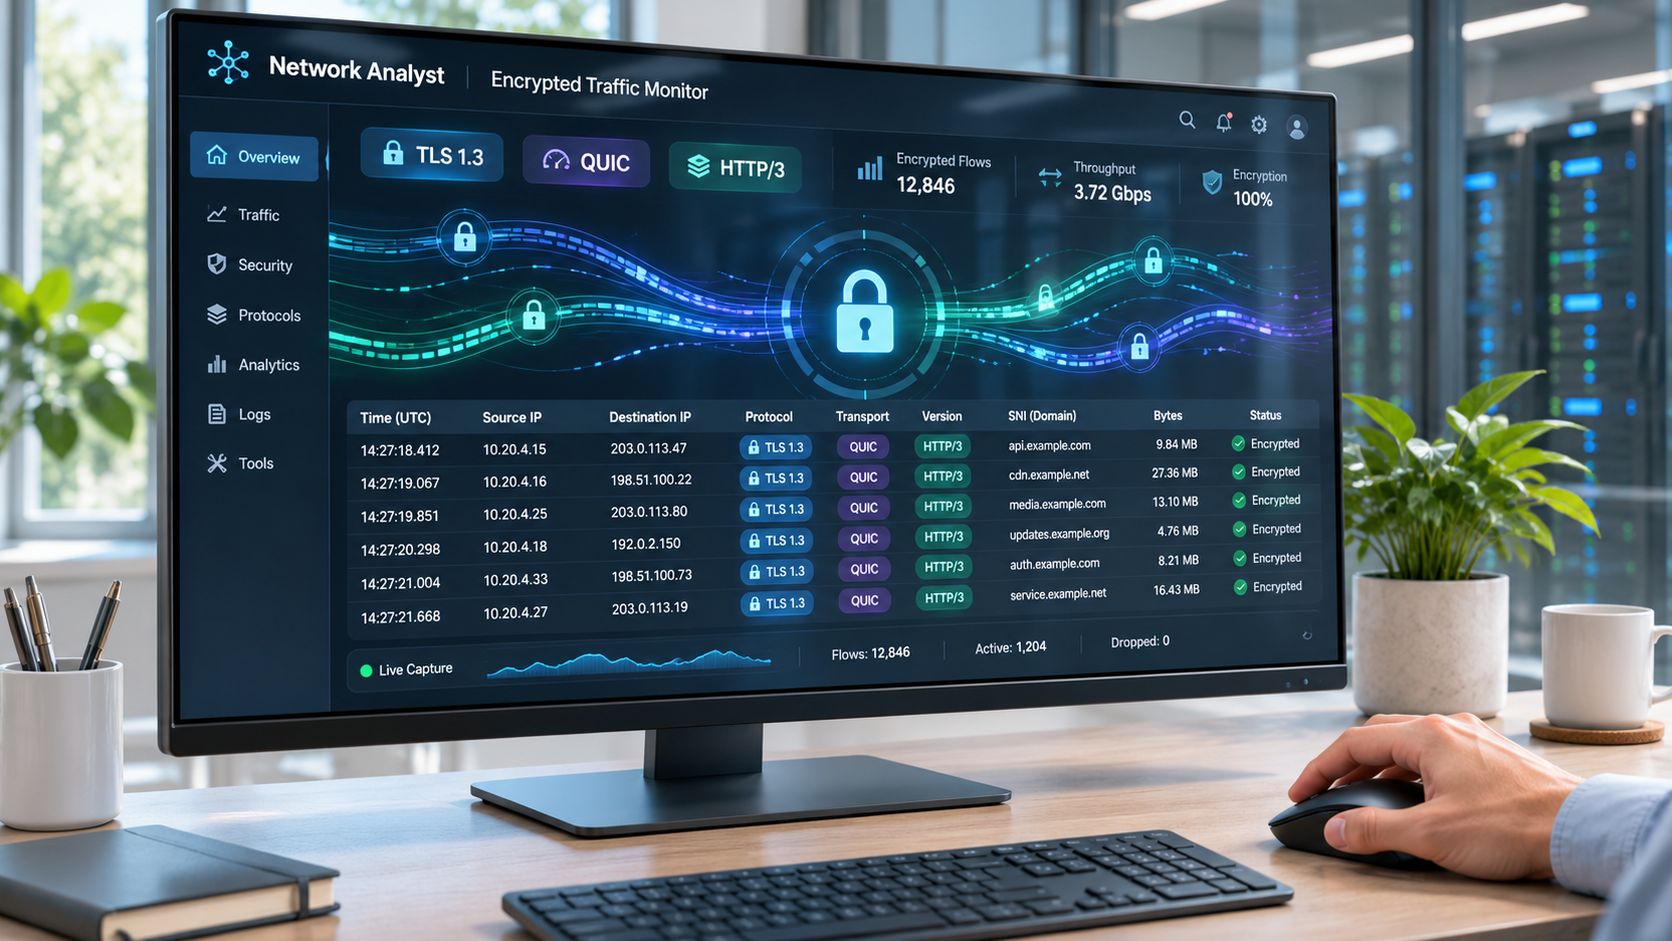
Die Metadaten sind aussagekräftiger, als es scheint. Forscher, die ein Modell auf 500 QUIC-fähigen Websites trainierten, identifizierten 70 % der überwachten Websites mit einer Genauigkeit von 90 % allein anhand von DNS-Paketen; dieser Wert stieg auf etwa 80 % Recall bei 90 % Genauigkeit, wenn DNS-over-QUIC mit HTTP/3-Traffic kombiniert wurde (A*STAR-Forschung zu verschlüsseltem Datenverkehr). Paketgrößen, Timing und Richtung verraten nach wie vor viel.
Was dies ermöglicht, sind Anomalieerkennung, Anwendungsklassifizierung und Threat Triage. Was es nicht ermöglicht, ist eine Aussage darüber, was eine Person gelesen, getippt oder beabsichtigt hat. Stellen Sie diesen Unterschied klar heraus, bevor einer Führungskraft ein Bericht über aufgerufene Inhalte versprochen wird.
Für eine detaillierte Übersicht darüber, wie viel in einer echten Erfassung trotz Verschlüsselung sichtbar bleibt:
Die Evaluierung ist der Punkt, an dem Arbeiten zu verschlüsseltem Datenverkehr meist scheitern. Teilen Sie Trainings- und Testdaten nach vollständigen Flows auf, nicht nach Paketen, da die Aufteilung nach Paketen nahezu identische Sitzungsdaten in beide Datensätze leitet; bei einer aktuellen Evaluierung sank die Genauigkeit nach Anwendung einer Trennung auf Flow-Ebene auf knapp 40 % (Evaluierung der Klassifizierung von verschlüsseltem Datenverkehr auf arXiv).
Resolver-Protokolle sind nur so aussagekräftig wie der Punkt, an dem DNS terminiert. Wenn Teile Ihrer IT-Landschaft verschlüsselte DNS-Resolver und DoH-Endpunkte erreichen, die Sie nicht kontrollieren, dokumentieren Sie diese Lücke, anstatt eine Transparenz vorzutäuschen, die nicht existiert.
Sicherheits- und Leistungsprobleme erkennen
Ein Host, der Beacons an eine Command-and-Control-Domain sendet, und ein Host, der eine Leitung überlastet, sehen auf einem Dashboard ähnlich aus. Beide erzeugen Datenverkehr. Sie erfordern jedoch unterschiedliche Erstprüfungen, und eine falsche Annahme kann die erste Stunde ungenutzt verstreichen lassen.
Bedrohungen in einem Netzwerk sind häufig genug, um fest eingeplant zu werden. Akamai berichtete 2023, dass zwischen 10 % und 16 % der Unternehmen in einem beliebigen Quartal Command-and-Control-Traffic in ihren Netzwerken feststellten (Akamai-Studie zu bösartigem DNS-Traffic). Beaconing ist so konzipiert, dass es wie normales Browsen aussieht - man erkennt es daher anhand von Mustern und nicht über das Volumen.
| Symptom | Wahrscheinliche Ursache | Erste Prüfung |
|---|---|---|
| Langsames Surfen zu Spitzenzeiten | Verbindungssättigung | Auslastung nach Stunde im Vergleich zur Baseline |
| Regelmäßige kleine Verbindungen zu einer unbekannten Domain | Command-and-Control-Beaconing | Verbindungsintervall und DNS-Verlauf für den Host |
| Großer Upload von einem Host in der Nacht | Exfiltration oder unplanmäßiges Backup | Normales ausgehendes Volumen des Hosts |
| Sprunghafter Anstieg von NXDOMAIN-Antworten | Malware-Lookups oder Resolver-Fehler | Häufigste abgefragte Domains und Resolver-Protokolle |
| Steigende Retransmissions bei normaler Auslastung | Defektes Kabel oder WiFi-Interferenzen | Fehlerzähler und Paketverlust pro AP |
| Wiederholte Lookups einer Domain durch viele Hosts | Kompromittierte App oder fehlkonfiguriertes Gerät | Quell-Hosts und Ziel-Reputation |
Wie Beaconing in einem Flow-Datensatz aussieht
Ein Gerät, das eine Domain in gleichmäßigen Abständen mit geringen und einheitlichen Anfrage- sowie Antwortgrößen kontaktiert, unterscheidet sich grundlegend vom typischen Tagesmuster desselben Hosts. Rufen Sie die Verbindungsintervalle und den DNS-Verlauf für diesen Host ab, bevor Sie Blockierungen vornehmen. Ein Smart-TV, der nach einem festen Zeitplan nach Firmware-Updates sucht, weist dasselbe Muster auf und kann Sie schnell einen ganzen Arbeitstag kosten.
Große Uploads über Nacht erfordern Kontext statt Alarmbereitschaft. Vergleichen Sie das ausgehende Datenvolumen des Hosts mit seinen Normalwerten und prüfen Sie anschließend, ob sich ein Backup-Fenster verschoben hat oder ein neuer Cloud-Synchronisierungsclient installiert wurde. Die entscheidende Frage ist nicht, ob die Datenübertragung in absoluten Zahlen groß ist, sondern ob sie für diesen Host ungewöhnlich ist.
Überprüfen Sie die Blockierliste und den Threat-Feed, bevor Sie die Ursache beim Netzwerk suchen. Erfassen Sie den Befund mit Zeitstempel, Host und Zieladresse, damit die nächste Person ihn nachvollziehen kann, anstatt die Analyse zu wiederholen. Diese Nachweise ermöglichen es Ihnen zudem zu belegen, was blockiert wurde, anstatt auf Basis einer vagen Warnung zu argumentieren.
Wenn sich herausstellt, dass das Symptom eher eine Überlastung als eine Kompromittierung ist, greifen andere Hebel. Das Blockieren von Werbung und Trackern auf DNS-Ebene kann den Web-Traffic um 20 bis 40 % reduzieren und Ladezeiten verkürzen, ohne dass Anpassungen auf den Endgeräten erforderlich sind (Reduzierung der Bandbreitennutzung). Dies ist eine praktische erste Maßnahme, da sie die Auslastung senkt, ohne die Client-Konfiguration zu verändern, während die stündliche Auslastung weiterhin zeigt, ob sich die Baseline selbst verschoben hat.
Beweise sichern ohne übermäßige Datenerfassung
Mehr Paketdaten bedeuten nicht automatisch mehr Sicherheit. Vollständige Aufzeichnungen erhöhen die Speicherkosten, das Datenschutzrisiko und den Arbeitsaufwand für Analysten - und verschlüsselte Nutzdaten lassen sich damit dennoch nicht lesen. Für jeden Datensatz sollte vielmehr eine konkretere Frage gestellt werden: Dient dies der Eindämmung, dem Schutz, einem Audit oder der Fehlerbehebung?
Sichtbarkeit geht oft unbemerkt verloren. Wenn DNS-Abfragen nicht auf unternehmenseigenen Servern terminieren, verlieren Unternehmen die Transparenz über Abfragen und schaffen tote Winkel für Datenexfiltration und Denial-of-Service-Aktivitäten (EfficientIP-Analyse der DNS-Infrastruktur). Dies spricht dafür, Resolver-Nachweise unter eigener Kontrolle zu behalten, anstatt wahllos alles mitzuschneiden.
Der vertretbare Mindestdatensatz:
- Zeitstempel und Netzwerk oder SSID, sodass jeder Datensatz einem Standort und einer Richtlinie zugeordnet ist.
- Richtlinienkategorie und ergriffene Maßnahme, einschließlich Sperrungen und der dem Nutzer angezeigten Erklärung.
- Abgefragte Domain, Bedrohungsklassifizierung und Systemstatus, was in der Regel ausreicht, um das Geschehen zu rekonstruieren.
- Keine vollständigen URLs, Payloads oder Browserverläufe, es sei denn, es liegt eine klare Rechtsgrundlage und eine definierte Aufbewahrungsfrist vor.
Aufbewahrung ist eine bewusste Entscheidung, kein Standardwert. Bewahren Sie zusammenfassende Flow- und DNS-Protokolle für einen festgelegten Zeitraum auf, halten Sie vollständige Erfassungen nur während eines aktiven Incidents vor und löschen Sie diese nach Abschluss des Falls.
Vor Beginn der Erfassung: wer die Protokolle einsehen darf, wie lange sie aufbewahrt werden und worüber Benutzer informiert wurden. Wenn Sie nicht alle drei Punkte beantworten können, handelt es sich eher um eine Speichergewohnheit als um eine Governance-Richtlinie.
Wenn DNS auch die Filterung übernimmt, liefert die Reporting-Ebene die entscheidenden Nachweise. Ein Leitfaden zu DNS-Filterungsprotokollen und Reporting lohnt sich vor dem Entwurf des Protokollformats, da das nachträgliche Ergänzen von Kategorien und Richtliniengründen in Protokolldateien äußerst aufwendig ist.
Wählen Sie Ihr erstes Monitoring-Setup
Wo Sie ansetzen, hängt davon ab, was Sie schützen - und öffentliche Netzwerke werden zunehmend zur Regel statt zur Ausnahme. Die Wireless Broadband Alliance berichtete 2025, dass 46 % der Befragten planten, 2025 oder 2026 stadtweites öffentliches WiFi bereitzustellen, während 15 % ein solches Netzwerk bereits eingerichtet hatten (WBA-Branchenbericht 2025).
Beginnen Sie bei einem kleinen Standort mit dem Flow-Export über den Router, DNS-Protokollen und einer zweiwöchigen Baseline. Erstellen Sie anschließend ein zentrales Dashboard, das Verbindungsauslastung, Top-Talker und den Anteil an NXDOMAIN anzeigt. Diese zentrale Ansicht klärt die meisten Beschwerden an Werktagen, ohne dass jemand eine Capture-Datei öffnen muss.
Fügen Sie für verteilte Standorte oder Campus-Umgebungen Ansichten pro SSID und pro VLAN, Zeitfenster-Schwellenwerte und ein Protokoll auf DNS-Ebene hinzu, das jede blockierte Domain mitsamt der angewendeten Richtlinie erfasst. Der Mehraufwand liegt in der Normalisierung, nicht in den Tools.
Behalten Sie für öffentliches oder Gäste-WiFi dieselbe Pro-SSID-Richtlinie und Protokollierung bei und informieren Sie Benutzer klar darüber, was wie lange protokolliert wird. Transparenz kostet nichts und entschärft die meisten Beschwerden, bevor sie ein Management erreichen.
Paketerfassung bleibt ein Werkzeug für aktive Vorfälle, kein permanenter Feed. Bewerten Sie die Einrichtung danach, wie schnell sie eine zentrale Frage beantwortet: Handelt es sich bei diesem Engpass um Kapazitätsprobleme, einen Gerätefehler oder eine Bedrohung?
Purple Shield läuft als schützendes DNS auf jedem WiFi-Netzwerk oder auf Purple-Access-Netzwerken mit jeweils individuellen Richtlinien; ein Netzwerk kann 30 Tage lang kostenlos geschützt werden.
Wählen Sie diese Woche ein Netzwerk aus, erfassen Sie dessen Spitzenzeit, vergleichen Sie diese mit derselben Stunde in der Baseline und notieren Sie den ersten Befund mit Zeitstempel, Host und Ziel. Dieses einzelne Dokument ist mehr wert als ein weiteres Dashboard.
Purple Shield beantwortet jede DNS-Abfrage in den geschützten Netzwerken. So wird eine Domain geprüft, bevor eine Verbindung aufgebaut wird, und das Dashboard zeigt übersichtlich, was blockiert wurde, welche Bedrohungen gestoppt wurden und wie das Netzwerk über Standorte und SSIDs hinweg genutzt wurde. Wenn Sie Vorfälle lieber anhand fundierter Lookup-Nachweise belegen möchten, anstatt rund um die Uhr eine aufwendige Paketerfassung zu betreiben, starten Sie mit der kostenlosen Testversion für ein einzelnes Netzwerk. Besuchen Sie Purple Shield, um zu erfahren, wie Richtlinien und Berichte pro SSID in Ihrer Umgebung aussehen würden.