
Analyser le trafic réseau : capturer, lire et résoudre les problèmes
Découvrez comment analyser le trafic réseau étape par étape : capturer des données, établir une référence, lire les flux chiffrés et identifier les problèmes de sécurité ou de performance.
Published 20 novembre 2026
Il est 14 h 10 un mardi et l'accueil a déjà appelé deux fois pour signaler des lenteurs sur le WiFi. Rien n'a été modifié durant la nuit. Les points d'accès sont opérationnels, le graphique de la liaison montante ressemble fortement à celui d'hier et le fournisseur indique que la ligne est impeccable. Vous disposez d'une vingtaine de minutes avant que l'on ne décide que l'incident incombe à l'équipe réseau.
Ces vingt minutes correspondent exactement à la raison d'être de l'analyse du trafic. Il ne s'agit pas de collecter chaque paquet, mais d'établir rapidement quelques certitudes : la liaison est-elle saturée ? Un appareil a-t-il un comportement anormal ? Un élément interne communique-t-il avec un hôte non autorisé ? Ou la réclamation concerne-t-elle simplement la couverture dans un recoin d'un bâtiment ?
L'ordre est essentiel. Définissez les bonnes métriques, effectuez une capture qui réponde à une question précise, établissez une référence de comparaison et conservez des registres que vous pourriez justifier sans difficulté.
Table des matières
- Indicateurs de trafic à surveiller et leur signification
- Comment capturer le trafic étape par étape
- Établir une base de référence pour un trafic normal
- Analyser le trafic lorsqu'il est chiffré
- Détecter les problèmes de sécurité et de performances
- Conserver des preuves sans surcollecter de données
- Choisir votre première configuration de surveillance
Les métriques de trafic à surveiller et leur signification
Un WiFi lent à 14 h signifie rarement que le réseau est en panne. Cela s'explique généralement par l'une des trois raisons suivantes : un pic de demande, un équipement isolé effectuant une action inhabituelle ou un hôte du réseau communiquant avec une destination suspecte. Vous pouvez faire la part des choses grâce à quelques indicateurs que vous collectez probablement déjà.
Le parc d'appareils rend la tâche plus complexe qu'auparavant. Les prévisions de Cisco pour la période 2017 à 2022 indiquaient que le trafic fixe et WiFi atteindrait 51 % du trafic IP total d'ici 2022, contre 43 % en 2017, et que les appareils non-PC généreraient 81 % du trafic IP mondial (prévisions des connexions mondiales par Cisco). Les téléphones, les Smart TV, les caisses enregistreuses et les automates de gestion technique de bâtiment représentent désormais l'essentiel du volume, et aucun d'entre eux ne figure dans un registre d'actifs.
| Indicateur | Ce qu'il révèle | Signal d'alerte |
|---|---|---|
| Utilisation de la liaison | Le niveau de saturation d'une liaison au fil du temps | Niveau soutenu au-dessus de 70-80 % de la capacité |
| Principaux émetteurs (Top talkers) | Hôtes ou SSID consommant le plus grand volume | Un appareil utilisant une part disproportionnée |
| Répartition des protocoles et des ports | La conformité du trafic avec les services attendus | Ports ou protocoles inattendus à grande échelle |
| Volume de requêtes DNS | Activité de résolution par hôte | Pics soudains ou résolutions répétées d'un même domaine |
| Part de réponses NXDOMAIN | Échecs de résolution de noms | Part en hausse, souvent liée à un malware ou à une mauvaise configuration |
| Nouvelles connexions par minute | Taux de création de sessions | Forte hausse évoquant un balayage ou une attaque par inondation |
| Retransmissions | Paquets perdus ou répétés | Supérieur à 1-2 % des paquets |
| Latence et gigue | Délai et amplitude de ses variations | Gigue qui perturbe les appels voix ou vidéo |
Considérez cette liste comme un ordre de tri, et non comme un tableau de bord. À 14 h, commencez par évaluer l'utilisation de la liaison sur l'heure écoulée et comparez-la à la même heure lors de semaines classiques. Si l'utilisation atteint son pic habituel et que les retransmissions sont normales, le problème est lié à la capacité, et la solution relève de la planification, du lissage du trafic ou d'une bande passante accrue plutôt que d'une traque aux logiciels malveillants.
Si l'utilisation n'a rien d'anormal et qu'un appareil domine le classement des plus gros consommateurs, c'est cet appareil que vous devez vérifier en priorité, et non la liaison montante. Si les retransmissions augmentent alors que l'utilisation reste stable, cessez d'analyser le trafic et commencez à inspecter l'infrastructure : un câble défaillant, une discordance de duplex ou un point d'accès subissant des interférences sur un canal saturé.
La règle qui met fin aux débats : aucune mesure isolée ne prouve quoi que ce soit. Un chiffre n'a de sens que par rapport à la plage habituelle du même site, à la même heure.
Comment capturer le trafic pas à pas
L'objectif est d'obtenir un échantillon représentatif, et non une copie du réseau. Vingt minutes enregistrées au bon moment valent mieux qu'une semaine de fichiers que personne n'ouvre, tout en restant suffisamment légères pour être transmises à un collègue.
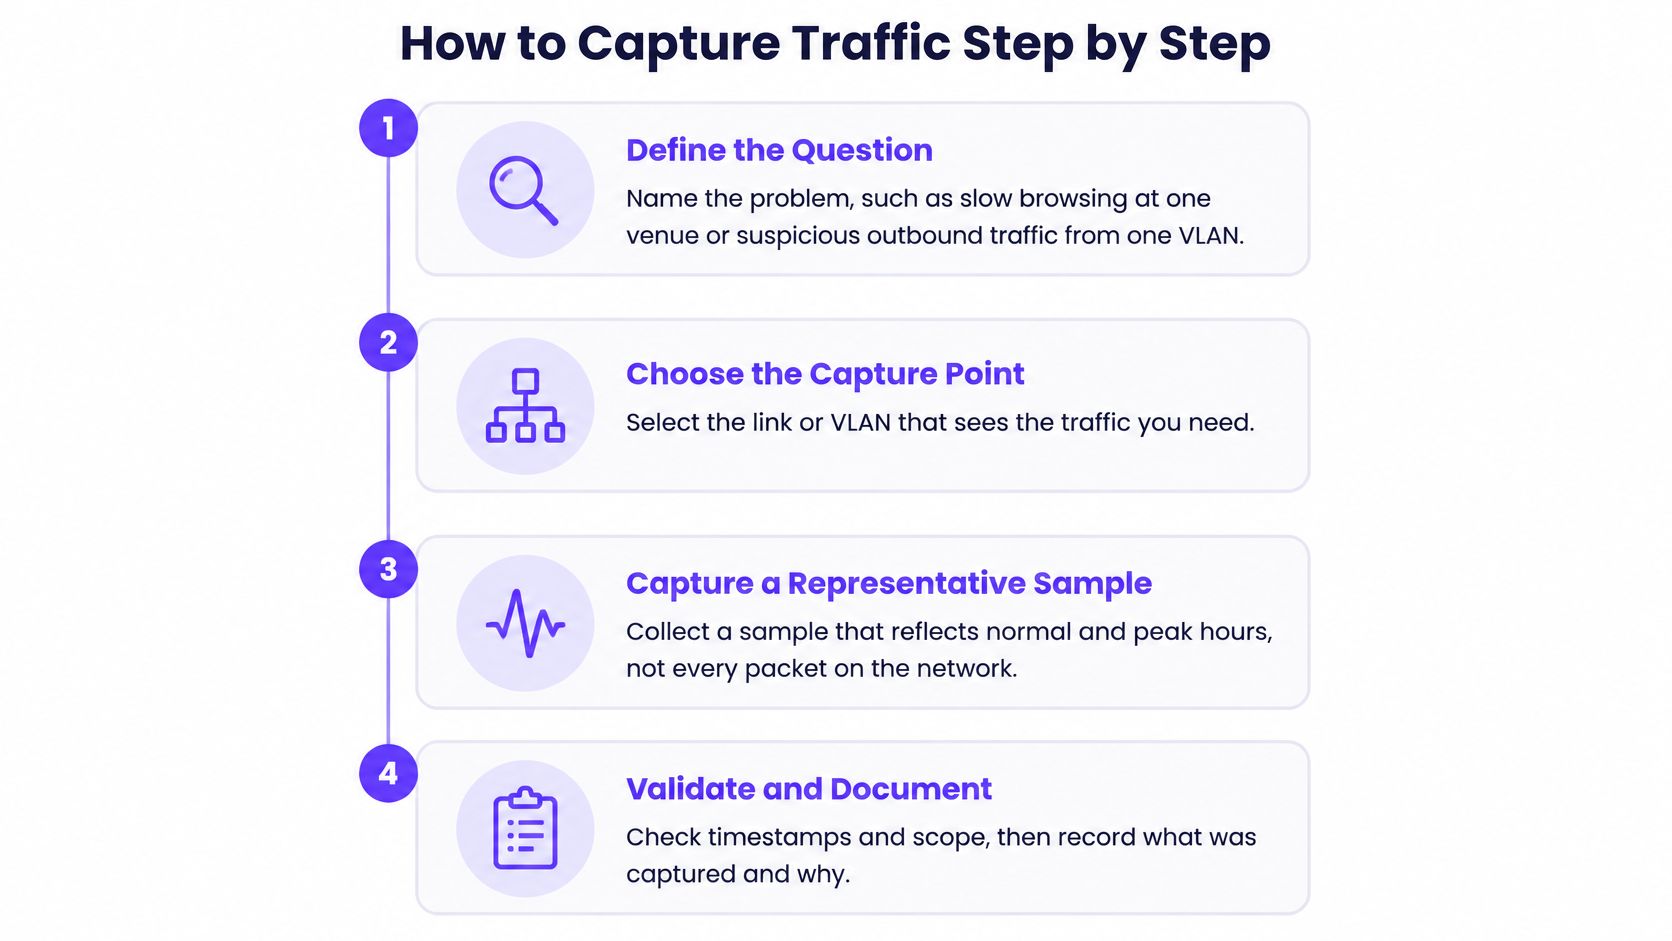
Définissez la question. "Navigation lente sur le réseau invité SSID sur un site" et "trafic sortant inattendu provenant du réseau de paiement VLAN" nécessitent des points de capture, des filtres et des durées différents. Notez la question par écrit avant de vous connecter à un commutateur. L'erreur classique consiste à capturer d'abord en espérant que la question apparaisse d'elle-même dans le fichier.
Choisissez un point qui voit les deux sens de transmission. Un port SPAN sur le commutateur, un TAP en ligne sur la liaison montante ou l'exportation de flux depuis le routeur ou le pare-feu. L'exportation de flux est le moyen le plus économique de surveiller un site en continu, et la capture de paquets est ce à quoi vous recourez lorsque les flux révèlent une anomalie. Mettre en miroir un port qui n'achemine qu'une seule direction ne vous donne que la moitié d'une conversation et un nombre de retransmissions sans signification.
Filtrez avant d'enregistrer. Délimitez la capture à un sous-réseau, un VLAN ou un hôte précis. Cela permet de garder un fichier suffisamment petit pour s'ouvrir en quelques secondes et vous évite de collecter le trafic du personnel et des invités qui ne sont pas concernés par le problème.
Capturez une fenêtre fixe. Quinze à trente minutes pendant l'heure de pointe, puis une capture plus courte pendant une période creuse. La paire permet d'effectuer des comparaisons ultérieurement ; une capture isolée n'est qu'une anecdote.
Indiquez le site, la date et l'heure dans le nom du fichier. Cela peut sembler dérisoire jusqu'à ce que vous ayez quarante captures entre les mains et soyez incapable de déterminer quel établissement a appelé.
Analysez à l'aide de filtres d'affichage, pas en faisant défiler l'écran. Commencez par la hiérarchie des protocoles et les conversations pour voir ce qui est présent, puis affinez sur les retransmissions ou les résolutions de noms. Faire défiler manuellement une capture dense est la meilleure façon de conclure à tort qu'il n'y a aucun problème.
Enregistrez le contexte avec le fichier. Point de capture, filtre, horodatage, retours des utilisateurs et éléments que vous avez déjà écartés.
Une habitude rend les données exploitables par la suite. Normalisez les flux par interface, SSID ou VLAN, site, fenêtre temporelle et direction, et prenez en compte le NAT, le routage asymétrique, le tunneling et les appareils partagés avant de définir le moindre seuil (guide de Vectra sur l'analyse du trafic chiffré). Le contexte réseau n'est pas un bruit parasite autour de l'analyse, il en fait partie intégrante.
Si vous souhaitez synthétiser toute la procédure sur une seule page pour l'équipe, voici la séquence :
| Point de capture | Idéal pour | Compromis |
|---|---|---|
| Port SPAN ou miroir | Capture de paquets d'un port ou d'un VLAN | Ne voit que le trafic mis en miroir et peut omettre une direction |
| TAP réseau | Capture intégrale des paquets sur une liaison unique | Matériel dédié ; capture les deux directions de manière fiable |
| Export de flux (NetFlow, sFlow, IPFIX) | Surveillance à long terme depuis un routeur ou un pare-feu | Solution la plus économique ; conserve les synthèses de flux, pas les paquets |
Établir une référence pour le trafic normal
Un chiffre ne devient un signal que lorsque vous savez ce qu'il représente habituellement. Les références de base sont souvent négligées car jugées rébarbatives, mais le coût se paie plus tard sous la forme d'une file d'alertes que tout le monde ignore.
Suivre les totaux en temps réel est la partie facile. Déterminer quels totaux sont anormaux pour cette heure précise sur ce site précis constitue l'autre partie du défi.
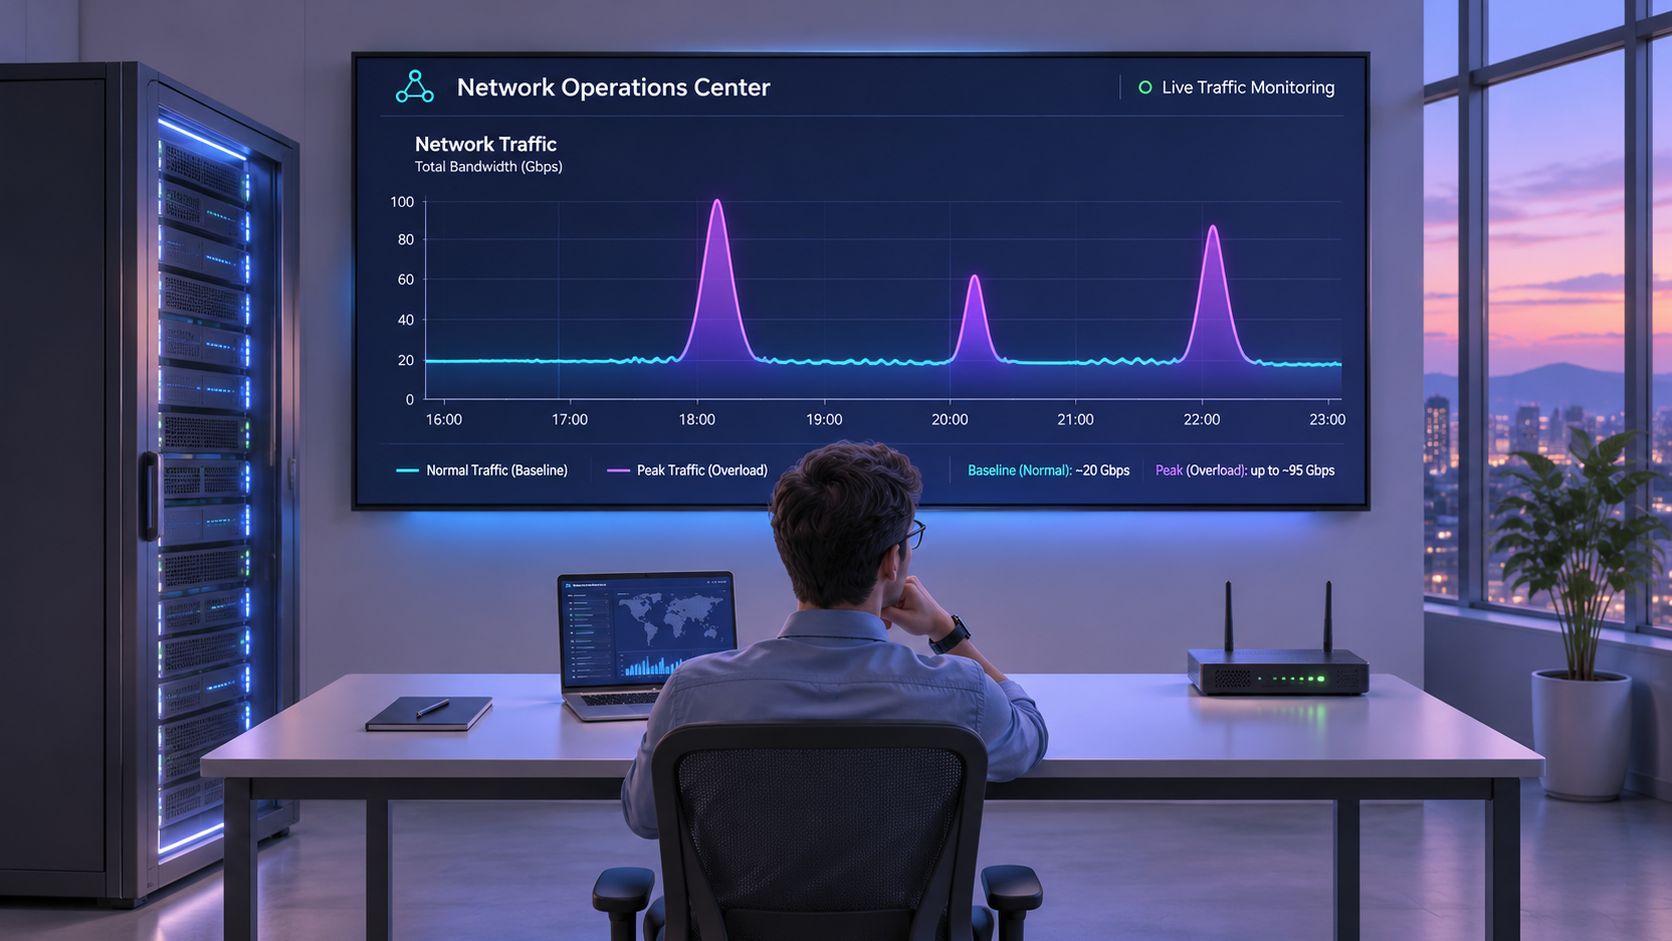
La croissance rend toute base de référence éphémère. Les prévisions de Cisco estimaient que le trafic IP mondial passerait de 122,4 exaoctets par mois en 2017 à 396,0 exaoctets par mois en 2022, soit un taux de croissance annuel composé de 26 %, et situaient le trafic aux heures de pointe à environ 7,2 pétabits par seconde contre une moyenne proche de 1 pétabit par seconde (Cisco Global IP Traffic Forecast). C'est l'écart entre moyenne et pic qui sature les liaisons.
Cette progression ne s'est pas stabilisée. Cloudflare Radar a mesuré une croissance de 17,2 % du trafic Internet mondial en 2024 (Cloudflare Radar : bilan 2024), ce qui suffit à rendre une référence vieille de deux ans représentative d'un réseau qui n'existe plus.
Ce qu'il faut enregistrer chaque heure
- Volume par SSID et VLAN, et pas seulement par liaison montante, car une liaison stable masque le segment qui a progressé.
- Taux de requêtes DNS et part de NXDOMAIN, mesurés pour mille requêtes afin que le ratio reste cohérent malgré la croissance du trafic.
- Principales destinations et nouvelles connexions par minute, suivies selon l'heure de la semaine plutôt que de la journée.
- Contexte calendaire, pour qualifier les trimestres scolaires, soirées événementielles et profils hôteliers de week-end au lieu de les traiter comme des anomalies.
Établissez-la sur au moins deux semaines, en couvrant les comportements en semaine et le week-end, ainsi que les heures de pointe et les heures creuses. Définissez des seuils par heure de la semaine, afin qu'un pic le vendredi soir dans un hôtel ne déclenche pas un incident tous les sept jours.
Trois jours consécutifs en dehors de la plage normale pour la même heure justifient une analyse. Une anomalie isolée correspond généralement à la diffusion d'un match, au déploiement d'un logiciel ou à la retransmission d'une conférence, et doit faire l'objet d'une simple note plutôt que d'une escalade.
Analyser le trafic lorsqu'il est chiffré
TLS 1.3, QUIC sur UDP/443, HTTP/3, les VPN et le DNS chiffré ont rendu la plupart des charges utiles inaccessibles. Tout plan reposant sur la lecture du contenu des pages est désormais voué à décevoir la personne qui l'a demandé.
Le tableau de bord demeure utile. Il permet simplement de répondre à des questions différentes de celles d'auparavant.
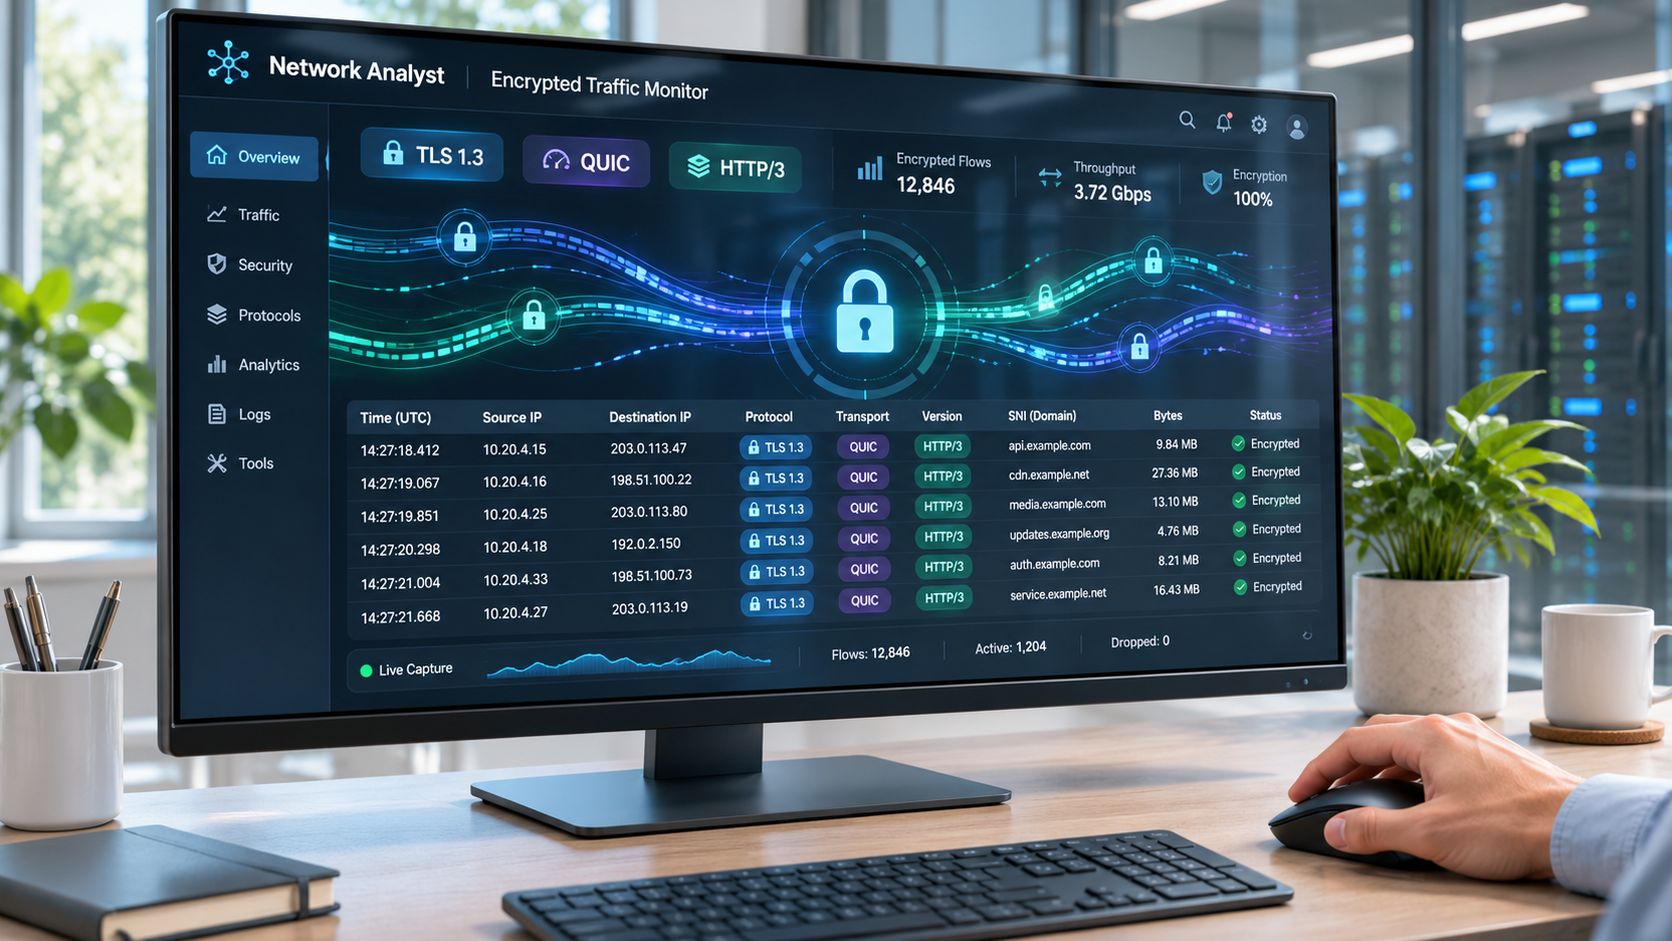
Les métadonnées en disent plus long qu'il n'y paraît. Des chercheurs ayant entraîné un modèle sur 500 sites compatibles QUIC ont identifié 70 % des sites web surveillés avec une précision de 90 % à l'aide des seuls paquets DNS, un résultat qui atteint environ 80 % de rappel pour 90 % de précision lorsque le DNS-over-QUIC était combiné au trafic HTTP/3 (recherche de l'A*STAR sur le trafic chiffré). La taille des paquets, leur cadence et leur direction transmettent encore de nombreuses informations.
Ces données permettent de détecter des anomalies, de classifier des applications et de trier les menaces. En revanche, elles ne permettent pas d'affirmer ce qu'une personne a lu, saisi ou eu l'intention de faire. Établissez clairement cette distinction avant que quiconque ne promette à un responsable un rapport sur le contenu de la navigation.
Pour découvrir concrètement ce qui subsiste au chiffrement dans une véritable capture :
L'évaluation est l'étape où les travaux sur le trafic chiffré échouent généralement. Séparez les données d'entraînement et de test par flux complets et non par paquets, car une séparation par paquets laisse fuiter des données de session quasi identiques dans les deux ensembles ; une évaluation récente a chuté à à peine 40 % de précision dès lors qu'une séparation au niveau des flux a été appliquée (évaluation de la classification du trafic chiffré sur arXiv).
Les journaux des résolveurs ne valent que par le point de terminaison du DNS. Si une partie de votre parc se connecte à des résolveurs DNS chiffrés et des points de terminaison DoH que vous ne maîtrisez pas, documentez cet écart au lieu de prétendre à une visibilité dont vous ne disposez pas.
Détecter les problèmes de sécurité et de performance
Un hôte envoyant des signaux à un domaine de commande et de contrôle et un hôte saturant une liaison se ressemblent sur un tableau de bord. Tous deux génèrent du trafic. Ils nécessitent des vérifications initiales distinctes, et une mauvaise supposition peut faire perdre la première heure.
Les menaces sur un réseau sont suffisamment fréquentes pour être anticipées. Akamai a indiqué en 2023 qu'entre 10 % et 16 % des organisations ont été confrontées à du trafic de commande et contrôle (C2) sur leurs réseaux au cours d'un trimestre donné (étude d'Akamai sur le trafic DNS malveillant). Le beaconing étant conçu pour ressembler à une navigation ordinaire, c'est son schéma récurrent qui permet de le détecter, plutôt que son volume.
| Symptôme | Cause probable | Première vérification |
|---|---|---|
| Navigation lente aux heures de pointe | Saturation de la liaison | Utilisation par heure par rapport à la référence |
| Petites connexions régulières vers un domaine inconnu | Balises de commande et de contrôle (C2) | Intervalle de connexion et historique DNS pour l'hôte |
| Téléversement volumineux depuis un hôte la nuit | Exfiltration ou sauvegarde non planifiée | Volume sortant habituel de l'hôte |
| Pic de réponses NXDOMAIN | Requêtes liées à un malware ou défaillance du résolveur | Domaines les plus interrogés et journaux du résolveur |
| Augmentation des retransmissions avec une utilisation normale | Câble défectueux ou interférences WiFi | Compteurs d'erreurs et pertes par point d'accès |
| Résolutions répétées d'un domaine par de nombreux hôtes | Application compromise ou appareil mal configuré | Hôtes sources et réputation de la destination |
À quoi ressemble le beaconing dans un enregistrement de flux
Un appareil contactant un domaine à intervalles réguliers, avec des tailles de requêtes et de réponses faibles et constantes, ne ressemble en rien au schéma diurne de ce même hôte. Extrayez les intervalles de connexion et l'historique DNS de cet hôte avant de bloquer quoi que ce soit. Une smart TV vérifiant les mises à jour de firmware selon un calendrier fixe présentera le même profil et vous fera perdre une journée de travail.
Des transferts sortants volumineux pendant la nuit doivent susciter de la mise en contexte plutôt que de l'affolement. Comparez le volume sortant de l'hôte à ses niveaux habituels, puis vérifiez si une fenêtre de sauvegarde a été modifiée ou si un nouveau client de synchronisation cloud a été installé. La question pertinente est de savoir si ce transfert est inhabituel pour cet hôte, et non s'il est volumineux en valeur absolue.
Consultez la liste de blocage et le flux de renseignements sur les menaces avant d'incriminer le réseau. Enregistrez le résultat avec l'horodatage, l'hôte et la destination afin que l'intervenant suivant puisse le vérifier plutôt que de refaire l'analyse. Ces éléments factuels vous permettent également de prouver ce qui a été bloqué, au lieu d'argumenter sur la base d'une alerte imprécise.
Lorsque le problème s'avère être une congestion plutôt qu'une compromission, les leviers d'action changent. Le blocage des publicités et des traqueurs au niveau du DNS peut réduire le trafic web de 20 à 40 % et accélérer le chargement des pages, sans nécessiter la moindre modification sur les appareils (Réduire l'utilisation de la bande passante). C'est une première vérification pragmatique, car elle diminue la demande sans toucher à la configuration des clients, tandis que l'utilisation heure par heure permet de vérifier si la référence de base a elle-même évolué.
Conserver des preuves sans collecter de données superflues
Davantage de données de paquets ne garantit pas automatiquement une meilleure sécurité. Les captures intégrales augmentent les coûts de stockage, les risques d'exposition des données privées et la charge de travail des analystes, sans pour autant permettre de lire une charge utile chiffrée. La question pertinente à poser pour chaque enregistrement est plus ciblée : cela contribue-t-il au confinement, à la protection, à un audit ou au dépannage ?
La visibilité a tendance à s'effacer facilement. Lorsque le DNS ne termine pas sur des serveurs contrôlés par l'entreprise, les organisations perdent la visibilité sur les requêtes et créent des angles morts favorables aux activités d'exfiltration et de déni de service (analyse de l'infrastructure DNS par EfficientIP). Cela plaide en faveur d'un contrôle direct de vos traces de résolveurs, plutôt que d'une capture systématique de l'ensemble du trafic.
L'ensemble minimal défendable :
- Horodatage et réseau ou SSID, afin que chaque enregistrement soit associé à un lieu et à une politique.
- Catégorie de politique et mesure appliquée, y compris les blocages et les explications présentées à l'utilisateur.
- Domaine interrogé, classification des menaces et état du système, ce qui suffit généralement à reconstituer les faits.
- Pas les URL complètes, les charges utiles ou les historiques de navigation, sauf en cas de base juridique claire et de durée de conservation définie.
La rétention relève d'une décision, et non d'une option par défaut. Conservez les journaux récapitulatifs des flux et du DNS pendant une durée déterminée, ne gardez les captures complètes que pendant la durée d'un incident actif et supprimez-les une fois le dossier clos.
Avant de commencer la collecte : qui peut consulter les journaux, combien de temps ils sont conservés et ce qui a été communiqué aux utilisateurs. Si vous ne pouvez pas répondre à ces trois questions, vous avez une habitude de stockage plutôt qu'une politique de gouvernance.
Lorsque le DNS effectue également le filtrage, la couche de reporting fournit l'essentiel des éléments de preuve. Il est utile de consulter un guide sur les journaux et le reporting du filtrage DNS avant de concevoir le format des enregistrements, car réintégrer a posteriori des catégories et des motifs de politique dans les journaux s'avère fastidieux.
Choisir votre première configuration de surveillance
Votre point de départ dépend de ce que vous protégez, et les réseaux publics deviennent la norme plutôt que l'exception. La Wireless Broadband Alliance a indiqué en 2025 que 46 % des répondants prévoyaient de déployer un WiFi public à l'échelle de la ville en 2025 ou 2026, tandis que 15 % avaient déjà déployé un tel réseau (rapport sectoriel WBA 2025).
Pour un petit bureau, commencez par exporter les flux du routeur, les journaux DNS et une référence sur deux semaines, puis créez un tableau de bord unique indiquant l'utilisation des liaisons, les équipements les plus actifs et la proportion de requêtes NXDOMAIN. Cette vue unique répond à la majorité des réclamations en semaine, sans nécessiter l'ouverture d'un fichier de capture.
Pour un campus ou un site multisite, ajoutez des vues par SSID et par VLAN, des seuils de fenêtres temporelles, ainsi qu'un journal de couche DNS qui consigne chaque domaine bloqué avec la règle appliquée. Le travail supplémentaire réside dans la normalisation, pas dans les outils.
Pour le WiFi public ou invité, conservez la même politique et la même journalisation par SSID, et informez clairement les utilisateurs de ce qui est consigné et pendant combien de temps. La transparence ne coûte rien et désamorce la plupart des réclamations avant qu'elles n'atteignent un responsable.
La capture de paquets doit rester un outil pour les incidents actifs, et non un flux permanent. Évaluez la configuration en mesurant la rapidité avec laquelle elle répond à une question : cette période de ralentissement est-elle due à la capacité, à une défaillance matérielle ou à une menace ?
Purple Shield fonctionne comme un DNS protecteur sur n'importe quel réseau WiFi ou sur les réseaux Purple Access, avec une politique propre à chacun, et un réseau peut être protégé gratuitement pendant 30 jours.
Choisissez un réseau cette semaine, capturez son heure de pointe, comparez-la à la même heure dans la référence et consignez la première observation avec son horodatage, son hôte et sa destination. Ce seul document a plus de valeur qu'un énième tableau de bord.
Purple Shield répond à chaque requête DNS sur les réseaux qu'elle protège, de sorte qu'un domaine est vérifié avant l'ouverture d'une connexion. Le tableau de bord affiche les éléments bloqués, les menaces neutralisées et l'utilisation du réseau sur l'ensemble des sites et des SSID. Si vous préférez établir ce qui s'est passé à partir des éléments de requêtes plutôt que d'exécuter une capture continue de paquets, commencez par l'essai gratuit pour un réseau. Consultez Purple Shield pour découvrir les stratégies et les rapports par SSID sur votre parc.