
Analizzare il traffico di rete: acquisire, leggere e risolvere i problemi
Scoprite come analizzare il traffico di rete passo dopo passo: acquisire dati, creare una baseline, leggere i flussi crittografati e individuare problemi di sicurezza o prestazioni.
Published 20 novembre 2026
Sono le 14:10 di martedì e la reception ha già chiamato due volte per segnalare un rallentamento della rete WiFi. Durante la notte non è stato modificato nulla. Gli access point sono attivi, il grafico dell'uplink è pressoché identico a quello di ieri e il provider conferma che la linea funziona correttamente. Ha circa venti minuti prima che qualcuno decida che la responsabilità del problema ricade sul team di rete.
Questi venti minuti rappresentano proprio lo scopo dell'analisi del traffico. Non raccogliere ogni pacchetto, bensì verificare rapidamente un insieme mirato di elementi: se il collegamento è saturo, se un dispositivo mostra comportamenti anomali, se un elemento interno comunica con un host non autorizzato, o se la segnalazione riguarda in realtà la copertura in un angolo dell'edificio.
L'ordine è fondamentale. Definisca correttamente le metriche, esegua un'acquisizione mirata a rispondere a una specifica domanda, crei una baseline di confronto e conservi registri che sia in grado di giustificare e difendere con sicurezza.
Sommario
- Metriche di traffico da monitorare e relativo significato
- Come acquisire il traffico passo dopo passo
- Definizione di una baseline per il traffico normale
- Interpretazione del traffico cifrato
- Individuazione dei problemi di sicurezza e prestazioni
- Conservazione delle evidenze senza raccogliere dati in eccesso
- Scelta della prima configurazione di monitoraggio
Metriche di traffico da monitorare e il loro significato
Una connessione WiFi lenta alle 14:00 raramente indica un guasto della rete. Di solito significa una di queste tre cose: un picco di domanda, un singolo dispositivo che ha iniziato a fare qualcosa di insolito oppure un host sulla rete che ha iniziato a comunicare con una destinazione non consentita. È possibile distinguere queste eventualità grazie a una serie di dati che probabilmente raccoglie già.
La popolazione di dispositivi rende tutto questo più difficile rispetto al passato. Le previsioni di Cisco per il periodo 2017-2022 stimavano che il traffico fisso e WiFi avrebbe raggiunto il 51% del traffico IP complessivo entro il 2022, rispetto al 43% del 2017, e che i dispositivi non-PC avrebbero generato l'81% del traffico IP globale (previsioni sulle connessioni globali di Cisco). Telefoni, smart TV, casse e controllori degli edifici gestiscono ormai la maggior parte del volume, e nessuno di essi compare in un registro delle risorse.
| Metrica | Cosa rivela | Segnale di avviso |
|---|---|---|
| Utilizzo del collegamento | Livello di carico di un collegamento nel tempo | Valore costantemente superiore al 70-80% della capacità |
| Top talker | Host o SSID che generano il maggior volume | Un dispositivo che utilizza una quota sproporzionata |
| Mix di protocolli e porte | Se il traffico corrisponde ai servizi previsti | Porte o protocolli imprevisti su larga scala |
| Volume delle query DNS | Attività di risoluzione per host | Picchi improvvisi o query ripetute per un unico dominio |
| Percentuale NXDOMAIN | Errori di risoluzione dei nomi | Percentuale in aumento, spesso indice di malware o errori di configurazione |
| Nuove connessioni al minuto | Tasso di creazione delle sessioni | Forte aumento indicativo di scansioni o flooding |
| Ritrasmissioni | Pacchetti persi o ripetuti | Superiore all'1-2% dei pacchetti |
| Latenza e jitter | Ritardo e relativa variabilità | Jitter che interrompe le chiamate vocali o video |
Consideri tale elenco come un ordine di priorità per il triage, non come una scheda di valutazione. Alle 14:00, inizi dall'utilizzo del collegamento per quell'ora e lo confronti con la stessa ora nelle settimane ordinarie. Se l'utilizzo raggiunge il consueto picco e le ritrasmissioni sono regolari, la causa risiede nella capacità; la soluzione consisterà dunque in pianificazione, traffic shaping o maggiore larghezza di banda, anziché nella ricerca di malware.
Se l'utilizzo non mostra anomalie e un solo dispositivo domina tra i top talker, il controllo successivo deve riguardare quel dispositivo, non l'uplink. Se le ritrasmissioni aumentano mentre l'utilizzo rimane invariato, interrompa l'analisi del traffico e inizi a ispezionare l'infrastruttura: un cavo malfunzionante, un mismatch di duplex o un access point che contrasta le interferenze su un canale congestionato.
La regola che chiude ogni discussione: una singola misurazione non prova nulla. Un valore acquista significato solo se confrontato con i parametri normali della stessa sede alla medesima ora.
Come acquisire il traffico passo dopo passo
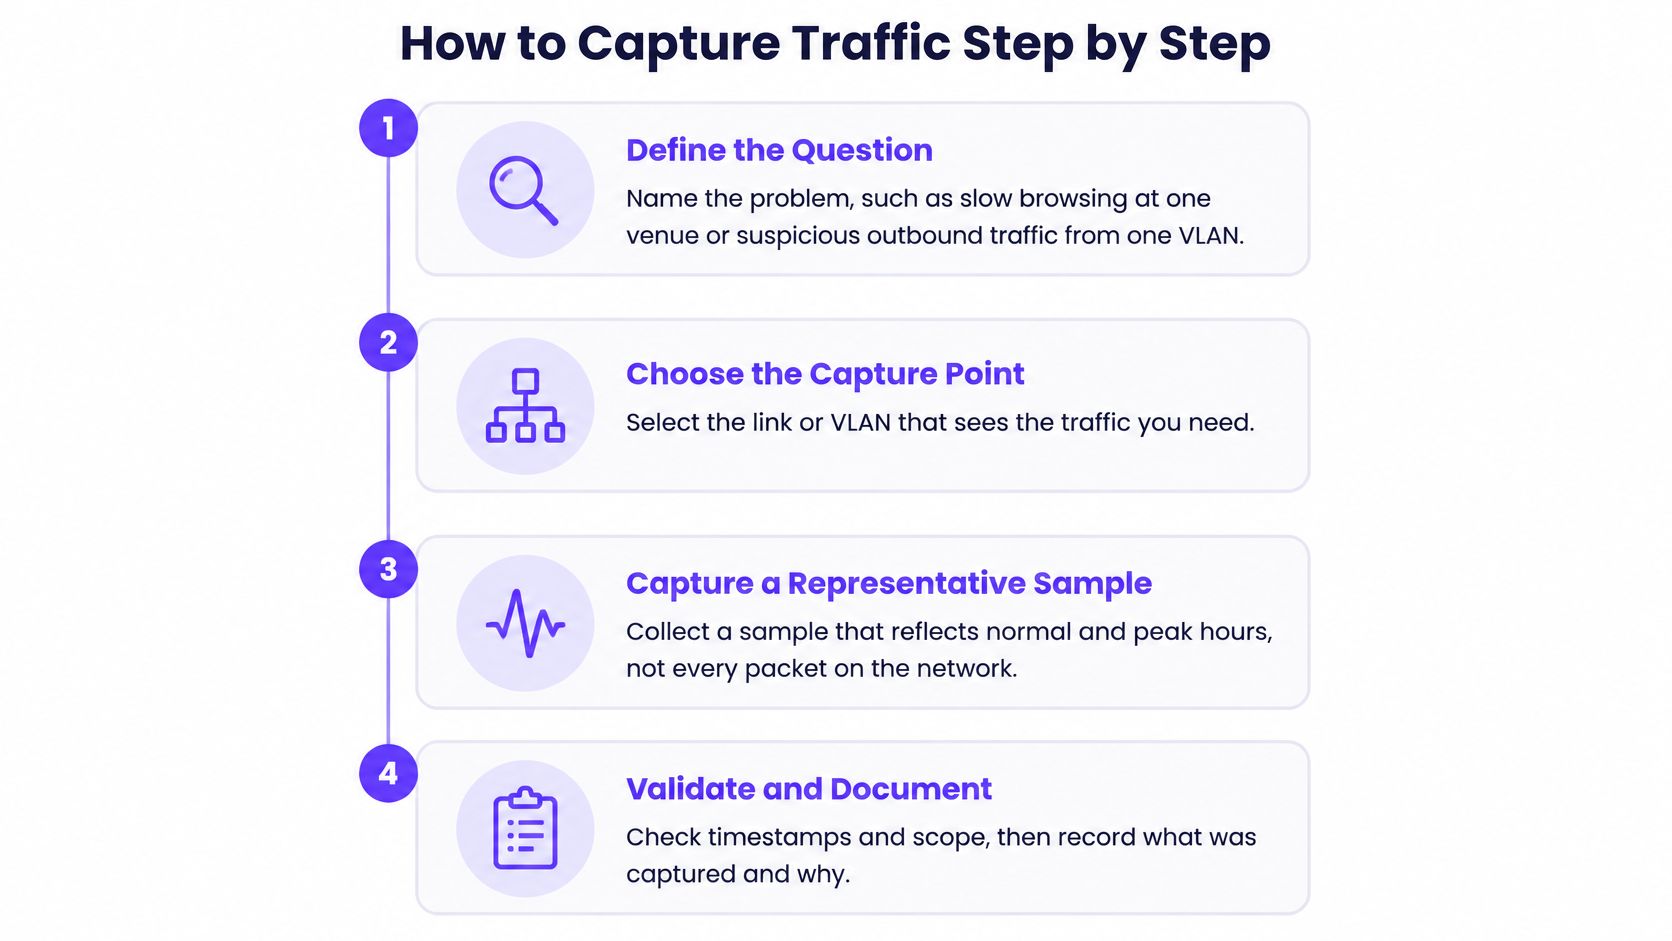
L'obiettivo è un campione rappresentativo, non una copia della rete. Venti minuti acquisiti al momento giusto valgono più di una settimana di file che nessuno aprirà mai, e le dimensioni rimangono sufficientemente ridotte da poter essere inviate a un collega.
Definire la questione. "Navigazione lenta sulla rete SSID guest in una sede" e "traffico in uscita imprevisto dalla rete VLAN dei pagamenti" richiedono punti di acquisizione, filtri e durate differenti. Mettere per iscritto il quesito prima di accedere a uno switch. L'errore comune consiste nell'avviare prima l'acquisizione sperando che la risposta emerga spontaneamente dal file.
Scegliere un punto che monitori entrambe le direzioni. Una porta SPAN sullo switch, un TAP inline sull'uplink o l'esportazione dei flussi (flow export) dal router o firewall. L'esportazione dei flussi rappresenta la soluzione più economica per monitorare un sito in modo continuo, mentre l'acquisizione dei pacchetti è lo strumento a cui ricorrere quando i flussi evidenziano anomalie. Il mirroring di una porta che trasporta una sola direzione restituisce solo mezza conversazione e un conteggio delle ritrasmissioni privo di significato.
Filtrare prima di registrare. Delimitare l'acquisizione a una singola subnet, VLAN o host. In questo modo il file rimane abbastanza piccolo da aprirsi in pochi secondi ed evita di raccogliere traffico di personale e ospiti estranei al problema.
Acquisire una finestra temporale fissa. Da quindici a trenta minuti durante l'ora di punta, seguiti da un'acquisizione più breve durante un periodo di scarso traffico. Il confronto tra le due rilevazioni consentirà analisi successive approfondite; una singola acquisizione rimane solo un dato aneddotico.
Includere sede, data e ora nel nome del file. Può sembrare banale finché non ci si ritrova con quaranta acquisizioni senza riuscire a distinguere quale sede abbia segnalato il problema.
Analizzare con i filtri di visualizzazione, non scorrendo i dati. Iniziare da Protocol Hierarchy e Conversations per identificare i protocolli presenti, quindi concentrarsi sulle ritrasmissioni o sulle risoluzioni dei nomi. Scorrere manualmente un'acquisizione complessa porta spesso all'errata conclusione che non vi sia alcun problema.
Registrare il contesto insieme al file. Punto di acquisizione, filtro applicato, orario, segnalazioni degli utenti ed elementi già esclusi.
Una sola abitudine rende i dati utilizzabili in seguito. Normalizzi i flussi per interfaccia, SSID o VLAN, sito, finestra temporale e direzione, e tenga conto di NAT, instradamento asimmetrico, tunneling e dispositivi condivisi prima di impostare qualsiasi soglia (guida di Vectra all'analisi del traffico crittografato). Il contesto di rete non è rumore di fondo attorno all'analisi: ne è parte integrante.
Se desidera l'intera procedura riassunta in un'unica pagina per il team, ecco la sequenza:
| Punto di acquisizione | Ideale per | Compromesso |
|---|---|---|
| Porta SPAN o mirror | Cattura dei pacchetti di una porta o di una VLAN | Rileva solo il traffico sottoposto a mirroring e può tralasciare una direzione |
| Network TAP | Cattura completa dei pacchetti su un singolo collegamento | Hardware dedicato; cattura entrambe le direzioni in modo affidabile |
| Esportazione dei flussi (NetFlow, sFlow, IPFIX) | Monitoraggio a lungo termine da router o firewall | La soluzione più economica; conserva i riepiloghi dei flussi, non i pacchetti |
Creare una baseline per il traffico normale
Un numero diventa un segnale solo quando si conosce il suo valore abituale. Spesso le baseline vengono ignorate perché noiose, ma il conto si presenta in seguito sotto forma di una sequenza di avvisi che tutti finiscono per silenziare.
Monitorare i totali in tempo reale è la parte facile. Riconoscere quali totali siano anomali per questa specifica ora su questo sito è l'altra metà dell'opera.
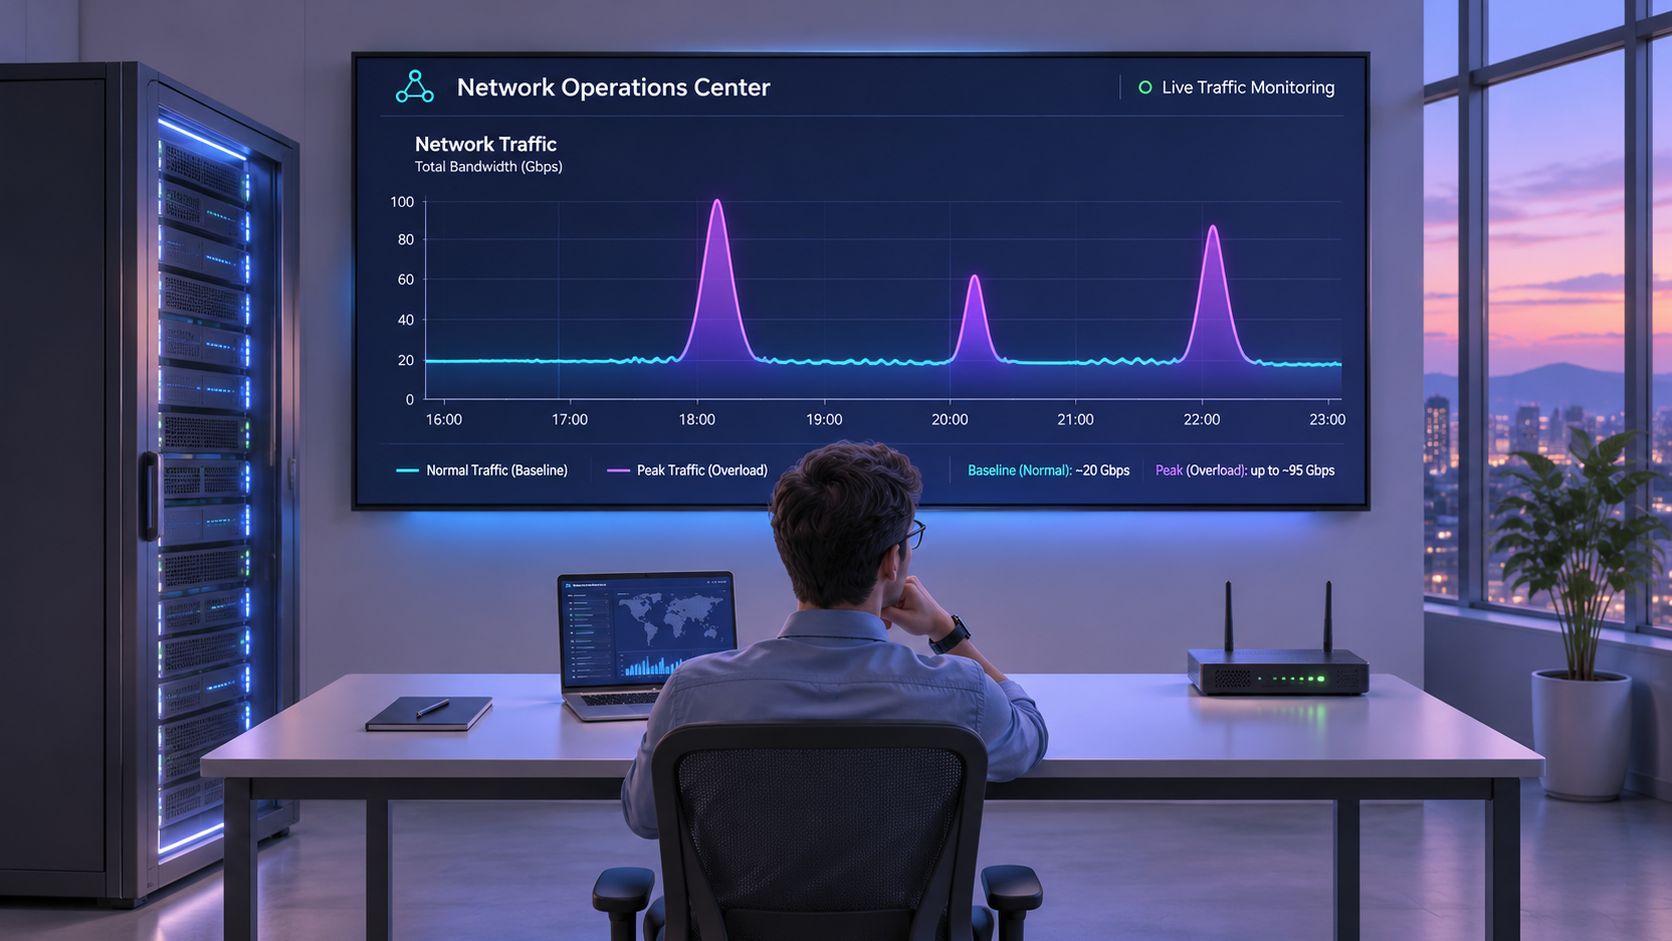
La crescita rende deperibile qualsiasi baseline. Le previsioni di Cisco stimavano che il traffico IP globale sarebbe salito da 122,4 exabyte al mese nel 2017 a 396,0 exabyte al mese nel 2022, con un tasso di crescita annuo composto del 26%, indicando un traffico nelle ore di punta di circa 7,2 petabit al secondo a fronte di una media vicina a 1 petabit al secondo (Cisco Global IP Traffic Forecast). Il divario tra la media e il picco è ciò che causa il collasso dei collegamenti.
La crescita non si è stabilizzata. Cloudflare Radar ha rilevato una crescita del 17,2% nel traffico Internet globale nel corso del 2024 (Cloudflare Radar 2024 in review), una variazione sufficiente a far sì che una baseline di due anni fa descriva una rete ormai inesistente.
Cosa registrare ogni ora
- Volume per SSID e VLAN, non solo per uplink, poiché un uplink uniforme nasconde il segmento cresciuto di volume.
- Frequenza delle query DNS e percentuale di NXDOMAIN, misurate per mille ricerche in modo che la proporzione regga la crescita del traffico.
- Principali destinazioni e nuove connessioni al minuto, registrate in base all'ora della settimana anziché del giorno.
- Contesto temporale e di calendario, per etichettare periodi scolastici, serate di eventi e tendenze alberghiere del fine settimana invece di trattarli come anomalie.
Esegua la creazione su almeno due settimane, coprendo il comportamento nei giorni feriali e nel fine settimana, sia nelle ore di punta sia in quelle di minor traffico. Imposti soglie per ora della settimana, in modo che un picco del venerdì sera in un hotel non generi un incidente ogni sette giorni.
Tre giorni consecutivi al di fuori della norma per la stessa fascia oraria meritano un'analisi approfondita. Un singolo valore anomalo è solitamente dovuto a uno streaming di una partita, al rilascio di un software o al keynote di una conferenza, ed è opportuno registrarlo nelle note piuttosto che avviare un'escalation.
Leggere il traffico quando è crittografato
TLS 1.3, QUIC su UDP/443, HTTP/3, VPN e DNS crittografato hanno reso la maggior parte dei payload inaccessibile. Qualsiasi piano basato sulla lettura dei contenuti delle pagine è ormai destinato a deludere chi lo ha richiesto.
La dashboard rimane utile: risponde semplicemente a domande diverse rispetto al passato.
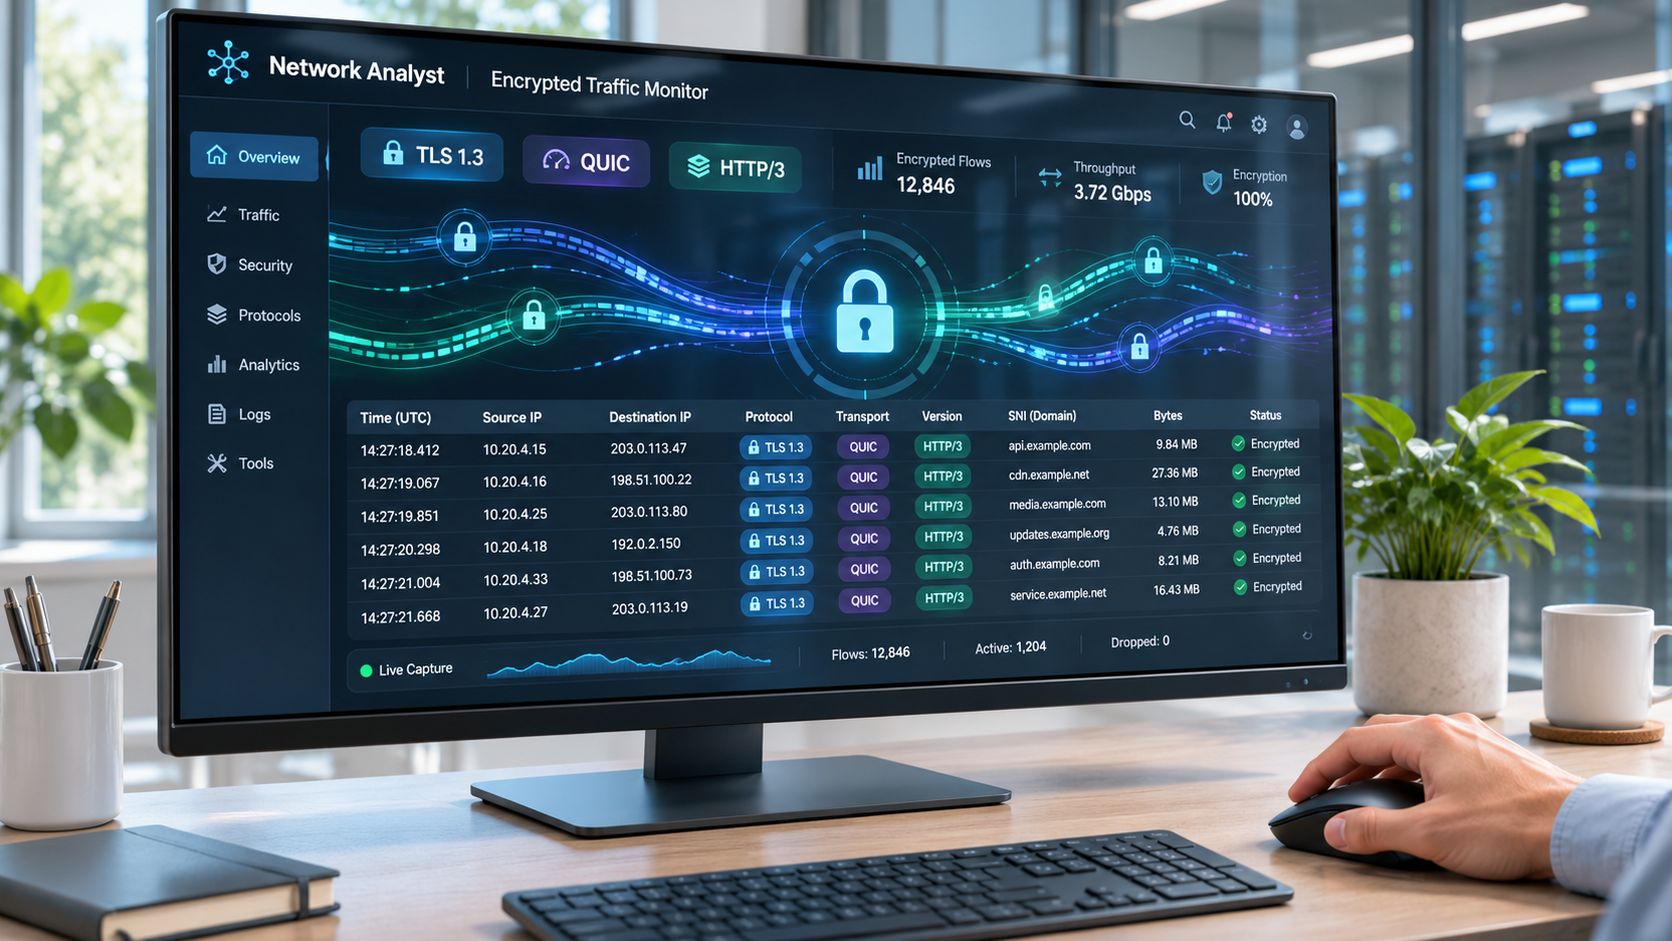
I metadati sono più rivelatori di quanto sembri. Ricercatori che hanno addestrato un modello su 500 siti abilitati a QUIC hanno identificato il 70% dei siti web monitorati con una precisione del 90% utilizzando i soli pacchetti DNS, salendo a circa l'80% di recall con una precisione del 90% combinando DNS-over-QUIC con il traffico HTTP/3 (ricerca A*STAR sul traffico crittografato). Dimensioni dei pacchetti, tempistiche e direzione trasmettono comunque molte informazioni.
Ciò che questo approccio supporta è il rilevamento delle anomalie, la classificazione delle applicazioni e il triage delle minacce. Ciò che non supporta è un'affermazione su ciò che un utente ha letto, digitato o inteso fare. Renda esplicita questa distinzione prima che qualcuno prometta a un responsabile un report sui contenuti di navigazione.
Per una guida dettagliata su quanto rimane visibile dopo la crittografia in un'acquisizione reale:
La fase di valutazione è quella in cui il lavoro sul traffico crittografato di solito fallisce. È opportuno suddividere i dati di addestramento e di test per flusso completo, non per pacchetto, poiché la suddivisione per singolo pacchetto riversa dati di sessione quasi identici in entrambi i set; una recente valutazione è scesa a appena il 40% di accuratezza una volta applicata la separazione a livello di flusso (valutazione della classificazione del traffico crittografato su arXiv).
I log del resolver sono affidabili solo in base a dove termina il DNS. Se una parte dell'infrastruttura raggiunge resolver DNS crittografati ed endpoint DoH che non controlla, documenti questa discrepanza invece di descrivere una visibilità che non possiede.
Individuare problemi di sicurezza e di prestazioni
Un host che invia beacon a un dominio di comando e controllo e un host che satura un collegamento appaiono simili su una dashboard. Entrambi generano traffico. Richiedono verifiche iniziali diverse e un'ipotesi errata può far perdere la prima ora.
Le minacce su una rete sono abbastanza frequenti da richiedere una pianificazione preventiva. Akamai ha riferito nel 2023 che tra il 10% e il 16% delle organizzazioni ha rilevato traffico di comando e controllo sulle proprie reti in un dato trimestre (ricerca Akamai sul traffico DNS dannoso). Il beaconing è concepito per somigliare alla normale navigazione, pertanto viene identificato tramite l'analisi dei pattern piuttosto che per volume.
| Sintomo | Causa probabile | Prima verifica |
|---|---|---|
| Navigazione lenta nelle ore di punta | Saturazione del collegamento | Utilizzo orario a confronto con la baseline |
| Piccole connessioni regolari verso un dominio sconosciuto | Beaconing di comando e controllo (C2) | Intervallo di connessione e cronologia DNS dell'host |
| Upload consistente da un host durante la notte | Esfiltrazione o backup non pianificato | Volume di traffico in uscita regolare dell'host |
| Picco di risposte NXDOMAIN | Query di malware o anomalia del resolver | Domini più richiesti e log del resolver |
| Aumento delle ritrasmissioni con utilizzo regolare | Cavo difettoso o interferenza WiFi | Contatori di errore e pacchetti persi per AP |
| Risoluzioni ripetute di un unico dominio da parte di molti host | Applicazione compromessa o dispositivo configurato in modo errato | Host di origine e reputazione della destinazione |
Come si presenta il beaconing in un record di flusso
Un dispositivo che contatta un unico dominio a intervalli regolari, con dimensioni di richiesta e risposta ridotte e costanti, ha un aspetto del tutto diverso dal modello diurno dello stesso host. Estrapoli gli intervalli di connessione e la cronologia DNS per tale host prima di bloccare qualsiasi elemento. Una smart TV che verifica la disponibilità di aggiornamenti firmware secondo una pianificazione fissa replicherà lo stesso schema e Le farà sprecare un'intera giornata.
I caricamenti di grandi dimensioni durante la notte richiedono contesto piuttosto che allarmismo. Confronti il volume in uscita dell'host rispetto ai suoi valori standard, quindi verifichi se la finestra di backup è stata spostata o se è stato installato un nuovo client di sincronizzazione cloud. La domanda utile è se il trasferimento sia insolito per quell'host, non se sia elevato in termini assoluti.
Controlli la lista di blocco e il feed delle minacce prima di attribuire la colpa alla rete. Registri il risultato con indicazione temporale, host e destinazione, in modo che la persona successiva possa verificarlo anziché ripeterlo. Questa prova è anche ciò che Le consente di dimostrare ciò che è stato bloccato, invece di formulare ipotesi basate su un avviso generico.
Quando il sintomo si rivela essere una congestione piuttosto che una compromissione, le leve d'azione cambiano. Il blocco a livello DNS di annunci e tracker può ridurre il traffico web del 20-40% e velocizzare il caricamento delle pagine, senza necessità di modifiche sui dispositivi (Riduzione del consumo di larghezza di banda). Si tratta di una prima verifica pratica poiché riduce la richiesta senza alterare la configurazione dei client, mentre l'utilizzo orario mostra comunque se la baseline stessa si è modificata.
Conservare le prove senza raccogliere dati in eccesso
Un volume maggiore di dati di pacchetto non garantisce automaticamente maggiore sicurezza. Le acquisizioni complete aumentano i costi di archiviazione, l'esposizione della privacy e il carico di lavoro degli analisti, senza comunque consentire la lettura di un payload crittografato. La domanda da porsi per ciascun record è più mirata: questo elemento contribuisce al contenimento, alla salvaguardia, a un audit o alla risoluzione dei problemi?
La visibilità tende spesso a svanire. Quando il DNS non termina su server controllati dall'azienda, le organizzazioni perdono la visibilità sulle query e creano punti ciechi per le attività di esfiltrazione e denial of service (analisi di EfficientIP sull'infrastruttura DNS). Questo depone a favore del mantenimento delle prove del resolver sotto il proprio controllo diretto, piuttosto che della cattura indiscriminata di tutto il traffico.
Il set minimo giustificabile:
- Data e ora e rete o SSID, in modo che ogni record sia associato a un luogo e a una policy.
- Categoria della policy e azione intrapresa, inclusi i blocchi e la spiegazione mostrata all'utente.
- Dominio interrogato, classificazione delle minacce e stato del sistema, elementi generalmente sufficienti per ricostruire l'accaduto.
- Né URL completi, né payload, né cronologie di navigazione, a meno che non sussistano una chiara base giuridica e un periodo di conservazione definito.
La conservazione è una decisione, non un'impostazione predefinita. Mantenga i log di riepilogo dei flussi e del DNS per un periodo prestabilito, conservi le catture complete solo durante la gestione di un incidente attivo e le elimini alla chiusura del caso.
Prima di iniziare la raccolta: chi può leggere i log, per quanto tempo vengono conservati e cosa è stato comunicato agli utenti. Se non si è in grado di rispondere a tutte e tre le domande, si tratta di una semplice abitudine di archiviazione piuttosto che di una politica di governance.
Laddove il DNS esegua anche il filtraggio, il livello di reporting fornisce la maggior parte delle prove. Vale la pena leggere una guida ai log e al reporting del filtraggio DNS prima di definire il formato dei record, poiché integrare a posteriori categorie e motivazioni dei criteri nei log risulta particolarmente gravoso.
Scegliere la prima configurazione di monitoraggio
Il punto di partenza dipende da ciò che si protegge, e le reti pubbliche stanno diventando la norma piuttosto che l'eccezione. La Wireless Broadband Alliance ha riferito nel 2025 che il 46% degli intervistati prevedeva di implementare una rete WiFi pubblica a livello cittadino nel 2025 o 2026, mentre il 15% aveva già implementato una rete simile (report di settore WBA 2025).
Per una sede di piccole dimensioni, inizi con l'esportazione dei flussi dal router, i log DNS e una baseline di due settimane; quindi, crei una dashboard che mostri l'utilizzo del collegamento, i top talker e la percentuale di NXDOMAIN. Questa visualizzazione unica risponde alla maggior parte delle segnalazioni dei giorni feriali senza la necessità di aprire un file di cattura.
Per una sede o un campus multi-sito, aggiunga viste per SSID e per VLAN, soglie basate su finestre temporali e un log a livello DNS che registri ciascun dominio bloccato insieme alla policy applicata. Il lavoro supplementare risiede nella normalizzazione, non negli strumenti.
Per il WiFi pubblico o il WiFi per ospiti, mantenga la stessa policy e registrazione per SSID e informi chiaramente gli utenti su cosa viene registrato e per quanto tempo. La trasparenza non costa nulla e disinnesca la maggior parte dei reclami prima che raggiungano un responsabile.
L'acquisizione dei pacchetti resta uno strumento per gli incidenti attivi, non un flusso continuo. Valuti l'efficacia della configurazione in base alla rapidità con cui risponde a una domanda: questo rallentamento è dovuto a un problema di capacità, al guasto di un dispositivo o a una minaccia?
Purple Shield opera come DNS di protezione su qualsiasi rete WiFi o su reti Purple Access, con una policy dedicata per ciascuna, e consente di proteggere una rete gratuitamente per 30 giorni.
Scelga una rete questa settimana, effettui una cattura nell'ora di punta, la confronti con la stessa ora nella baseline e annoti il primo riscontro indicando timestamp, host e destinazione. Quel singolo documento vale più di un'altra dashboard.
Purple Shield risponde a ogni ricerca DNS sulle reti protette, verificando i domini prima dell'apertura di una connessione; la dashboard mostra gli elementi bloccati, le minacce arrestate e le modalità d'uso della rete tra sedi e SSID. Se preferisce documentare gli eventi tramite le evidenze delle ricerche piuttosto che eseguire la cattura dei pacchetti 24 ore su 24, inizi con la prova gratuita per una singola rete. Visiti Purple Shield per scoprire come si presenterebbero i criteri e i report per SSID all'interno della Sua infrastruttura.