
Guida alle reti basate su cloud: architettura e vantaggi
Scoprite cos'è una rete basata su cloud, come funziona la sua architettura e come proteggere e gestire il WiFi multi-sito con un minor numero di dispositivi in loco.
Published 19 novembre 2026
Un ospite chiede la password del WiFi in una delle Sue sedi. Lei la fornisce. Da qualche parte in un ufficio interno, un router ormai datato fa del suo meglio con le regole firewall impostate nel 2019, e nessuno in azienda è in grado di elencarle a memoria.
Questo scenario si ripete su tre o dodici sedi, e le complessità aumentano: credenziali di accesso amministratore separate per ogni apparato, criteri presenti in un punto ma non in un altro e una quantità fissa di hardware che rimane inutilizzata in inverno e va sotto sforzo in estate. Una rete basata su cloud è la soluzione scelta dalla maggior parte degli operatori per risolvere questo problema. È anche il punto in cui sorgono le domande più importanti, poiché spostare il controllo nel cloud cambia ciò che continua a funzionare quando una parte del sistema si arresta.
Sommario
- Cos'è una rete basata su cloud e in cosa si differenzia
- Come si integrano i livelli di una rete basata su cloud
- Vantaggi, costi e dove si sta verificando la transizione
- Proteggere il traffico a livello DNS
- Cosa continua a funzionare in caso di guasto di una rete basata su cloud
- Scegliere una configurazione e avviare un progetto pilota su una sede
Cos'è una rete basata su cloud e in cosa si differenzia
Immagini una catena di caffetterie con tre punti vendita. Ciascuno dispone del proprio router, del proprio firewall e delle proprie credenziali di amministrazione, ed è stato configurato in un pomeriggio qualunque da chiunque fosse disponibile. La regola che blocca i contenuti per adulti è attiva in due sedi. Nessuno l'ha configurata nella terza e nessuno sa risalire a quando.
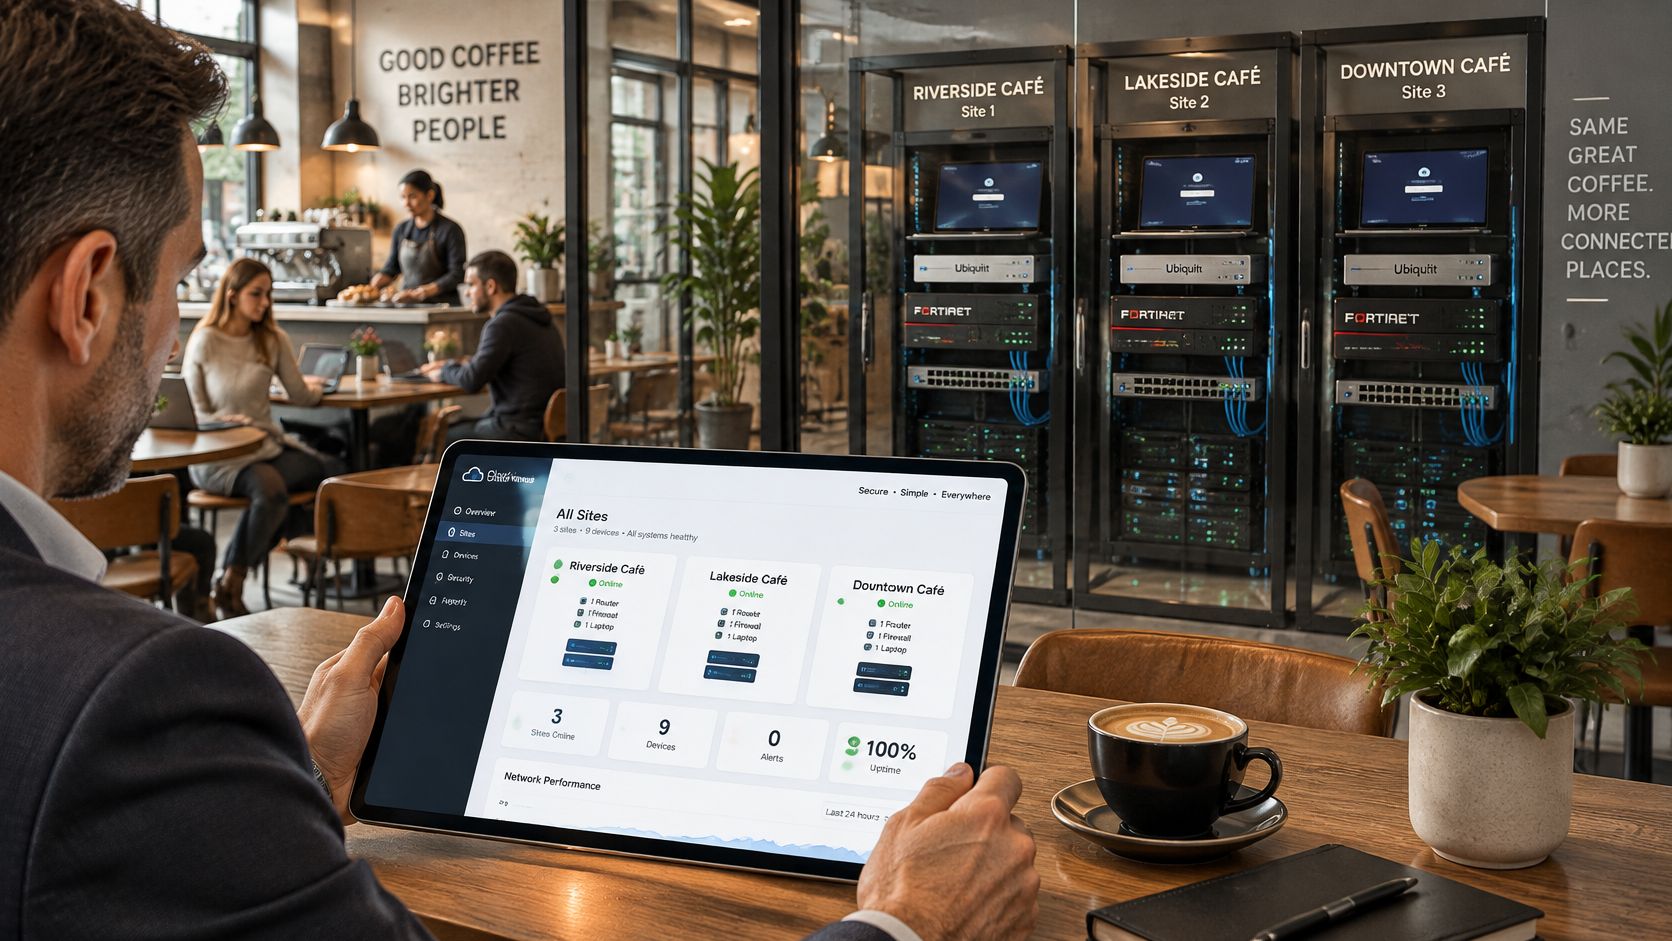
Una rete basata su cloud trasferisce l'elaborazione al di fuori dell'infrastruttura locale. Criteri, monitoraggio, reportistica e configurazione risiedono su una piattaforma gestita dal provider. Ciò che rimane on-premise diventa molto più semplice: access point, uno switch e un connettore leggero che comunica con la piattaforma. È sufficiente accedere una sola volta per visualizzare ogni sede e modificare una regola per tutte contemporaneamente.
Nel 2011, il National Institute of Standards and Technology degli Stati Uniti ha pubblicato la definizione a cui la maggior parte del settore fa ancora riferimento, descrivendo il cloud computing come l'accesso on demand a un pool condiviso di risorse configurabili che possono essere allocate e rilasciate con un impegno di gestione minimo (NIST). Le sue cinque caratteristiche si applicano perfettamente al contesto delle sedi fisiche. Il resource pooling (condivisione delle risorse) spiega perché l'infrastruttura viene condivisa con altri clienti anziché esserne proprietari. La rapid elasticity (rapida elasticità) illustra come una sede balneare possa aumentare la propria capacità ad agosto senza dover acquistare nuovo hardware. Il measured service (servizio a consumo misurato) è alla base della dashboard e della reportistica mensile.
Se deve decidere cosa delegare e cosa gestire internamente, la guida ai servizi cloud gestiti di CEFCore illustra nel dettaglio l'ambito pratico di un modello gestito.
Le differenze rilevanti per un operatore multi-sede si riducono a una manciata di domande pratiche.
| Aspetto | Rete tradizionale | Rete basata su cloud |
|---|---|---|
| Dove risiede la policy | Hardware locale in ogni sede | Piattaforma cloud centralizzata, applicata per sede |
| Aggiunta di una nuova sede | Acquisto, spedizione e configurazione dell'hardware in loco | Attivazione della sede e applicazione delle policy esistenti |
| Gestione | Accesso di amministrazione locale per singolo dispositivo | Un'unica dashboard per tutte le sedi |
| Scalabilità della capacità | Aggiornamento o sostituzione dell'hardware | Il provider incrementa la capacità on demand |
| Dipendenza dai guasti | Apparecchiature locali e connettività locale | Percorso Internet combinato al control plane del provider |
Regola pratica: se una modifica apportata a una sede deve essere ripetuta manualmente in ogni altra sede, si sta gestendo una rete tradizionale con una moderna pagina di accesso.
In che modo i livelli di una rete basata su cloud si integrano tra loro
Immagini un edificio a tre piani. L'ultimo piano è l'ufficio di gestione: si tratta del piano di controllo cloud, in cui vengono definiti criteri, gruppi di utenti e report. Il personale lavora lassù, ma gli ospiti non vi accedono mai. Il piano di controllo stabilisce ciò che deve accadere, ma non gestisce direttamente il traffico degli ospiti.
Il piano intermedio è il corridoio, ovvero il piano dati. Qui transita il traffico, attraverso access point, switch e breakout locali in ogni struttura. In questo livello si definisce anche quali dispositivi possono comunicare tra loro, e la segmentazione di rete è la procedura che mantiene gli smartphone degli ospiti separati dai terminali di pagamento, e i terminali separati dai sistemi di back-office.
Il piano inferiore è il livello di accesso locale: la porta attraverso cui accede ogni dispositivo.
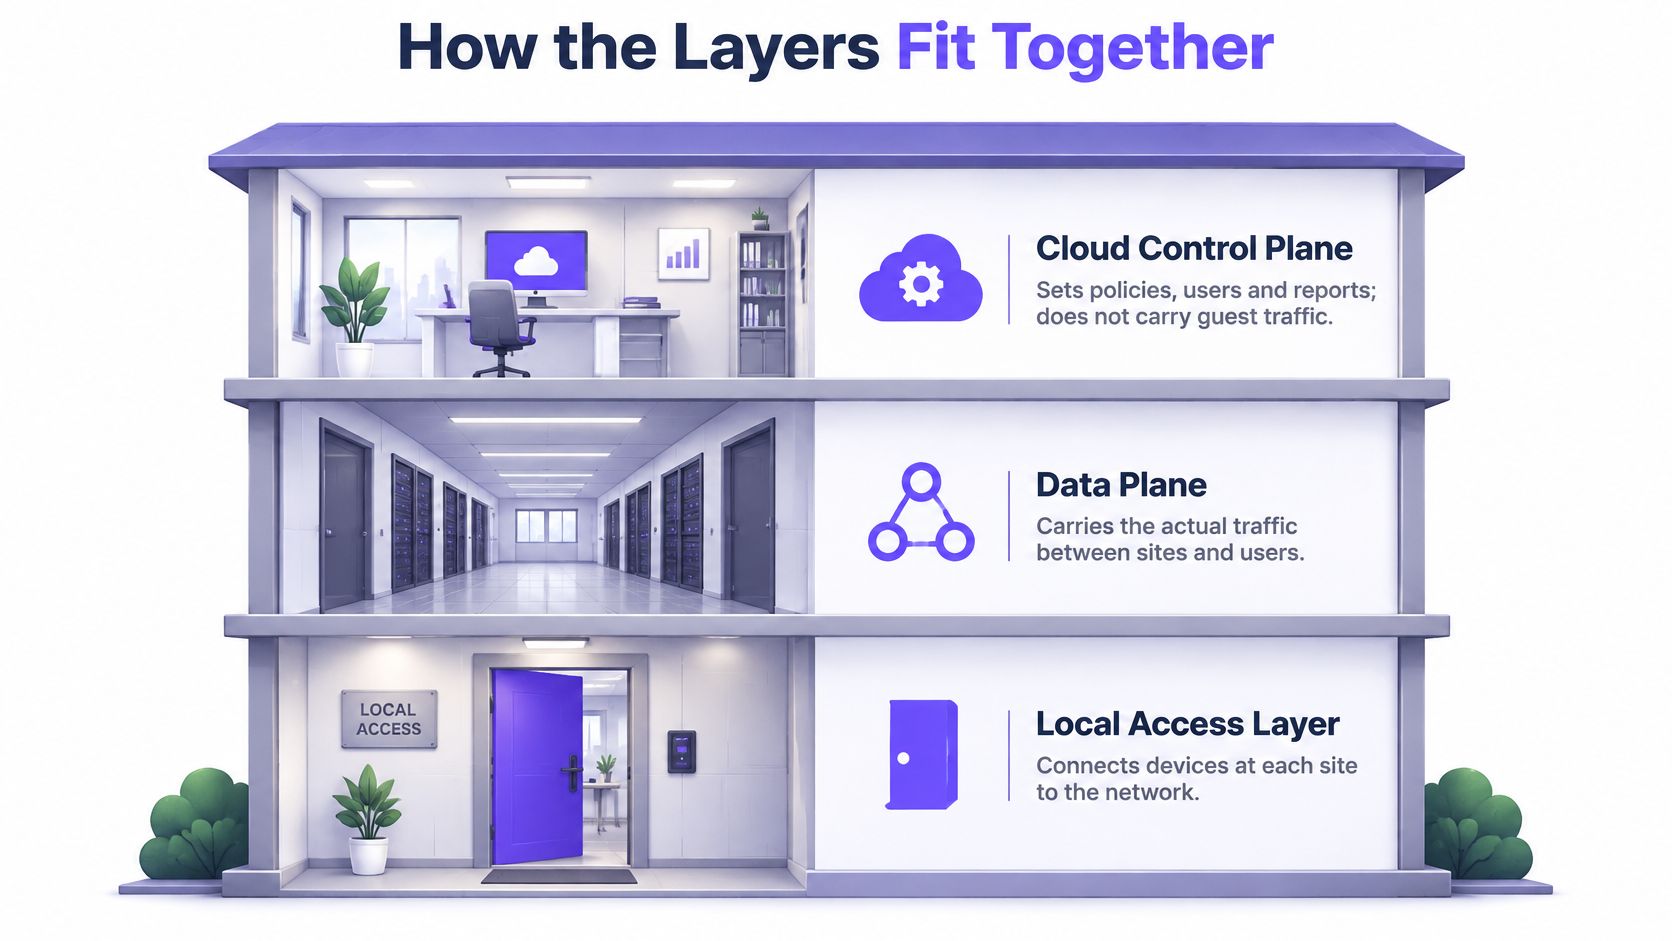
Tra l'ufficio e il corridoio si trova il checkpoint che ogni connessione attraversa per primo: il livello DNS. Nulla raggiunge il corridoio senza che venga risolto un nome.
Una connessione guest, passo dopo passo
- Il dispositivo si connette al SSID e l'access point locale lo accetta. Questo avviene in loco, non nel cloud.
- Il dispositivo riceve un indirizzo IP dal DHCP. L'indirizzo viene prima di qualsiasi navigazione.
- Il dispositivo richiede un nome e la query di risoluzione viene inoltrata al resolver cloud anziché a quello impostato in modo rigido nel router.
- Il resolver risponde con "consenti" o "blocca" in pochi millisecondi, in base ai criteri impostati per tale SSID.
- Solo a quel punto la connessione viene aperta, che si tratti di una pagina web, di un'app o di una sincronizzazione in background.
I tre livelli formano quindi una gerarchia. I criteri vengono stabiliti al vertice, l'applicazione avviene al checkpoint DNS e l'inoltro avviene nel corridoio. La stessa architettura viene impiegata ben oltre il contesto del WiFi, motivo per cui la connettività IoT per distributori automatici si basa su un livello di controllo cloud con comportamenti locali in grado di funzionare anche in caso di caduta della connessione.
Un guasto a livello di gestione e un guasto a livello di inoltro non sono la stessa cosa. Se si perde l'ufficio, non è possibile apportare modifiche, ma il corridoio continua a smistare il traffico. Se si perde il corridoio, nessuna dashboard al mondo potrà aiutare l'ospite che si trova davanti a Lei.
Vantaggi, costi e dove si sta verificando il cambiamento
Il cambiamento emerge innanzitutto nella spesa. Gartner ha stimato la spesa globale degli utenti finali per i servizi di cloud pubblico a quota 675,4 miliardi di dollari nel 2024, in aumento rispetto ai 561 miliardi di dollari del 2023 (+20,4%), con l'Infrastructure as a Service - la categoria più vicina alla capacità di rete virtualizzata - che secondo le previsioni crescerà del 25,6% raggiungendo i 180,0 miliardi di dollari (Gartner).
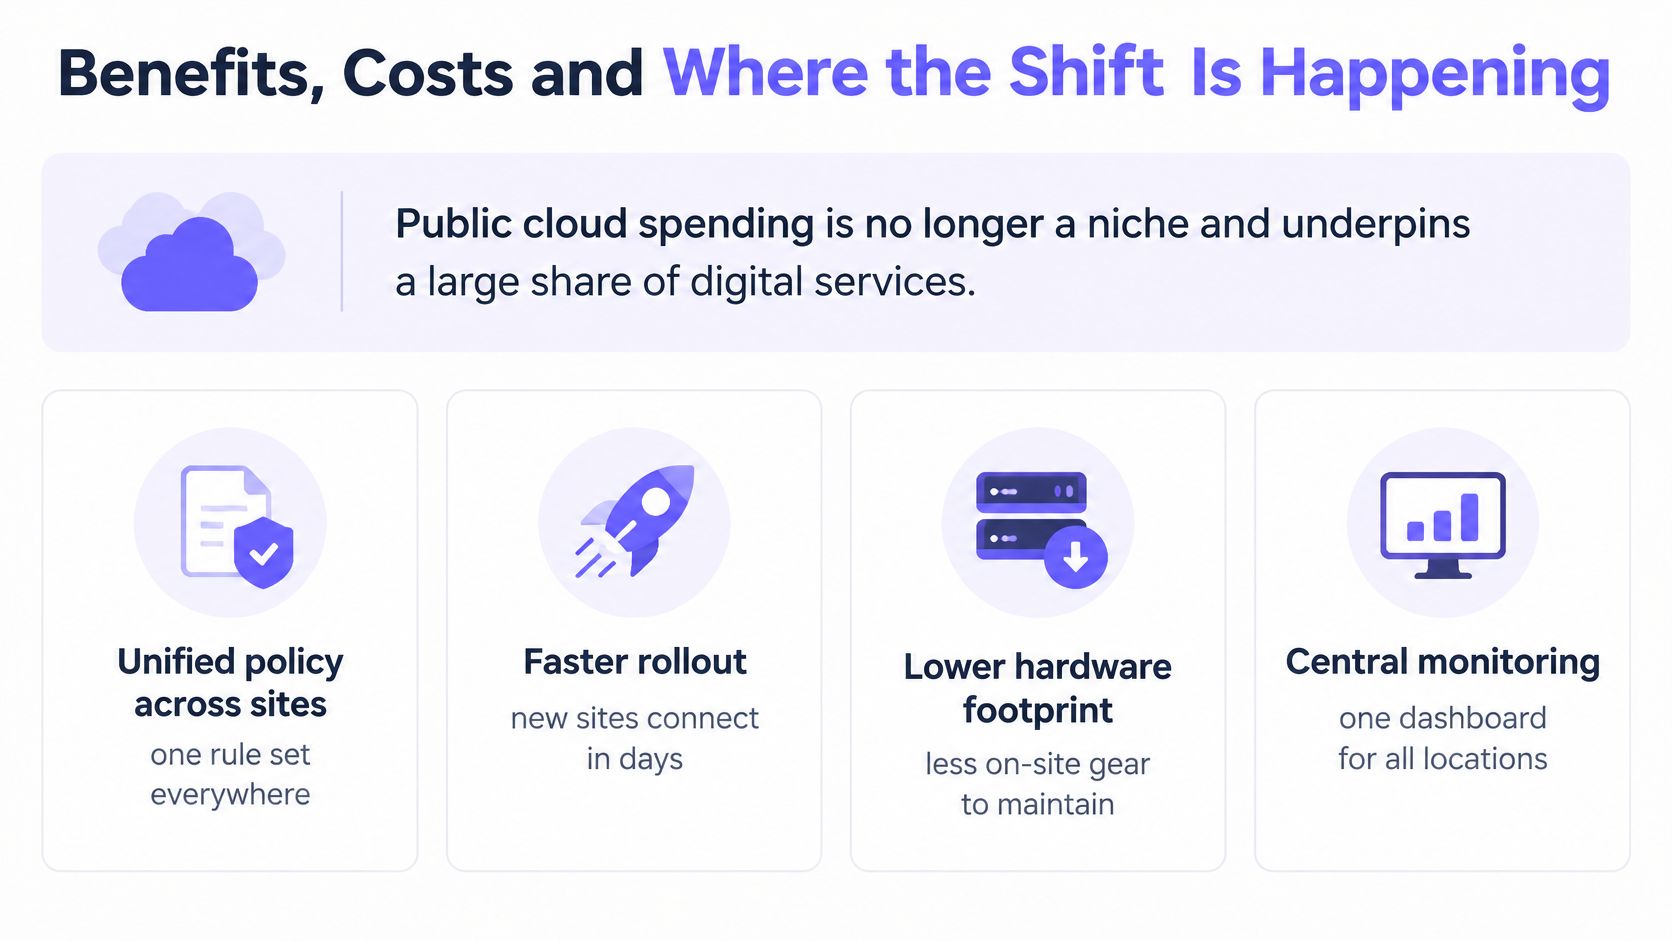
L'adozione è estesa e non limitata alle grandi aziende. Eurostat ha rilevato che il 52,7% delle imprese dell'UE ha utilizzato servizi cloud a pagamento nel 2025, registrando un incremento di 7,4 punti percentuali rispetto al 2023 (Eurostat). Il Central Statistics Office irlandese ha registrato che il 42,6% delle imprese irlandesi ha acquistato software di sicurezza basato su cloud nel 2025 (Central Statistics Office). Anche la spesa si sta concentrando: il 40% delle imprese intervistate da Flexera ha speso più di 12 milioni di dollari all'anno per il cloud pubblico, in aumento rispetto al 36% dell'anno precedente (Flexera).
Se preferisce guardare una panoramica dettagliata invece di leggere il resto, questo video illustra il modello in pochi minuti.
Per un operatore multi-sede, a ogni vantaggio corrisponde un costo equivalente.
- Attivazione più rapida, compensata da canoni ricorrenti. Una nuova sede viene integrata in pochi giorni anziché richiedere un ordine di acquisto e un intervento in loco; tuttavia, l'abbonamento sostituisce la spesa in conto capitale per l'hardware e tale costo non cessa mai del tutto.
- Un unico set di policy ovunque, compensato dalla formazione. Grazie a regole centralizzate, una modifica di sicurezza viene applicata a ogni sede in pochi minuti, ma ciò comporta anche la necessità che il team impari a utilizzare una nuova console e a farvi affidamento.
- Log centralizzati per gli audit, compensati dalla dipendenza dal collegamento. I report attingono a un'unica posizione, ma il traffico transita comunque attraverso la connessione Internet di ciascuna sede e nessuna piattaforma può risolvere i problemi di una linea scadente.
Si consideri un gruppo alberghiero con dodici strutture che passa dai controller locali a una gestione centralizzata. L'onboarding di una nuova struttura si riduce all'inserimento di una voce nella piattaforma e all'applicazione di una policy da un modello esistente, mentre l'amministrazione ordinaria non richiede più di accedere a dodici portali diversi, ma a un'unica coda di revisione.
| Metrica | Dato | Confronto | Fonte |
|---|---|---|---|
| Spesa globale degli utenti finali per il cloud pubblico nel 2024 | 675,4 miliardi di dollari | 561 miliardi di dollari nel 2023, in crescita del 20,4% | Gartner |
| Spesa IaaS nel 2024 | 180,0 miliardi di dollari | 143,3 miliardi di dollari nel 2023, in crescita del 25,6% | Gartner |
| Spesa PaaS nel 2024 | 172,4 miliardi di dollari | in crescita del 20,6% | Gartner |
| Spesa SaaS nel 2024 | 247,2 miliardi di dollari | in crescita del 20,0% | Gartner |
| Spesa degli utenti finali per il cloud pubblico nel 2025 | 723,4 miliardi di dollari | previsione successiva rispetto al dato del 2024 | Gartner |
| Imprese dell'UE che utilizzano servizi cloud a pagamento nel 2025 | 52,7% | in aumento di 7,4 punti percentuali rispetto al 2023 | Eurostat |
| Imprese irlandesi che acquistano software di sicurezza basato su cloud nel 2025 | 42,6% | Solo Irlanda | Central Statistics Office |
| Imprese che spendono oltre 12 milioni di dollari all'anno per il cloud pubblico | 40% | 36% nell'anno precedente | Flexera 2025 |
I vantaggi sono maggiori dove le sedi sono numerose, simili e gestite da un team ridotto. Dodici reti alberghiere quasi identiche traggono vantaggio dalla gestione centralizzata. Un singolo edificio atipico con apparecchiature su misura potrebbe non averne.
Proteggere il traffico al livello DNS
Il DNS è il punto utile più a monte in cui rifiutare una connessione. Un dominio può essere respinto durante la risoluzione del nome, prima ancora che il dispositivo ottenga un indirizzo di destinazione e prima che abbia inizio una sessione Web, TLS o di comando e controllo. A quel punto il dispositivo dispone già di un indirizzo IP, semplicemente non di quello desiderato.
Un livello DNS cloud svolge tre funzioni, ed è opportuno citarle separatamente poiché i fornitori tendono a confonderle.
- Filtraggio per categorie. Contenuti per adulti, gioco d'azzardo, hosting di malware o qualsiasi elemento specificato dai criteri, applicato per SSID affinché la rete del personale e una sala lettura per bambini non condividano lo stesso set di regole.
- Blocco delle minacce. Domini di phishing, host di distribuzione malware e comunicazioni verso server di comando e controllo (C2), bloccati a livello di query DNS anziché dopo il rilascio del payload.
- Rimozione di annunci e tracker. Meno richieste di terze parti significano pagine più leggere e meno consumo di dati sullo smartphone degli ospiti.
Cosa deve essere protetto affinché funzioni
Un DNS sicuro presenta tre requisiti distinti, spesso venduti come un unico pacchetto: integrità, riservatezza e disponibilità. Il DNSSEC garantisce l'integrità convalidando che una risposta firmata non sia stata manomessa. La riservatezza è più facile da trascurare, poiché anche una risposta corretta può rivelare la richiesta quando le query viaggiano in chiaro. La disponibilità richiede una pianificazione dedicata; per questo motivo, gli operatori continuano a utilizzare resolver distribuiti, tolleranza ai guasti e più di un resolver ricorsivo nella configurazione.
Ciò fornisce una breve lista di controllo per qualsiasi rete pubblica o guest:
- Instradare tutto il DNS dei client verso resolver sotto il proprio controllo, anziché consentire ai dispositivi di scegliere il proprio.
- Impedire l'aggiramento ove l'hardware lo consenta, bloccando il traffico DNS in uscita verso altri server.
- Convalidare le risposte DNSSEC affinché una risposta falsificata venga rifiutata.
- Proteggere il trasporto delle query dove si applicano le normative sulla privacy, evitando che le ricerche siano leggibili in transito.
- Conservare i log per un tempo sufficiente a determinare cosa un dispositivo ha tentato di raggiungere e quando.
Ogni elemento rappresenta una modalità di guasto da verificare prima che sia un incidente reale a farlo per Lei. Indirizzi un dispositivo verso un resolver esterno e verifichi se la regola di bypass lo intercetta. Poi si chieda cosa succede quando i resolver smettono di rispondere: il failing open mantiene gli ospiti online ma disattiva ogni criterio, mentre il failing closed mantiene i criteri ma trasforma un guasto al resolver in un'interruzione di servizio. Purple Shield adotta il failing closed ed è distribuito su più data center, evitando che un guasto in una sede interrompa il servizio.
Consulti il registro prima di considerare affidabile il filtro. Una pagina di blocco non dimostra nulla da sola. Il record di ricerca dimostra ciò che è stato rifiutato, per quale rete e a che ora.
Il filtraggio DNS si affianca alla protezione degli endpoint, ai firewall e ai controlli a livello applicativo; l'utilità della sicurezza DNS come livello di controllo si basa proprio sul fatto di costituire uno strato tra molti, anziché una loro alternativa.
Cosa continua a funzionare in caso di guasto a una rete basata su cloud
Una sede può perdere la dashboard su cloud e continuare a trasmettere traffico. Può anche mantenere la dashboard e perdere il percorso DNS responsabile del filtraggio. A prima vista questi guasti possono sembrare identici, ma coinvolgono componenti diverse della rete. È necessario progettarli separatamente.
Un'indagine di settore ha rilevato che il 60% dei professionisti IT ha riscontrato un'interruzione della rete cloud nei 12 mesi precedenti. Tra le cause segnalate figurano guasti dei fornitori di servizi cloud, errori umani, integrazioni di terze parti, attacchi informatici ed errori di configurazione (indagine di settore Aviatrix 2025).
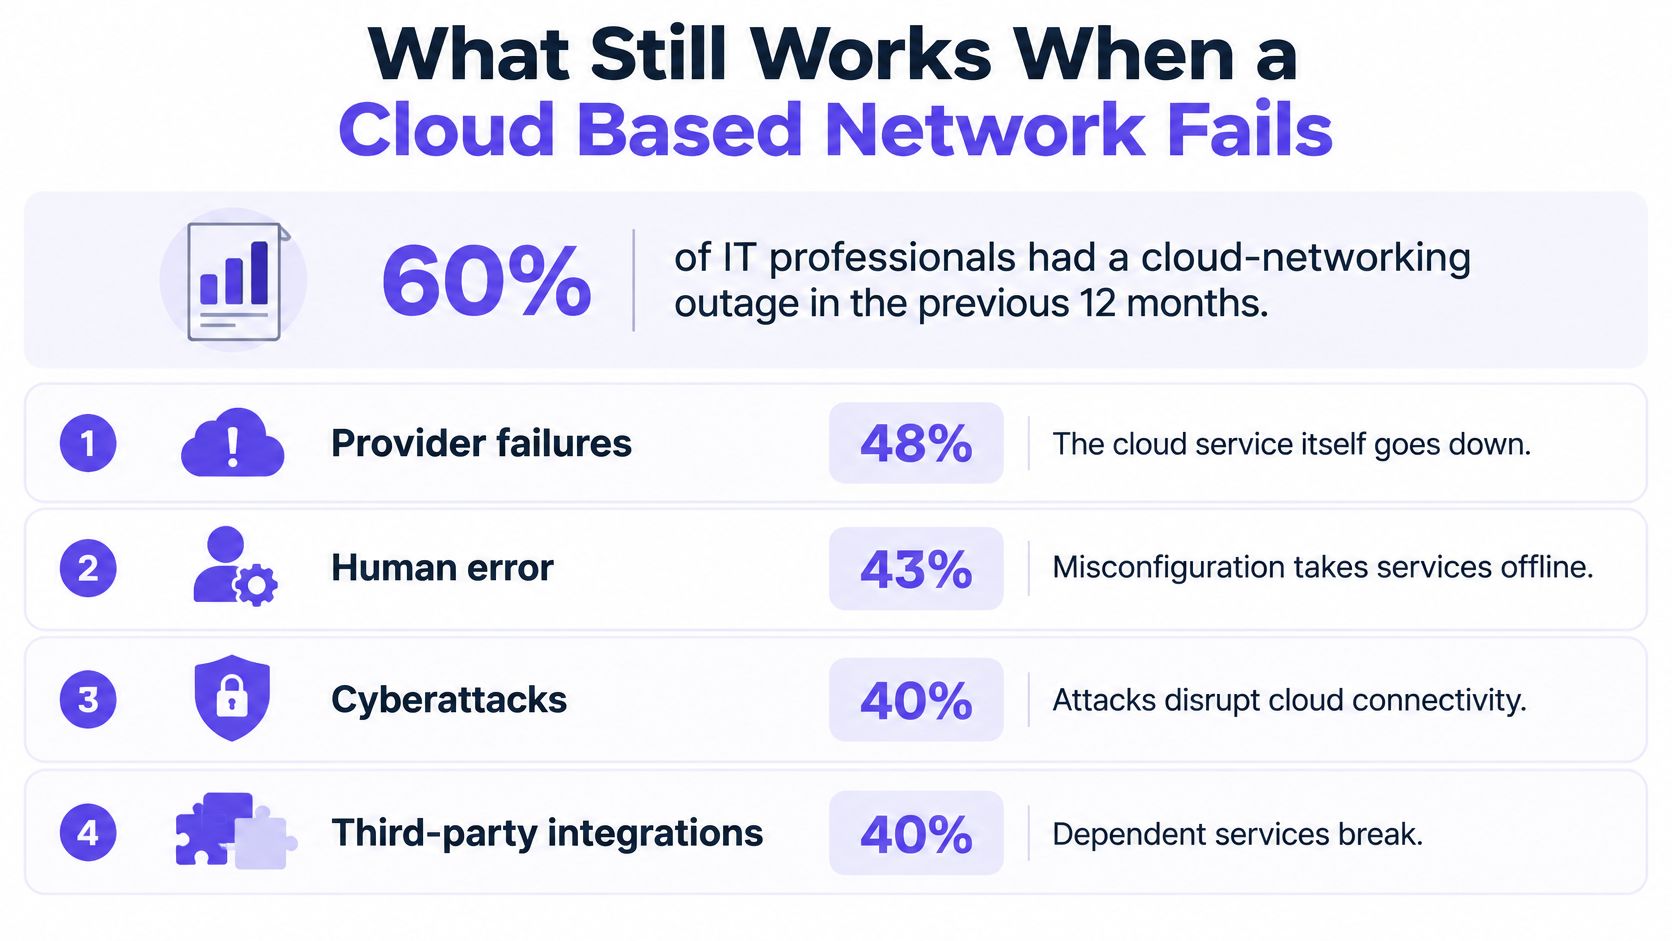
Il dato relativo all'uptime di un provider descrive la sua piattaforma, non la capacità della Sua sede di continuare ad applicare le policy quando tale piattaforma non è raggiungibile. La dashboard è la sala di controllo; i dispositivi presso la sede devono comunque gestire il traffico e applicare le regole già ricevute.
Un SLA descrive ciò che il provider promette. Non indica cosa faranno i Suoi access point quando il piano di controllo non sarà raggiungibile.
Due interruzioni apparentemente identiche ma diverse nella sostanza
In caso di guasto al piano di gestione, potrebbe non essere possibile modificare le policy, visualizzare report aggiornati o integrare una nuova sede. Il traffico e l'applicazione esistenti possono continuare perché le regole sono già state inviate all'edge di rete.
In caso di guasto al livello di applicazione delle policy, di norma il DNS o il relativo percorso di risoluzione, gli utenti se ne accorgono immediatamente. Alcuni siti potrebbero smettere di risolversi; in alternativa, tutto potrebbe risolversi perché il filtraggio è stato bypassato.
Questa è la scelta tra fail-open e fail-closed. Il fail-open ripristina la connettività tramite la normale risoluzione ricorsiva se il servizio cloud non è disponibile, ma i controlli di protezione non vengono più applicati. Il fail-closed mantiene attive le policy, ma un guasto del DNS può bloccare anche servizi legittimi come i pagamenti con carta o i sistemi di prenotazione, a meno che la rete non disponga di soluzioni di fallback collaudate. Nessuno dei due comportamenti è adatto a ogni sede. L'aspetto fondamentale è sapere quale modalità utilizza la propria rete e quale sarà l'esperienza degli utenti (guida al filtraggio fail-open rispetto a fail-closed).
Progettare la soluzione di fallback prima che sia necessaria
Configuri più di un resolver e ne monitori lo stato operativo. Identifichi i servizi che devono rimanere disponibili e collaudi un percorso di fallback per essi. Se gli ospiti perdono l'accesso a Internet, faccia in modo che il portale captive spieghi il disservizio anziché lasciarli davanti a un'icona di caricamento.
La gestione tramite cloud non elimina l'hardware presente in sede. Access point, switch e il collegamento Internet della struttura rimangono parte del servizio, e un guasto alla linea può comunque isolare la sede. Inoltre, la reportistica dipende dai log, dal periodo di conservazione e da un formato comprensibile per il personale.
| Guasto | Cosa continua a funzionare | Comportamento dei criteri | Test prima del go-live |
|---|---|---|---|
| Interruzione del piano di gestione cloud | Traffico e applicazione esistenti, se le regole sono già attive | Di norma invariato | Interrompere l'accesso di gestione e verificare che il traffico continui a scorrere |
| Interruzione del resolver DNS | Cache locale e resolver secondari, se configurati | Fail-open o fail-closed, in base alla configurazione | Bloccare il resolver primario e verificare che il secondario risponda |
| Collegamento Internet della sede inattivo | Solo servizi locali | Non applicabile | Scollegare il collegamento WAN e verificare la visualizzazione del messaggio di fallback |
| Guasto dell'operatore o del provider upstream | Traffico su un percorso alternativo, se presente | Invariato se supportato da un secondo percorso | Simulare la perdita upstream e verificare l'instradamento di failover |
| Interruzione dell'Identity Provider | SSID aperti o con chiave precondivisa | L'accesso autenticato potrebbe arrestarsi | Testare il fallback di accesso per personale e ospiti |
Tre passaggi per verificarlo
- Esegua ogni test su una singola sede. Lo esegua durante l'orario di attività, in modo da poter verificare l'esperienza degli ospiti oltre ai dati segnalati dalla rete.
- Registri il risultato. Prenda nota di ciò che ha continuato a funzionare, dell'applicazione dei criteri in modalità fail-open o fail-closed, della data e di chi ha eseguito il test.
- Ripeta la procedura dopo aver modificato i criteri. Un nuovo set di regole può alterare il comportamento del fallback.
I costi di abbonamento e la dipendenza dalla connessione Internet influiscono su ciò che è possibile distribuire, ma non rispondono a cosa accade durante un disservizio. Se può eseguire il test su una sola sede, inizi da quella con il maggior numero di ospiti o con il più rigoroso dovere di diligenza.
Scegliere una configurazione e avviare il progetto pilota in una sede
Prima di confrontare i prodotti, decida quale scopo deve avere la Sua rete. L'ordine dei passaggi conta più dello strumento.
- Elencare ogni sede e ogni gruppo che la utilizza. Ospiti, personale, studenti, residenti, livelli a pagamento. Mettere l'elenco per iscritto; la maggior parte degli operatori individua due gruppi precedentemente trascurati.
- Assegnare a ogni gruppo il proprio SSID o VLAN fin dal primo giorno. Una rete del personale che condivide una serie di regole con una rete ospiti è un incidente di sicurezza che attende solo di verificarsi. L'onboarding dovrebbe assegnare a ogni rete cliente una policy dedicata, separatamente per ospiti, personale, studenti, residenti e livelli a pagamento.
- Contrassegnare i test di guasto pertinenti per la propria organizzazione. Perdita del piano di gestione, failover del DNS, WAN scollegata, perdita di upstream e interruzione dell'Identity Provider. Se un test non è applicabile, specificarlo chiaramente anziché ometterlo.
- Eseguire un progetto pilota su un'unica rete e documentare l'esito prima di qualsiasi implementazione più ampia. Una sede, una settimana, una pagina di risultati.
Purple Shield si inserisce a valle di tale lavoro, non in sua sostituzione. Un unico livello DNS filtra i contenuti, blocca le minacce ed elimina gli annunci su ogni dispositivo di qualsiasi rete, con una policy per SSID, VLAN e sede e una dashboard centralizzata. È possibile provarlo gratuitamente per 30 giorni su una rete o avviare un progetto pilota su un unico SSID pianificato con il nostro team, per poi ricevere un preventivo personalizzato.
Scelga quindi una sede questa settimana. Registri i suoi gruppi di utenti, compili la tabella dei guasti solo per quella sede e prenoti il progetto pilota non appena saprà cosa dovrebbe fare la Sua rete in caso di problemi.
Purple Shield è la soluzione di DNS protettivo e filtro dei contenuti creata per il WiFi di sedi, ospiti e pubblico WiFi. Funziona in modo autonomo su qualsiasi rete WiFi o insieme a Purple Access, con un criterio dedicato per ogni SSID, VLAN e sede, e offre una reportistica che mostra esattamente ciò che è stato bloccato. Opera su più data center e adotta un approccio fail-closed, evitando che un problema con il resolver disattivi la Sua protezione. Attivi una prova gratuita di 30 giorni su una rete all'indirizzo Purple Shield e metta alla prova i test di resilienza prima di sottoscrivere qualsiasi accordo.