
Analise o tráfego de rede: capture, leia e solucione problemas
Aprenda a analisar o tráfego de rede passo a passo: capture dados, crie uma linha de base, leia fluxos criptografados e identifique problemas de segurança ou desempenho.
Published 20 de novembro de 2026
São 14h10 de uma terça-feira e a recepção já ligou duas vezes reclamando de WiFi lento. Nada foi alterado durante a noite. Os pontos de acesso estão funcionando, o gráfico de uplink está muito parecido com o de ontem e o provedor informa que o circuito está limpo. Você tem cerca de vinte minutos antes que alguém decida que o problema é de responsabilidade da equipe de rede.
Esses vinte minutos são o verdadeiro objetivo da análise de tráfego. Não se trata de coletar cada pacote, mas de comprovar rapidamente um pequeno conjunto de fatores: se o link está saturado, se um dispositivo está apresentando comportamento anômalo, se algo interno está se comunicando com um host indevido ou se a reclamação é apenas sobre a cobertura em um canto de um edifício.
A ordem faz diferença. Defina as métricas corretas, faça uma captura que responda a uma pergunta, construa uma linha de base com a qual você possa fazer comparações e mantenha registros que você se sinta confortável em defender.
Índice
- Métricas de tráfego para monitorar e o que elas significam
- Como capturar o tráfego passo a passo
- Construindo uma linha de base para o tráfego normal
- Lendo o tráfego quando ele está criptografado
- Identificando problemas de segurança e desempenho
- Mantendo evidências sem coletar dados em excesso
- Escolha sua primeira configuração de monitoramento
Métricas de tráfego para monitorar e o que elas significam
WiFi lento às 14h raramente significa que a rede quebrou. Geralmente significa uma de três coisas: a demanda atingiu o pico, um único dispositivo começou a fazer algo incomum ou um host na rede começou a se comunicar com um destino indevido. Você pode diferenciar essas possibilidades com alguns números que provavelmente já coleta.
A grande quantidade e variedade de dispositivos torna isso mais difícil do que costumava ser. A previsão de 2017 a 2022 da Cisco projetou que o tráfego fixo e de WiFi atingiria 51% do tráfego IP total até 2022, acima dos 43% em 2017, e que dispositivos que não são PCs gerariam 81% do tráfego IP global (previsão de conexões globais da Cisco). Telefones, smart TVs, caixas registradoras e controladores prediais agora concentram a maior parte do volume, e nenhum deles consta em um inventário de ativos.
| Métrica | O que revela | Sinal de alerta |
|---|---|---|
| Utilização do link | O quanto um link está ocupado ao longo do tempo | Sustentado acima de 70-80% da capacidade |
| Top talkers | Hosts ou SSIDs que utilizam o maior volume | Um único dispositivo consumindo uma parcela desproporcional |
| Combinação de protocolos e portas | Se o tráfego corresponde aos serviços esperados | Portas ou protocolos inesperados em grande escala |
| Volume de consultas DNS | Atividade de resolução por host | Picos repentinos ou consultas repetidas a um mesmo domínio |
| Proporção de NXDOMAIN | Falhas na resolução de nomes | Proporção crescente, frequentemente indicando malware ou configuração incorreta |
| Novas conexões por minuto | Taxa de criação de sessões | Aumento acentuado, sugerindo varredura (scanning) ou saturação (flooding) |
| Retransmissões | Pacotes perdidos ou repetidos | Acima de 1-2% dos pacotes |
| Latência e jitter | Atraso e o quanto ele varia | Jitter que interrompe chamadas de voz ou vídeo |
Interprete essa lista como uma ordem de triagem, não como um placar. Às 14h, comece com a utilização do link para o período de uma hora e compare-a com o mesmo horário em semanas normais. Se a utilização estiver em seu pico habitual e as retransmissões estiverem normais, a causa é a capacidade, e a correção envolve agendamento, modelagem de tráfego ou mais largura de banda, em vez de uma busca por malware.
Se a utilização for comum e um único dispositivo dominar os maiores emissores de tráfego, esse dispositivo é sua próxima verificação, não o uplink. Se as retransmissões aumentarem enquanto a utilização permanecer estável, pare de analisar o tráfego e comece a inspecionar a infraestrutura: um cabo com defeito, uma incompatibilidade de duplex ou um ponto de acesso enfrentando interferência em um canal congestionado.
A regra que encerra qualquer discussão: nenhuma leitura isolada prova nada. Um número só tem significado quando comparado à faixa normal do mesmo local no mesmo horário.
Como capturar o tráfego passo a passo
O objetivo é ter uma amostra representativa, não uma cópia da rede. Vinte minutos coletados no momento certo superam uma semana de arquivos que ninguém abre, e o tamanho permanece pequeno o suficiente para repassar a um colega.
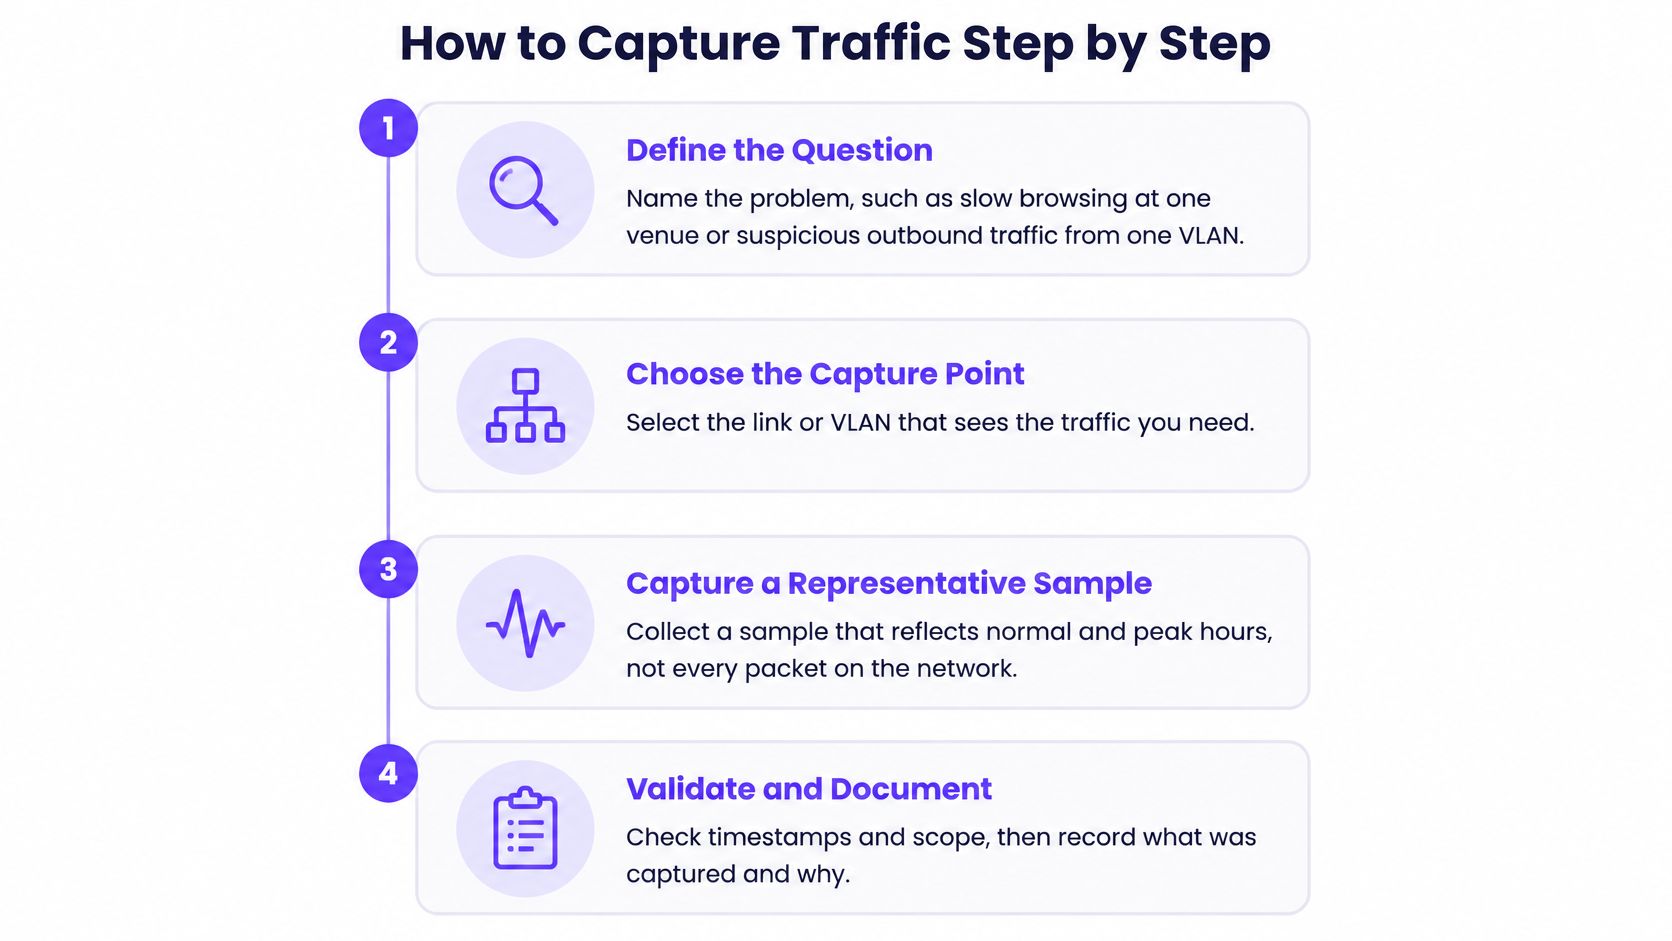
Defina a pergunta. "Navegação lenta no SSID de convidados em um local" e "tráfego de saída inesperado do VLAN de pagamentos" exigem pontos de captura, filtros e durações diferentes. Escreva a pergunta antes de fazer login em um switch. O erro mais comum é capturar primeiro e torcer para que a pergunta apareça no arquivo.
Escolha um ponto que visualize ambas as direções. Uma porta SPAN no switch, um TAP inline no uplink ou a exportação de fluxos a partir do roteador ou firewall. A exportação de fluxos é a maneira mais econômica de monitorar um local de forma contínua, e a captura de pacotes é a ferramenta certa quando os fluxos mostram algo fora do comum. Espelhar uma porta que trafega apenas uma direção fornece apenas metade da conversa e uma contagem de retransmissões sem significado real.
Filtre antes de gravar. Delimite a captura a uma sub-rede, VLAN ou host. Isso mantém o arquivo leve o suficiente para ser aberto em segundos e evita que você colete tráfego de funcionários e convidados que não fazem parte do problema.
Capture uma janela fixa de tempo. De quinze a trinta minutos durante o horário de pico, seguidos por uma captura mais curta durante um período calmo. Esse par possibilita comparações posteriores; uma captura isolada é apenas uma anedota.
Inclua o local, a data e a hora no nome do arquivo. Isso parece trivial até você se deparar com quarenta capturas sem conseguir identificar qual local solicitou o suporte.
Analise com filtros de exibição, não rolando a tela. Comece com Hierarchy Protocol e Conversations para entender o panorama geral e, em seguida, aprofunde-se em retransmissões ou consultas de nomes. Rolar manualmente uma captura movimentada é a forma mais fácil de achar, erroneamente, que nada está errado.
Registre o contexto junto ao arquivo. Ponto de captura, filtro, horário, o que os usuários relataram e o que você já descartou.
Um hábito torna os dados utilizáveis mais tarde. Normalize os fluxos por interface, SSID ou VLAN, local, janela de tempo e direção, e considere NAT, roteamento assimétrico, tunelamento e dispositivos compartilhados antes de definir qualquer limite (guia da Vectra para análise de tráfego criptografado). O contexto da rede não é um ruído em torno da análise; ele faz parte dela.
Se você deseja toda a rotina em uma única página para a equipe, esta é a sequência:
| Ponto de captura | Ideal para | Trade-off |
|---|---|---|
| Porta SPAN ou espelhada | Captura de pacotes de uma porta ou VLAN | Visualiza apenas o tráfego espelhado e pode perder uma das direções |
| Network TAP | Captura total de pacotes em um único link | Hardware dedicado; captura ambas as direções de forma confiável |
| Exportação de fluxo (NetFlow, sFlow, IPFIX) | Monitoramento de longo prazo a partir de roteador ou firewall | Mais econômico; mantém resumos de fluxo, e não pacotes |
Como criar uma linha de base para o tráfego normal
Um número só se torna um sinal quando você sabe qual costuma ser esse valor. As linhas de base são ignoradas por serem monótonas, e o custo disso surge mais tarde na forma de uma fila de alertas que todos silenciam.
Acompanhar os totais em tempo real é a metade mais simples. Saber quais totais estão incorretos para esta hora neste local é a outra metade.
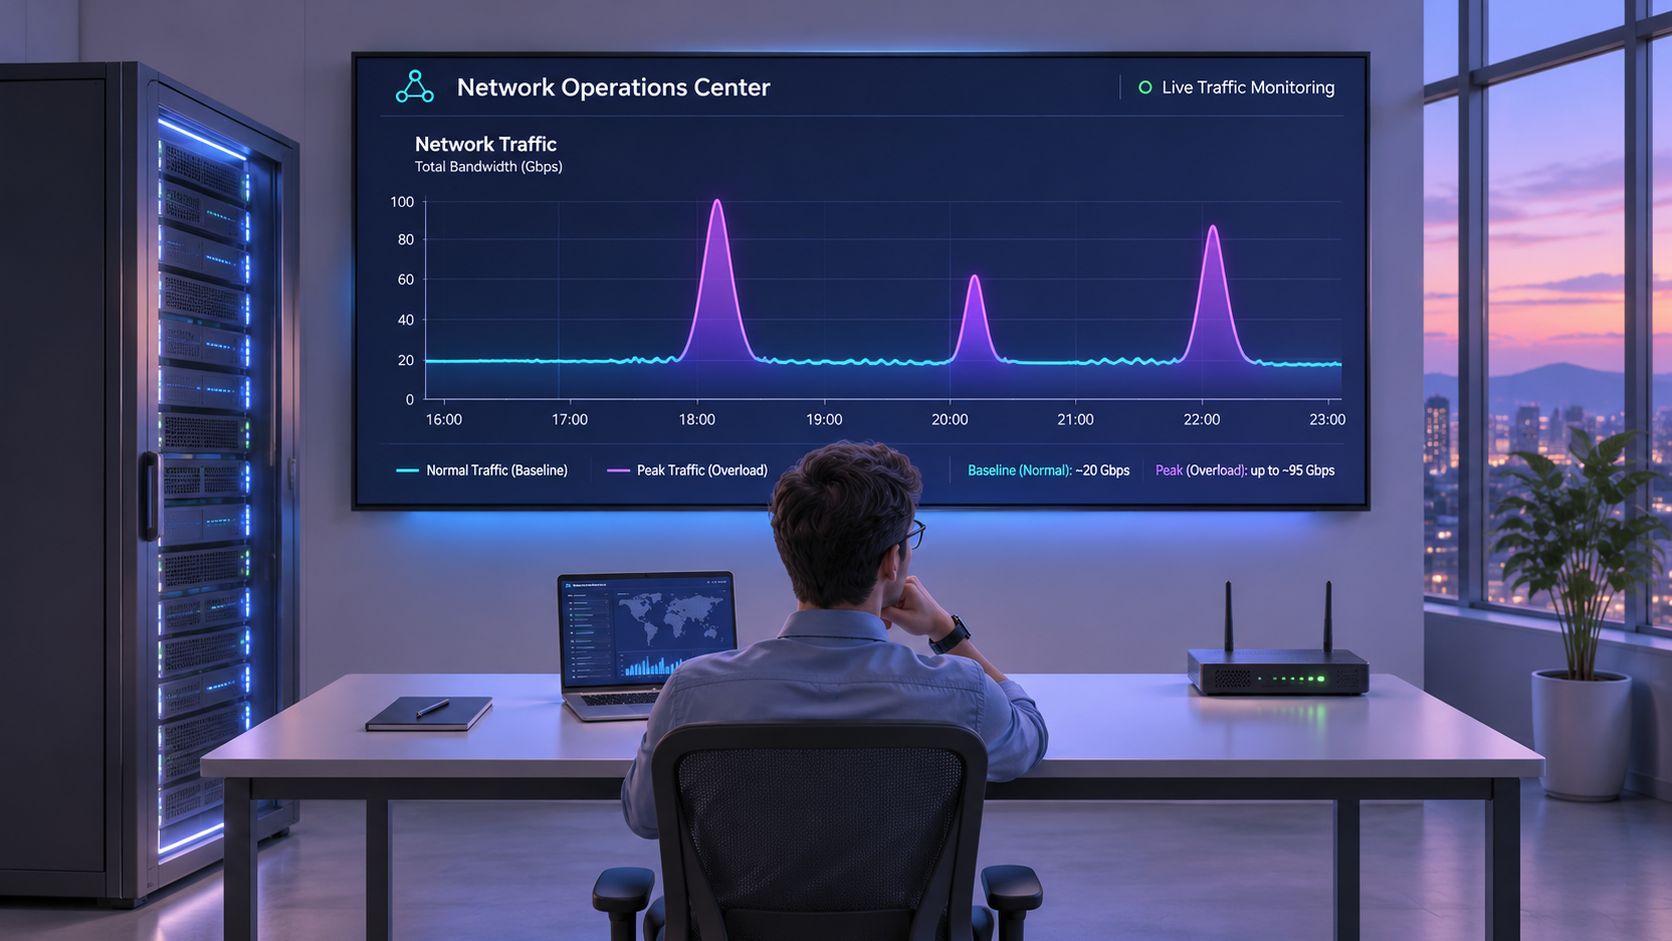
O crescimento faz com que qualquer linha de base perca a validade. A previsão da Cisco projetou o tráfego IP global subindo de 122,4 exabytes por mês em 2017 para 396,0 exabytes por mês em 2022, uma taxa de crescimento anual composta de 26%, e estimou o tráfego nos horários de pico em cerca de 7,2 petabits por segundo, contra uma média próxima de 1 petabit por segundo (Cisco Global IP Traffic Forecast). A diferença entre a média e o pico é o que sobrecarrega e interrompe os links.
O crescimento não estabilizou. O Cloudflare Radar mediu um crescimento de 17,2% no tráfego global da Internet durante 2024 (Cloudflare Radar 2024 in review), o que é suficiente para fazer com que uma linha de base de dois anos atrás descreva uma rede que não existe mais.
O que registrar a cada hora
- Volume por SSID e VLAN, não apenas por uplink, pois um uplink estável oculta o segmento que cresceu.
- Taxa de consultas DNS e proporção de NXDOMAIN, medidas por mil consultas para que a relação se mantenha com o crescimento do tráfego.
- Principais destinos e novas conexões por minuto, registrados em relação à hora da semana e não do dia.
- Contexto do cronograma, para que períodos letivos, noites de eventos e padrões de hotéis aos fins de semana sejam identificados em vez de tratados como anomalias.
Desenvolva a linha de base ao longo de pelo menos duas semanas, cobrindo o comportamento em dias úteis e fins de semana, bem como horários de pico e de calmaria. Defina limites por hora da semana, para que um pico na noite de sexta-feira em um hotel não gere um incidente a cada sete dias.
Três dias consecutivos fora da faixa no mesmo horário merecem investigação. Um ponto fora da curva costuma ser uma transmissão de jogo, a implementação de um software ou a apresentação principal de uma conferência, e isso pertence às anotações, não a um escalonamento.
Como analisar o tráfego quando ele está criptografado
TLS 1.3, QUIC em UDP/443, HTTP/3, VPNs e DNS criptografado colocaram a maior parte das cargas úteis fora de alcance. Qualquer planejamento baseado na leitura do conteúdo da página agora é uma certeza de decepcionar quem o solicitou.
O painel continua útil. Ele responde a perguntas diferentes das que respondia antes.
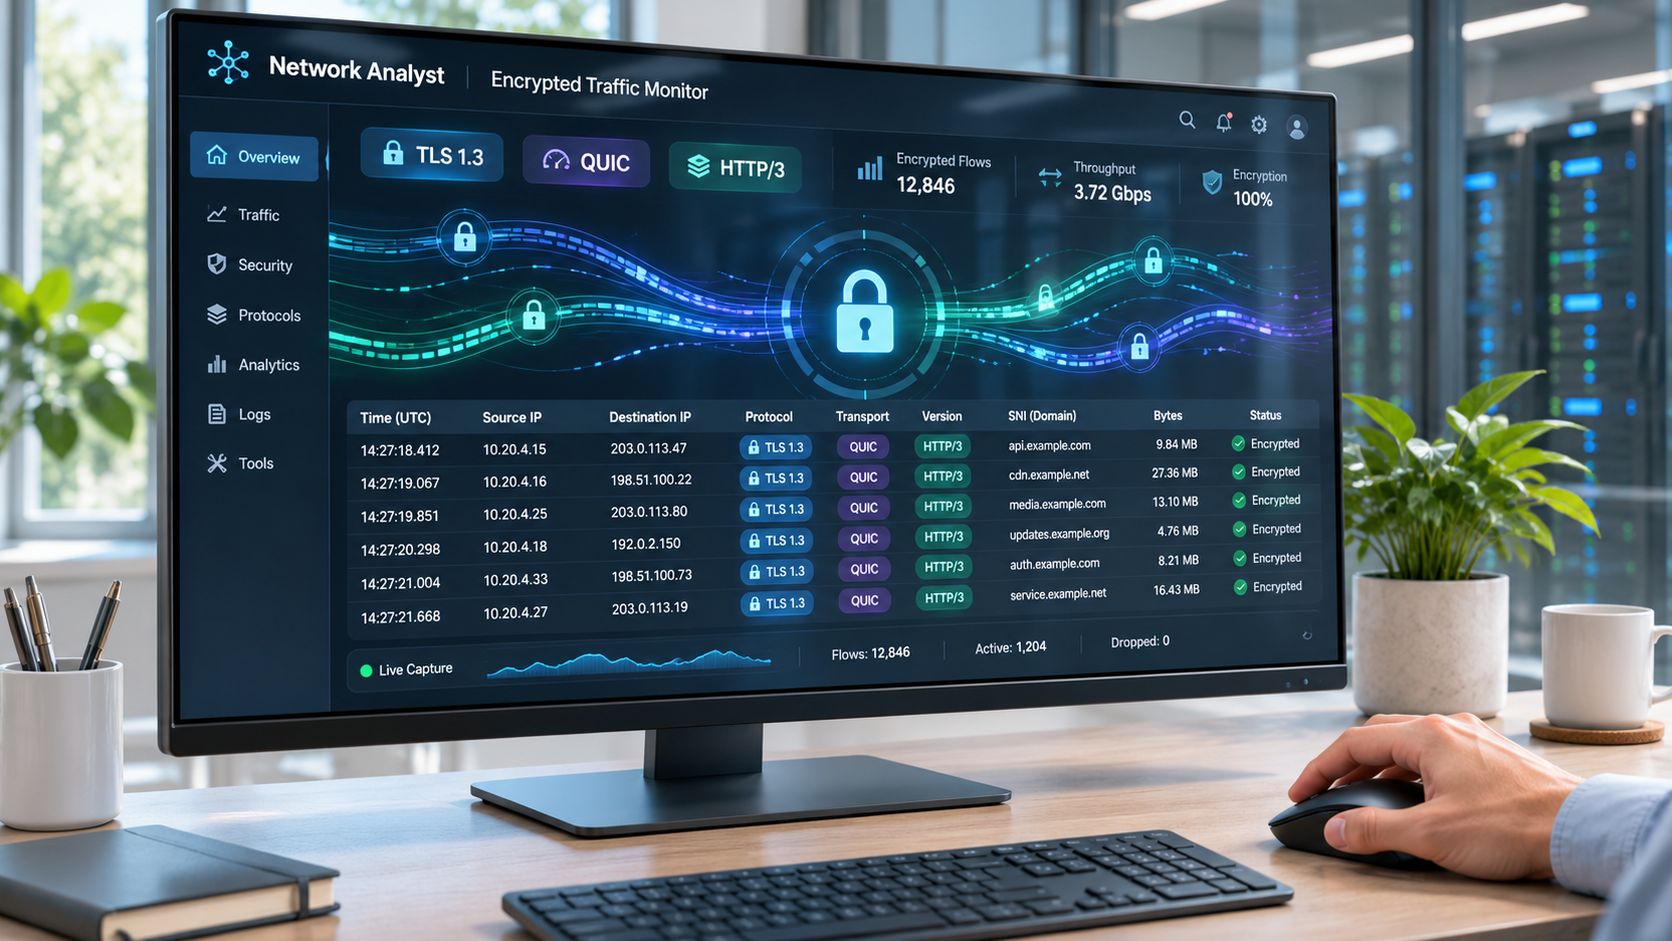
Os metadados revelam mais do que parecem. Pesquisadores que treinaram um modelo em 500 sites com suporte a QUIC identificaram 70% dos sites monitorados com 90% de precisão usando apenas pacotes DNS, subindo para cerca de 80% de recall com 90% de precisão quando o DNS-over-QUIC foi combinado com o tráfego HTTP/3 (pesquisa da A*STAR sobre tráfego criptografado). O tamanho, o tempo e a direção dos pacotes ainda carregam muitas informações.
O que isso suporta é a detecção de anomalias, a classificação de aplicativos e a triagem de ameaças. O que não suporta é uma afirmação sobre o que alguém leu, digitou ou pretendia fazer. Deixe essa distinção explícita antes que alguém prometa a um gestor um relatório sobre o conteúdo da navegação.
Para um passo a passo sobre quanto sobrevive à criptografia em uma captura real:
A avaliação é onde o trabalho com tráfego criptografado costuma falhar. Divida os dados de treinamento e teste por fluxo completo, não por pacote, porque a divisão por pacote vaza dados de sessão quase idênticos em ambos os conjuntos; uma avaliação recente caiu para apenas 40% de precisão quando a separação em nível de fluxo foi aplicada (avaliação da classificação de tráfego criptografado no arXiv).
Os logs do resolvedor são tão bons quanto o ponto onde o DNS termina. Se parte do seu ambiente acessa resolvedores DNS criptografados e endpoints DoH que você não controla, documente essa lacuna em vez de descrever uma visibilidade que você não tem.
Como identificar problemas de segurança e desempenho
Um host enviando beacons para um domínio de comando e controle e um host saturando um link parecem semelhantes em um painel. Ambos geram tráfego. Eles exigem verificações iniciais diferentes, e um palpite errado pode desperdiçar a primeira hora.
Ameaças em uma rede são comuns o suficiente para que você se planeje contra elas. A Akamai relatou em 2023 que entre 10% e 16% das organizações detectaram tráfego de comando e controle em suas redes em qualquer trimestre (pesquisa da Akamai sobre tráfego DNS malicioso). O beaconing é projetado para se parecer com a navegação comum, por isso você o encontra pelo padrão e não pelo volume.
| Sintoma | Causa provável | Primeira verificação |
|---|---|---|
| Navegação lenta em horários de pico | Saturação do link | Utilização por hora em comparação com a linha de base |
| Conexões pequenas e regulares a um domínio desconhecido | Beaconing de comando e controle (C2) | Intervalo de conexão e histórico de DNS do host |
| Upload grande a partir de um host durante a noite | Exfiltração ou backup não programado | Volume de saída habitual do host |
| Pico de respostas NXDOMAIN | Consultas de malware ou falha no resolvedor de DNS | Domínios mais consultados e logs do resolvedor |
| Aumento de retransmissões com utilização normal | Cabo defeituoso ou interferência de WiFi | Contadores de erros e perda de pacotes por AP |
| Consultas repetidas a um único domínio por vários hosts | Aplicativo comprometido ou dispositivo com configuração incorreta | Hosts de origem e reputação do destino |
Qual é a aparência do beaconing em um registro de fluxo
Um dispositivo que se conecta a um único domínio em um intervalo constante, com tamanhos pequenos e consistentes de solicitação e resposta, não se parece em nada com o padrão diurno desse mesmo host. Verifique os intervalos de conexão e o histórico de DNS desse host antes de bloquear qualquer coisa. Uma smart TV buscando atualizações de firmware em um cronograma fixo imitará o mesmo comportamento e fará você perder um dia da sua semana.
Grandes uploads durante a noite exigem contexto, não alarme. Compare o volume de saída do host com seu próprio padrão normal e, em seguida, verifique se a janela de backup mudou ou se um novo cliente de sincronização em nuvem foi instalado. A pergunta útil é se a transferência é incomum para aquele host, não se ela é grande em termos absolutos.
Verifique a lista de bloqueios e o feed de ameaças antes de culpar a rede. Registre a ocorrência com registro de data e hora, host e destino para que a próxima pessoa possa verificá-la em vez de repeti-la. Essa evidência também é o que permite provar o que foi interrompido, em vez de discutir com base em um alerta vago.
Quando o sintoma se revela como congestionamento em vez de comprometimento, as ferramentas mudam. O bloqueio de anúncios e rastreadores na camada de DNS pode reduzir o tráfego da Web em 20% a 40% e acelerar o carregamento de páginas, sem a necessidade de alterações nos dispositivos (Reduzindo o uso de largura de banda). Essa é uma primeira verificação prática, pois reduz a demanda sem alterar a configuração do cliente, enquanto a utilização por hora ainda mostra se a linha de base em si mudou.
Como manter evidências sem coletar dados em excesso
Mais dados de pacotes não garantem automaticamente mais segurança. Capturas completas aumentam o custo de armazenamento, a exposição da privacidade e a carga de trabalho dos analistas, além de continuarem incapazes de ler uma carga útil criptografada. A pergunta que vale a pena fazer sobre cada registro é mais direta: isso contribui para contenção, proteção, auditoria ou solução de problemas?
A visibilidade costuma desaparecer facilmente. Quando o DNS não termina em servidores controlados pela empresa, as organizações perdem visibilidade sobre as consultas e acumulam pontos cegos para exfiltração e atividades de negação de serviço (análise da EfficientIP sobre infraestrutura de DNS). Isso justifica manter as evidências do resolvedor sob seu próprio controle, em vez de capturar tudo.
O conjunto mínimo justificável:
- Carimbo de data/hora e rede ou SSID, para que cada registro seja vinculado a um local e a uma política.
- Categoria da política e ação realizada, incluindo bloqueios e a explicação exibida ao usuário.
- Domínio consultado, classificação da ameaça e integridade do sistema, o que geralmente é suficiente para reconstruir o que aconteceu.
- URLs completas, payloads ou históricos de navegação não são incluídos, a menos que haja uma base jurídica clara e um período de retenção definido.
A retenção é uma decisão, não um padrão. Mantenha os registros resumidos de fluxo e DNS por um período determinado, preserve as capturas completas apenas enquanto um incidente estiver ativo e exclua-as quando o caso for encerrado.
Antes de iniciar a coleta: quem pode ler os registros, por quanto tempo eles são mantidos e o que foi informado aos usuários. Se você não puder responder a essas três perguntas, você tem um hábito de armazenamento, não uma política de governança.
Onde o DNS também faz a filtragem, a camada de relatórios carrega a maior parte das evidências. Vale a pena ler um guia sobre logs e relatórios de filtragem de DNS antes de projetar o formato dos registros, pois adaptar categorias e justificativas de políticas aos logs retroativamente é algo trabalhoso.
Escolha sua primeira configuração de monitoramento
Por onde começar depende do que você está protegendo, e as redes públicas estão se tornando a regra, não a exceção. A Wireless Broadband Alliance relatou em 2025 que 46% dos entrevistados planejavam implantar WiFi público em toda a cidade em 2025 ou 2026, enquanto 15% já haviam implantado essa rede (relatório do setor da WBA 2025).
Para um escritório pequeno, comece com a exportação de fluxo do roteador, logs de DNS e uma linha de base de duas semanas; em seguida, crie um painel mostrando a utilização do link, os maiores emissores de tráfego e a proporção de NXDOMAIN. Essa visualização única responde à maioria das reclamações em dias úteis sem que ninguém precise abrir um arquivo de captura.
Para um local ou campus com várias unidades, adicione visualizações por SSID e por VLAN, limites de janela de tempo e um registro da camada de DNS que registre cada domínio bloqueado junto com a política aplicada a ele. O trabalho adicional está na normalização, não no ferramental.
Para rede pública ou WiFi para visitantes, mantenha a mesma política e registro por SSID e informe claramente aos usuários o que é registrado e por quanto tempo. A transparência não custa nada e resolve a maioria das reclamações antes que cheguem a um gestor.
A captura de pacotes continua sendo uma ferramenta para incidentes ativos, não uma transmissão permanente. Avalie a configuração pela rapidez com que ela responde a uma pergunta: este período de lentidão é capacidade, falha de dispositivo ou uma ameaça?
Purple Shield funciona como DNS protetor em qualquer rede WiFi ou em redes Purple Access, com uma política para cada, e uma rede pode ser protegida gratuitamente por 30 dias.
Escolha uma rede esta semana, faça a captura do seu horário de pico, compare-a com o mesmo horário na linha de base e registre a primeira constatação com seu carimbo de data/hora, host e destino. Esse único documento tem mais valor do que outro painel.
Purple Shield responde a todas as consultas DNS nas redes que protege, verificando os domínios antes que uma conexão seja aberta. O painel exibe o que foi bloqueado, quais ameaças foram contidas e como a rede foi utilizada entre locais e SSIDs. Se você prefere comprovar o que aconteceu por meio de evidências de consultas em vez de executar capturas de pacotes sem interrupção, comece com a avaliação gratuita para uma rede. Acesse Purple Shield para ver como as políticas e os relatórios por SSID funcionariam em sua infraestrutura.