
Guia de rede baseada em nuvem: arquitetura e benefícios
Saiba o que é uma rede baseada em nuvem, como funciona sua arquitetura e como proteger e gerenciar o WiFi em vários locais com menos dispositivos locais.
Published 19 de novembro de 2026
Um convidado pede a senha do WiFi em um dos seus locais. Você a entrega. Em algum escritório nos fundos, um roteador antigo faz o melhor que pode com as regras de firewall definidas em 2019, e ninguém na empresa sabe listar essas regras de cabeça.
Esse cenário se repete em três ou doze locais, e o atrito se acumula: um login de administrador separado para cada equipamento, uma política que existe em um lugar, mas não em outro, e uma quantidade fixa de hardware que fica ociosa no inverno e sobrecarregada no verão. Uma rede baseada em nuvem é a forma como a maioria dos operadores resolve isso. É também onde as perguntas úteis começam, porque mover o controle para a nuvem muda o que continua funcionando quando parte do sistema para.
Sumário
- O que é uma rede baseada em nuvem e como ela se diferencia
- Como as camadas de uma rede baseada em nuvem se integram
- Benefícios, custos e onde a mudança está acontecendo
- Protegendo o tráfego na camada de DNS
- O que continua funcionando quando uma rede baseada em nuvem falha
- Escolha uma configuração e faça um piloto em um local
O que é uma rede baseada em nuvem e quais são seus diferenciais
Imagine uma rede de cafeterias com três unidades. Cada uma opera seu próprio roteador, seu próprio firewall e seu próprio login de administrador, e cada uma foi configurada em uma tarde diferente por quem estivesse disponível. A regra que bloqueia conteúdo adulto existe em duas delas. Ninguém a copiou para a terceira, e ninguém sabe dizer quando isso aconteceu.
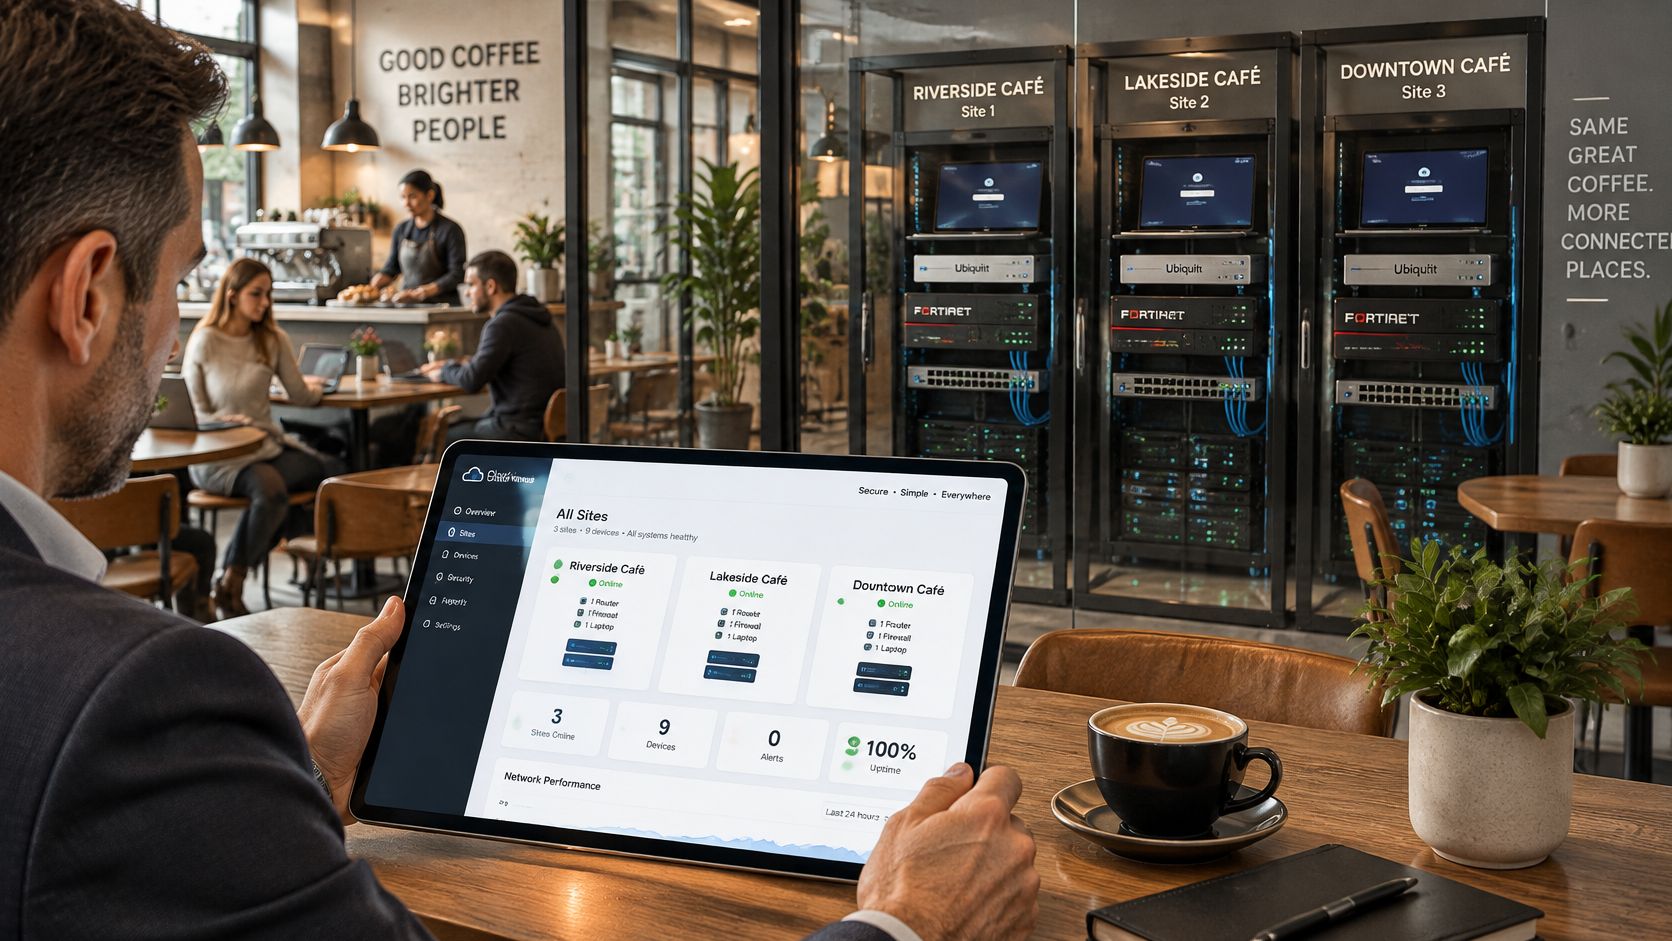
Uma rede baseada em nuvem transfere a inteligência para fora das instalações físicas. Políticas, monitoramento, relatórios e configurações residem em uma plataforma operada pelo provedor. O que permanece no local fica muito mais simples: pontos de acesso, um switch e um conector leve que se comunica com a plataforma. Você faz login uma única vez, visualiza todos os locais e altera uma regra para todos eles simultaneamente.
O U.S. National Institute of Standards and Technology publicou em 2011 a definição em que a maior parte do setor ainda se baseia, descrevendo a computação em nuvem como o acesso sob demanda a um pool compartilhado de recursos configuráveis que podem ser provisionados e liberados com o mínimo de esforço de gerenciamento (NIST). Suas cinco características se traduzem perfeitamente para o contexto de locais físicos. O pool de recursos explica por que você compartilha a infraestrutura com outros clientes em vez de possuí-la. A rápida elasticidade explica por que um local no litoral pode comportar mais capacidade em agosto sem a necessidade de solicitar novos hardwares. O serviço medido explica o painel e o relatório mensal.
Se você estiver decidindo o quanto terceirizar e o quanto manter internamente, o guia de serviços em nuvem gerenciados da CEFCore detalha o que um modelo gerenciado abrange na prática.
As diferenças que realmente importam para um operador de vários locais se resumem a algumas perguntas práticas.
| Aspecto | Rede tradicional | Rede baseada em nuvem |
|---|---|---|
| Onde a política reside | Hardware local em cada localidade | Plataforma central em nuvem, aplicada por local |
| Adição de um novo local | Comprar, enviar e configurar o hardware no local | Integrar o local e aplicar as políticas existentes |
| Gerenciamento | Login de administrador local por dispositivo | Um único painel para todos os locais |
| Escalonamento de capacidade | Atualização ou substituição de hardware | O provedor adiciona capacidade sob demanda |
| Dependência de falhas | Equipamento local e link local | Caminho da Internet somado ao plano de controle do provedor |
Regra prática: se uma alteração em um local tiver que ser repetida manualmente em todos os outros, você está operando uma rede tradicional com uma página de login moderna.
Como as camadas de uma rede baseada em nuvem se conectam
Pense em um edifício de três andares. O último andar é o escritório de administração: este é o plano de controle em nuvem, onde políticas, grupos de usuários e relatórios são definidos. Os funcionários trabalham lá em cima, mas os convidados nunca passam por ali. O plano de controle decide o que deve acontecer. Ele não transporta o tráfego de convidados por si só.
O nível intermediário é o corredor, o plano de dados. O tráfego se move aqui, por meio de pontos de acesso, switches e saídas locais em cada local. É também aqui que você decide quais dispositivos podem se enxergar, e a segmentação de rede é a prática que mantém os celulares dos convidados longe dos terminais de pagamento e os terminais longe dos sistemas de back-office.
O nível inferior é a camada de acesso local: a porta de entrada de cada dispositivo.
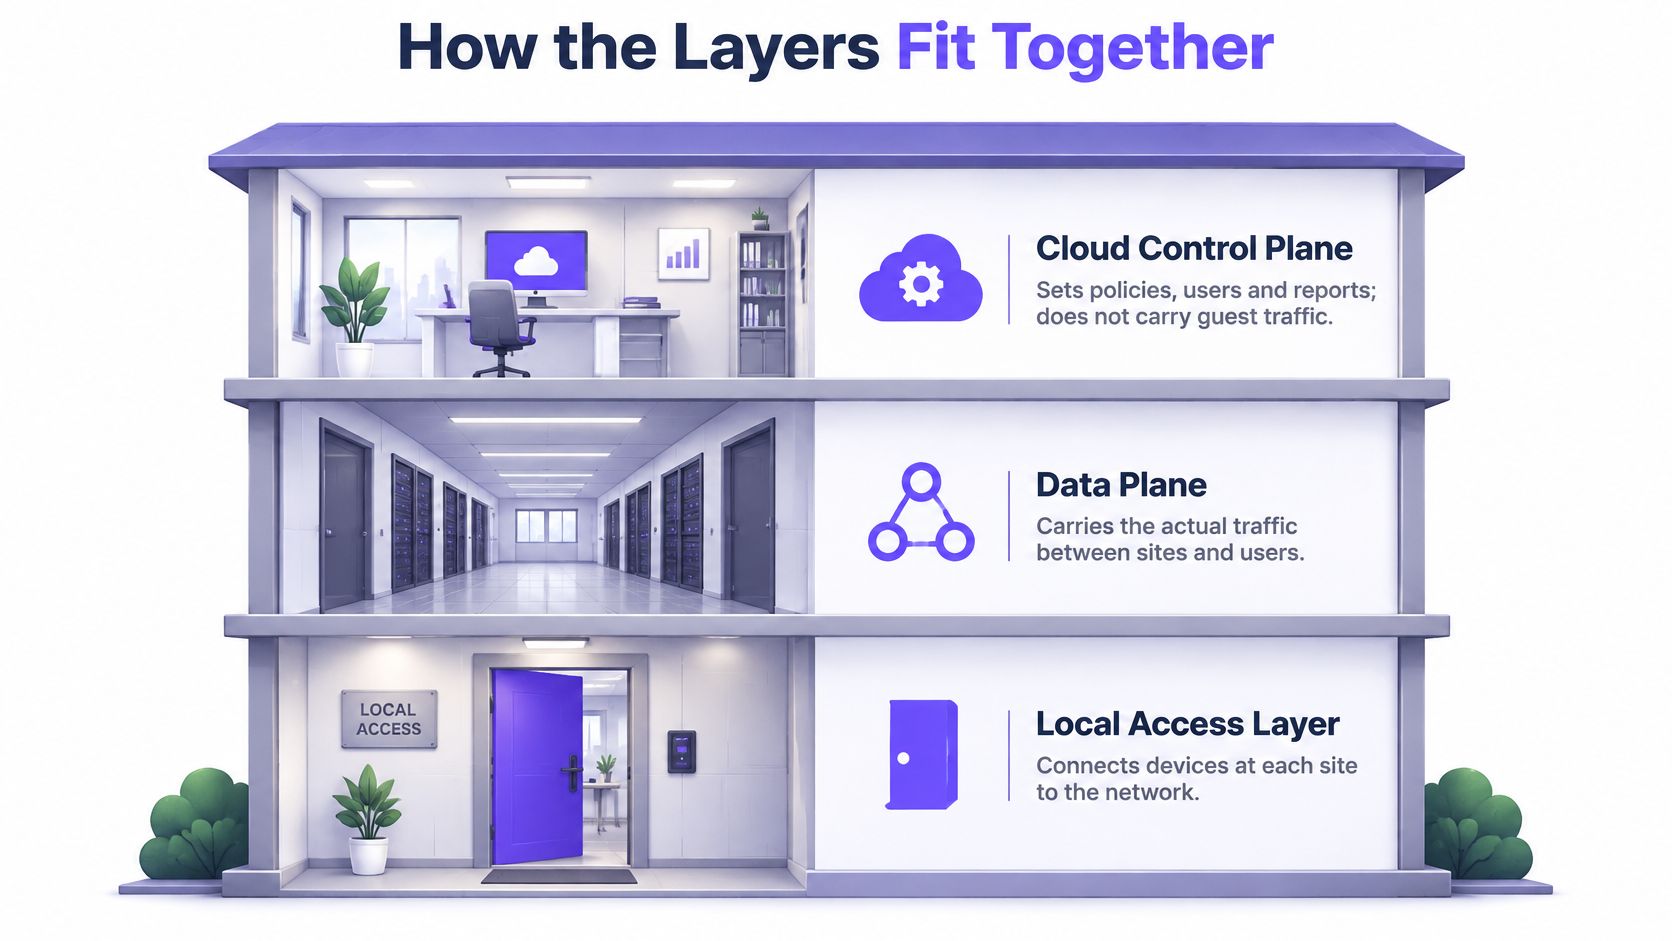
Entre o escritório e o corredor fica o ponto de verificação por onde toda conexão passa primeiro: a camada de DNS. Nada chega ao corredor sem que um nome seja resolvido.
Uma conexão de convidado, passo a passo
- O dispositivo conecta-se ao SSID e o ponto de acesso local o aceita. Isso acontece no local, não na nuvem.
- O dispositivo recebe um endereço IP do DHCP. O endereço vem primeiro, antes de qualquer navegação.
- O dispositivo solicita um nome, e essa consulta vai para o resolvedor na nuvem, em vez de seguir o que estiver codificado no roteador.
- O resolvedor responde com permissão ou bloqueio em milissegundos, com base na política definida para esse SSID.
- Só então a conexão é aberta, seja para uma página da web, um aplicativo ou uma sincronização em segundo plano.
Assim, as três camadas formam uma hierarquia. A política é decidida no topo, a aplicação ocorre no ponto de controle de DNS e o encaminhamento acontece no corredor. A mesma arquitetura aparece muito além do WiFi, e é por isso que a conectividade IoT para máquinas de venda automática se apoia em uma camada de controle em nuvem com comportamento local que sobrevive a uma queda no link.
Uma falha na camada de gerenciamento e uma falha na camada de encaminhamento não são o mesmo evento. Se perder o escritório, você não poderá alterar nada, mas o corredor continuará transportando o tráfego. Se perder o corredor, nenhum painel do mundo ajudará o convidado à sua frente.
Benefícios, custos e para onde a transição está caminhando
A mudança reflete-se primeiro nos gastos. O Gartner previu que os gastos mundiais de usuários finais em serviços de nuvem pública atingiriam US$ 675,4 bilhões em 2024, acima dos US$ 561 bilhões em 2023 - um aumento de 20,4% -, com a infraestrutura como serviço, categoria mais próxima da capacidade de rede virtualizada, projetada para crescer 25,6%, alcançando US$ 180,0 bilhões (Gartner).
A adoção é ampla e não se limita a grandes empresas. O Eurostat constatou que 52,7% das empresas da UE utilizaram serviços pagos em nuvem em 2025, um aumento de 7,4 pontos percentuais em relação a 2023 (Eurostat). O Central Statistics Office da Irlanda registrou que 42,6% das empresas irlandesas adquiriram software de segurança baseado em nuvem em 2025 (Central Statistics Office). Os investimentos também estão se concentrando: 40% das empresas entrevistadas pela Flexera investiram mais de US$ 12 milhões por ano em nuvem pública, contra 36% no ano anterior (Flexera).
Se você prefere assistir a uma demonstração em vez de ler o restante, este vídeo aborda o modelo em poucos minutos.
Para um operador de vários locais, cada benefício vem acompanhado de um custo proporcional.
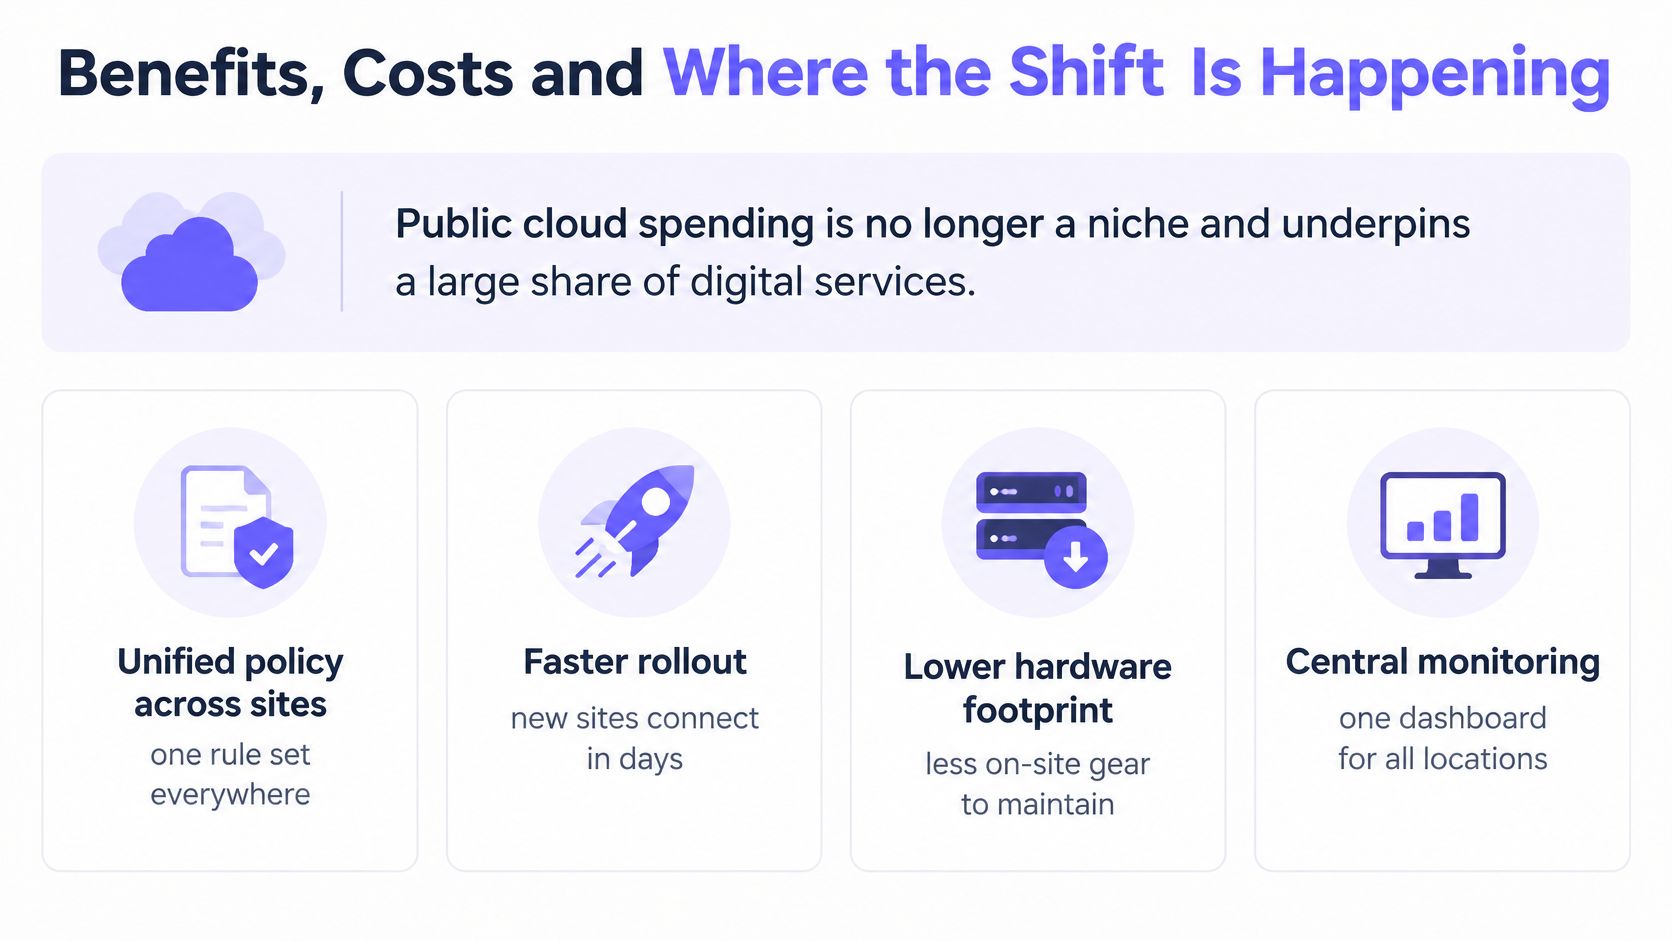
- Integração mais rápida, compensada por taxas recorrentes. Um novo local entra em operação em dias, e não após um pedido de compra e uma visita técnica, mas a assinatura substitui os gastos de capital com hardware, e esse custo nunca cessa completamente.
- Um único conjunto de políticas em todos os lugares, compensado por treinamento. Regras centrais significam que uma alteração de proteção chega a todos os locais em minutos, mas também significam que sua equipe precisa aprender a usar um novo console e confiar nele.
- Logs centrais para auditorias, compensados pela dependência do link. Os relatórios são consolidados a partir de um único local, mas o tráfego ainda passa pela conexão de internet do próprio local, e nenhuma plataforma pode consertar uma linha ruim.
Imagine que uma rede hoteleira com doze propriedades migre de controladoras locais para o gerenciamento centralizado. O onboarding de uma nova propriedade passa a ser um registro na plataforma mais uma política aplicada a partir de um modelo existente, e a administração de rotina deixa de exigir o acesso a doze logins diferentes para se tornar uma única fila de análise.
| Métrica | Valor | Comparativo | Fonte |
|---|---|---|---|
| Gastos globais do usuário final com nuvem pública em 2024 | US$ 675,4 bilhões | US$ 561 bilhões em 2023, aumento de 20,4% | Gartner |
| Gastos com IaaS em 2024 | US$ 180,0 bilhões | US$ 143,3 bilhões em 2023, aumento de 25,6% | Gartner |
| Gastos com PaaS em 2024 | US$ 172,4 bilhões | aumento de 20,6% | Gartner |
| Gastos com SaaS em 2024 | US$ 247,2 bilhões | aumento de 20,0% | Gartner |
| Gastos do usuário final com nuvem pública em 2025 | US$ 723,4 bilhões | previsão posterior após o valor de 2024 | Gartner |
| Empresas da UE que usam serviços de nuvem pagos em 2025 | 52,7% | aumento de 7,4 pontos percentuais em relação a 2023 | Eurostat |
| Empresas irlandesas que adquirem software de segurança baseado em nuvem em 2025 | 42,6% | Apenas Irlanda | Central Statistics Office |
| Empresas que gastam mais de US$ 12 milhões por ano em nuvem pública | 40% | 36% no ano anterior | Flexera 2025 |
Os benefícios são maiores onde os locais são numerosos, semelhantes e administrados por uma equipe pequena. Doze redes de hotéis quase idênticas justificam o gerenciamento centralizado. Um prédio atípico com equipamentos sob medida pode não justificar.
Como proteger o tráfego na camada de DNS
O DNS é o estágio inicial mais viável para recusar algo. Um domínio pode ser rejeitado durante a resolução de nomes, antes que o dispositivo tenha um endereço de destino e antes do início de uma sessão web, TLS ou de comando e controle. A essa altura, o dispositivo já possui um endereço IP - ele só não possui o endereço que desejava.
Uma camada de DNS em nuvem desempenha três funções, e vale a pena nomeá-las separadamente porque os fornecedores costumam confundi-las.
- Filtragem por categoria. Conteúdo adulto, jogos de azar, hospedagem de malware ou o que a política determinar, aplicado por SSID para que a rede da equipe e a sala de leitura infantil não compartilhem o mesmo conjunto de regras.
- Bloqueio de ameaças. Domínios de phishing, hosts de distribuição de malware e retornos de comando e controle, interrompidos na consulta em vez de ocorrerem após a entrega do payload.
- Remoção de anúncios e rastreadores. Menos solicitações de terceiros significam páginas mais leves e menor consumo de dados no telefone do convidado.
O que precisa ser protegido para que isso funcione
O DNS seguro possui três requisitos distintos, frequentemente vendidos como um só: integridade, confidencialidade e disponibilidade. O DNSSEC abrange a integridade ao validar que uma resposta assinada não foi adulterada. A confidencialidade é mais fácil de passar despercebida, pois até mesmo uma resposta correta pode vazar a pergunta quando as consultas trafegam em texto simples. A disponibilidade exige um plano próprio; por isso, os operadores ainda mantêm resolvedores dispersos, tolerância a falhas e mais de um resolvedor recursivo na configuração.
Isso fornece um checklist direto para qualquer rede pública ou de convidados:
- Encaminhe todo o DNS do cliente para resolvedores que você controla, em vez de permitir que os dispositivos escolham os seus próprios.
- Evite desvios onde o hardware permitir, bloqueando o DNS de saída para outros servidores.
- Valide as respostas DNSSEC para que respostas falsificadas sejam rejeitadas.
- Proteja o transporte de consultas onde regras de privacidade se aplicarem, para que as consultas não fiquem legíveis em trânsito.
- Retenha logs pelo tempo necessário para identificar o que um dispositivo tentou acessar e quando.
Cada item é um modo de falha a ser testado antes que um incidente faça isso por você. Aponte um dispositivo para um resolvedor externo e verifique se a regra de bypass o captura. Em seguida, pergunte o que acontece quando os resolvedores param de responder: o modo "fail-open" mantém os convidados online, mas descarta todas as políticas, e o "fail-closed" mantém as políticas, mas transforma uma falha de resolvedor em uma interrupção. O Purple Shield opera em modo "fail-closed" e é executado em múltiplos data centers, de modo que uma falha em um deles não derruba o serviço.
Leia o log antes de confiar no filtro. Uma página de bloqueio não prova nada por si só. O registro de consulta prova o que foi recusado, para qual rede e em que horário.
A filtragem de DNS atua lado a lado com a proteção de endpoints, firewalls e controles de aplicativos, e a justificativa para a segurança de DNS como camada de controle baseia-se no fato de ela ser uma camada entre várias, e não um substituto para as demais.
O que continua funcionando quando uma rede baseada em nuvem falha
Um local pode perder o acesso ao seu painel em nuvem e ainda assim continuar transmitindo tráfego. Ele também pode manter o painel e perder o caminho de DNS que aplica a filtragem. Essas falhas parecem semelhantes à distância, mas afetam partes diferentes da rede. Planeje a arquitetura para cada uma delas separadamente.
Uma pesquisa do setor revelou que 60% dos profissionais de TI enfrentaram uma interrupção de rede em nuvem nos 12 meses anteriores. Entre as causas relatadas estavam falhas no provedor de nuvem, erro humano, integrações com terceiros, ataques cibernéticos e erros de configuração (Pesquisa do setor Aviatrix 2025).
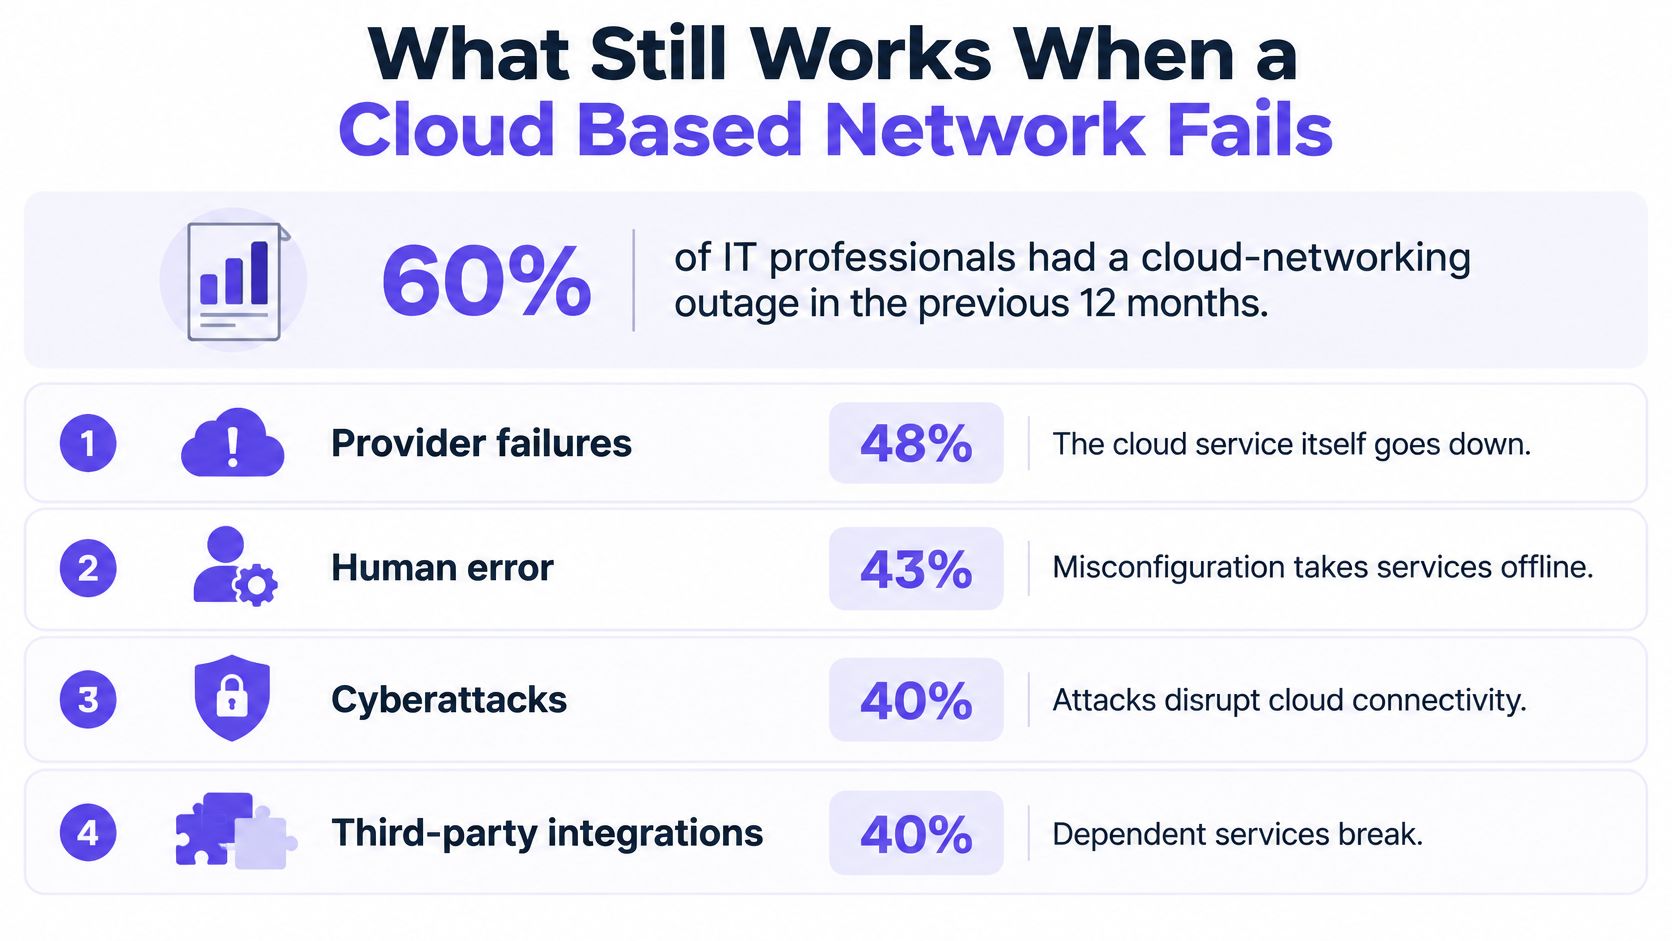
O índice de uptime de um provedor descreve sua plataforma, não se o seu local consegue continuar aplicando políticas quando essa plataforma estiver inacessível. O painel é a sala de controle; os equipamentos no local ainda precisam transportar o tráfego e aplicar as regras já recebidas.
Um SLA descreve o que o provedor promete. Ele não diz o que seus pontos de acesso farão quando o plano de controle estiver inacessível.
Duas interrupções que parecem iguais, mas não são
Se o plano de gerenciamento falhar, talvez você não consiga alterar políticas, visualizar novos relatórios ou integrar um local. O tráfego e a aplicação existentes podem continuar porque as regras já foram enviadas para a borda da rede.
Se a camada de aplicação - geralmente o DNS ou o caminho do resolvedor - falhar, os usuários perceberão imediatamente. Alguns sites podem parar de resolver; como alternativa, tudo pode resolver porque a filtragem foi ignorada.
Essa é a escolha entre fail-open e fail-closed. O fail-open restaura a conectividade por meio de resolução recursiva comum se o serviço em nuvem estiver indisponível, mas os controles de proteção deixam de ser aplicados. O fail-closed mantém a política em vigor, mas uma falha de DNS também pode bloquear serviços legítimos, como pagamentos com cartão ou sistemas de reservas, a menos que a rede disponha de mecanismos de redundância testados. Nenhum dos dois comportamentos atende a todos os locais. O aspecto importante é saber qual deles a sua rede utiliza e o que os usuários irão vivenciar (guia de filtragem fail-open versus fail-closed).
Planeje a contingência antes de precisar dela
Configure mais de um resolvedor e monitore a integridade deles. Identifique os serviços que precisam permanecer disponíveis e teste um caminho de fallback para eles. Se os convidados perderem o acesso à internet, faça com que o portal cativo explique a interrupção em vez de deixá-los esperando com um ícone de carregamento.
O gerenciamento em nuvem não elimina os equipamentos no local. Pontos de acesso, switches e o link de internet do estabelecimento continuam fazendo parte do serviço, e uma falha no link ainda pode desconectar o local. A emissão de relatórios também depende de logs, de uma janela de retenção e de um formato que a equipe consiga interpretar.
| Falha | O que continua funcionando | Comportamento da política | Teste antes da entrada em operação |
|---|---|---|---|
| Interrupção no plano de gerenciamento em nuvem | Tráfego existente e aplicação, se as regras já estiverem em vigor | Normalmente inalterado | Interrompa o acesso de gerenciamento e confirme se o tráfego continua fluindo |
| Interrupção no resolvedor de DNS | Cache local e resolvedores secundários, se configurados | Fail-open ou fail-closed, dependendo da configuração | Bloqueie o resolvedor primário e confirme se o secundário responde |
| Link de internet do local inoperante | Apenas serviços locais | Não se aplica | Desconecte o link WAN e confirme se a mensagem de fallback é exibida |
| Falha na operadora ou no provedor de upstream | Tráfego em um caminho alternativo, se houver | Inalterado se um segundo caminho o suportar | Simule a perda de upstream e verifique a rota de failover |
| Interrupção no provedor de identidade | SSIDs abertos ou com chave pré-compartilhada | O acesso autenticado pode parar | Teste o fallback de login para colaboradores e convidados |
Três etapas para validar o funcionamento
- Execute cada teste em um local. Faça isso durante o horário de funcionamento, para que você possa observar o que os convidados vivenciam, bem como o que a rede relata.
- Registre o resultado. Anote o que continuou funcionando, se a política falhou em modo aberto ou fechado, a data e quem executou o teste.
- Repita após mudanças nas políticas. Um novo conjunto de regras pode alterar a forma como o fallback se comporta.
Os custos de assinatura e a dependência do link de internet afetam o que você pode implantar, mas não respondem o que acontece durante uma interrupção. Se você só puder testar um local, comece por aquele com mais convidados ou com o dever de diligência mais rigoroso.
Escolha uma configuração e realize um piloto em um local
Antes de comparar produtos, defina o propósito da sua rede. A ordem das prioridades importa mais do que a ferramenta.
- Liste cada local e cada grupo que o utiliza. Convidados, colaboradores, alunos, residentes, planos pagos. Coloque a lista no papel; a maioria dos operadores descobre dois grupos dos quais havia se esquecido.
- Dê a cada grupo o seu próprio SSID ou VLAN desde o primeiro dia. Uma rede corporativa compartilhando um conjunto de regras com uma rede de convidados é um incidente de proteção à espera de acontecer. O onboarding deve fornecer a cada rede de clientes sua própria política, separadamente para convidados, colaboradores, alunos, residentes e planos pagos.
- Marque os testes de falha que importam para você. Perda do plano de gerenciamento, failover de DNS, uma WAN desconectada, perda de upstream e interrupção do provedor de identidade. Se um teste não for aplicável, indique expressamente em vez de apenas omiti-lo.
- Faça um projeto-piloto em uma única rede e registre os resultados antes de qualquer implementação mais ampla. Um local, uma semana, uma página de conclusões.
Purple Shield se encaixa após esse trabalho, e não no lugar dele. Uma única camada de DNS filtra conteúdo, bloqueia ameaças e remove anúncios em todos os dispositivos de todas as redes, com uma política por SSID, VLAN e local, além de um painel unificado. Você pode testá-lo gratuitamente por 30 dias em uma rede ou fazer um piloto de um único SSID planejado com nossa equipe para só então receber uma cotação personalizada.
Portanto, escolha um local esta semana. Mapeie seus grupos de usuários, preencha a tabela de falhas apenas para esse local e agende o piloto assim que souber o que sua rede deve fazer quando algo falhar.
Purple Shield é uma solução de DNS de proteção e filtragem de conteúdo desenvolvida para redes de locais físicos, de convidados e públicas de WiFi, funcionando de forma independente em qualquer rede WiFi ou em conjunto com o Purple Access, com uma política dedicada para cada SSID, VLAN e local físico, além de relatórios que mostram exatamente o que foi bloqueado. Ela opera em múltiplos data centers e tem comportamento "fail-closed", de modo que um problema no resolvedor não desativa suas proteções. Inicie um teste gratuito de 30 dias em uma rede em Purple Shield e coloque os testes de falha em prática antes de assinar qualquer contrato.