
Analisar o tráfego de rede: capturar, ler e resolver problemas
Aprenda a analisar o tráfego de rede passo a passo: capture dados, crie uma base de referência, leia fluxos encriptados e identifique problemas de segurança ou desempenho.
Published 20 de novembro de 2026
São 14h10 de uma terça-feira e a receção já ligou duas vezes a queixar-se de WiFi lento. Nada foi alterado durante a noite. Os pontos de acesso estão operacionais, o gráfico do uplink está muito semelhante ao de ontem e o fornecedor afirma que o circuito está impecável. Tem cerca de vinte minutos antes que alguém decida que o problema é da responsabilidade da equipa de rede.
Esses vinte minutos são o objetivo da análise de tráfego. Não para recolher todos os pacotes, mas para comprovar rapidamente um pequeno conjunto de aspetos: se a ligação está saturada, se um dispositivo está a comportar-se de forma anómala, se algo interno está a comunicar com um anfitrião com o qual não deveria ou se a queixa está apenas relacionada com a cobertura num determinado canto do edifício.
A ordem é importante. Defina as métricas certas, realize uma captura que responda a uma pergunta, crie uma linha de base com a qual possa comparar e mantenha registos que não hesite em defender.
Índice
- Métricas de Tráfego a Monitorizar e o Seu Significado
- Como Capturar Tráfego Passo a Passo
- Construir uma Linha de Base para o Tráfego Normal
- Interpretar o Tráfego Quando Este Está Encriptado
- Identificar Problemas de Segurança e Desempenho
- Manter Evidências Sem Recolher Dados em Excesso
- Escolha a Sua Primeira Configuração de Monitorização
Métricas de tráfego a acompanhar e o que significam
Um WiFi lento às 14h raramente significa que a rede avariou. Geralmente significa uma de três coisas: a procura atingiu o pico, um único dispositivo começou a fazer algo incomum ou um anfitrião na rede começou a comunicar com um destino indevido. Pode distinguir essas possibilidades com um pequeno conjunto de métricas que provavelmente já recolhe.
A população de dispositivos torna isto mais difícil do que costumava ser. A previsão de 2017 a 2022 da Cisco projetou que o tráfego fixo e de WiFi alcançaria 51% do tráfego IP total até 2022, face a 43% em 2017, e que os dispositivos que não são PC gerariam 81% do tráfego IP global (previsão global de ligações da Cisco). Telemóveis, Smart TVs, caixas registadoras e controladores de edifícios transportam agora a maior parte do volume, e nenhum deles consta num registo de ativos.
| Métrica | O que revela | Sinal de aviso |
|---|---|---|
| Utilização da ligação | O quão cheia está uma ligação ao longo do tempo | Sustentada acima de 70-80% da capacidade |
| Top talkers | Hosts ou SSIDs que utilizam o maior volume | Um único dispositivo a consumir uma quota desproporcionada |
| Distribuição de protocolos e portas | Se o tráfego corresponde aos serviços que espera | Portas ou protocolos inesperados em grande escala |
| Volume de consultas DNS | Atividade de resolução por host | Picos repentinos ou resoluções repetidas de um único domínio |
| Percentagem de NXDOMAIN | Falhas na resolução de nomes | Percentagem crescente, frequentemente associada a malware ou configuração incorreta |
| Novas ligações por minuto | Taxa de criação de sessões | Subida acentuada sugestiva de rastreio (scanning) ou flooding |
| Retransmissões | Pacotes perdidos ou repetidos | Acima de 1-2% dos pacotes |
| Latência e jitter | Atraso e grau de variação do mesmo | Jitter que degrada chamadas de voz ou vídeo |
Interprete essa lista como uma ordem de triagem e não como uma tabela de pontuação. Às 14:00, comece pela utilização da ligação para essa hora e compare-a com a mesma hora em semanas normais. Se a utilização estiver no pico habitual e as retransmissões forem normais, a causa é a capacidade, e a solução passa por agendamento, modelação de tráfego ou mais largura de banda, em vez de uma caça ao malware.
Se a utilização for normal e um único dispositivo dominar os maiores consumidores de tráfego, esse dispositivo é o seu próximo alvo de verificação, e não a ligação ascendente. Se as retransmissões aumentarem enquanto a utilização permanece estável, pare de analisar o tráfego e comece a inspecionar a infraestrutura: um cabo com falhas, uma incompatibilidade de duplex ou um ponto de acesso a combater interferências num canal congestionado.
A regra que acaba com as discussões: nenhuma leitura isolada prova o que quer que seja. Um número só tem significado quando comparado com o intervalo normal do mesmo local à mesma hora.
Como capturar tráfego passo a passo
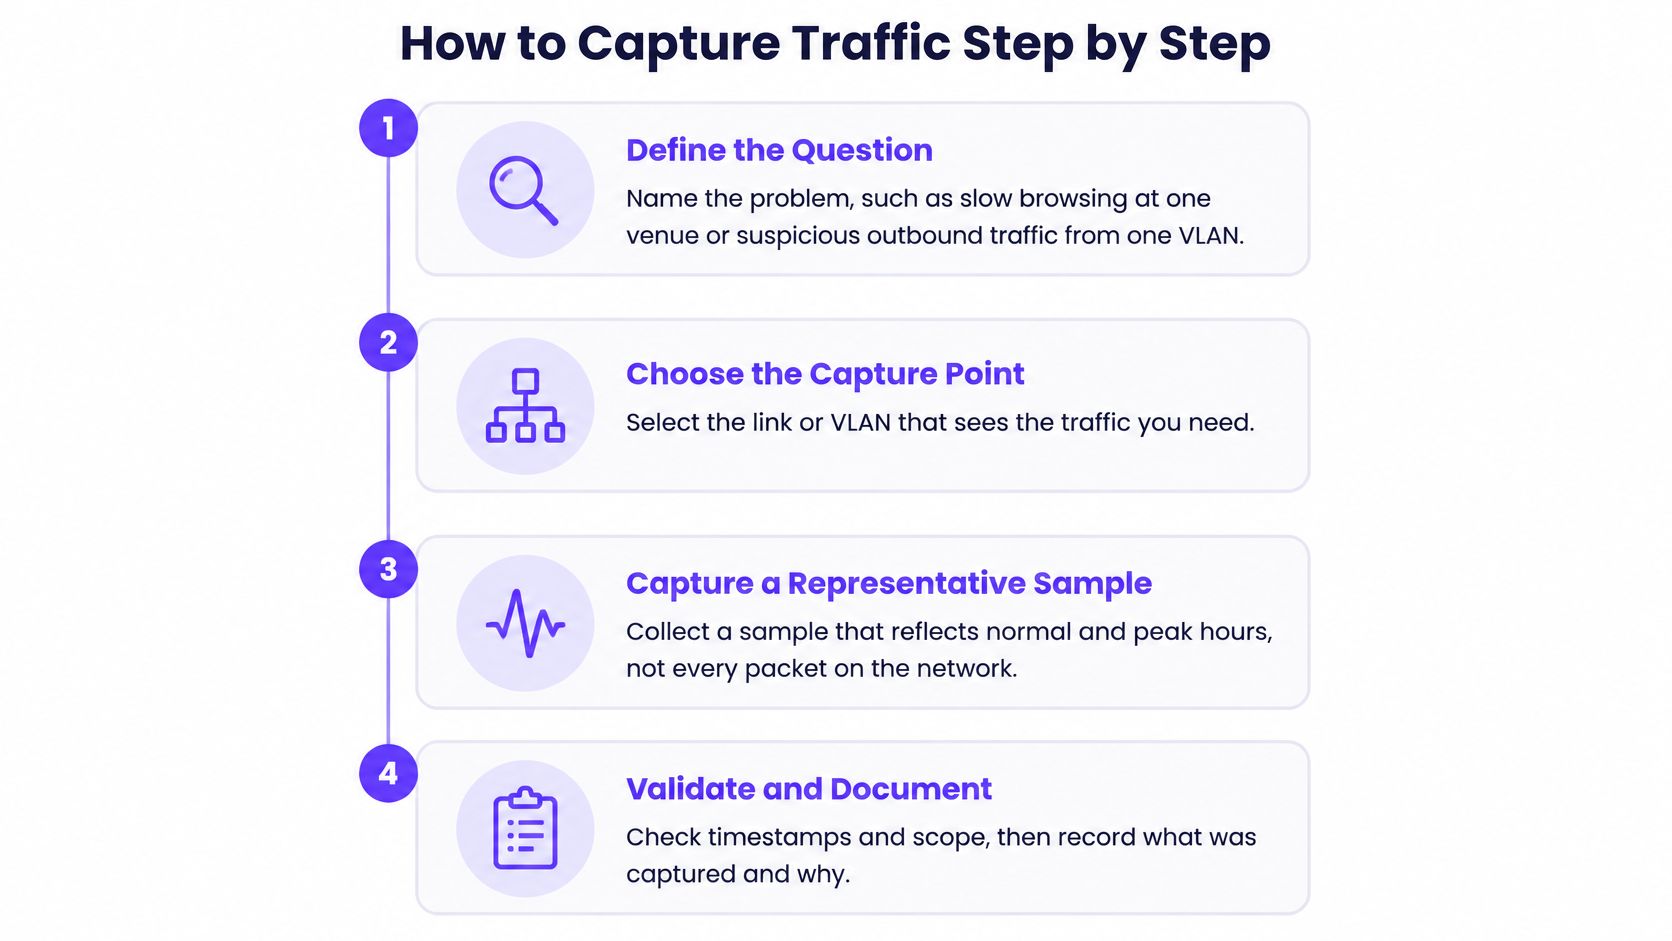
O objetivo é uma amostra representativa, não uma cópia da rede. Vinte minutos obtidos no momento certo superam uma semana de ficheiros que ninguém abre, e continuam a ser suficientemente pequenos para partilhar com um colega.
Defina a questão. "Navegação lenta no SSID de convidados num determinado local" e "tráfego de saída inesperado a partir da VLAN de pagamentos" exigem diferentes pontos de captura, filtros e durações. Registe a questão por escrito antes de iniciar sessão num comutador. O erro comum é capturar primeiro e esperar que a questão se revele no ficheiro.
Escolha um ponto que veja ambos os sentidos. Uma porta SPAN no comutador, um TAP inline no uplink ou a exportação de fluxos a partir do router ou da firewall. A exportação de fluxos é a forma mais económica de monitorizar um local continuamente, e a captura de pacotes é a solução a recorrer quando os fluxos mostram algo anómalo. Espelhar uma porta que suporta apenas uma direção resulta em apenas metade de uma conversa e numa contagem de retransmissões sem qualquer significado.
Filtre antes de gravar. Restrinja a captura a uma sub-rede, VLAN ou anfitrião. Isto mantém o ficheiro suficientemente pequeno para ser aberto em segundos e impede a recolha de tráfego de colaboradores e convidados que não fazem parte do problema.
Capture durante um intervalo fixo. Quinze a trinta minutos durante a hora de ponta e, em seguida, uma captura mais curta durante um período calmo. O par viabiliza uma comparação posterior; uma captura isolada é apenas um caso anedótico.
Inclua o local, a data e a hora no nome do ficheiro. Isto parece trivial até se deparar com quarenta capturas e não conseguir identificar qual foi o local que contactou o suporte.
Analise com filtros de apresentação, não através de deslocamento manual. Comece pela Hierarquia de Protocolos e pelas Conversas para identificar o que está presente e, em seguida, foque-se nas retransmissões ou pesquisas de nomes. Percorrer manualmente uma captura movimentada é o motivo pelo qual muitos concluem erradamente que não há qualquer problema.
Registe o contexto juntamente com o ficheiro. Ponto de captura, filtro, temporização, o que os utilizadores reportaram e o que já foi excluído.
Um hábito torna os dados utilizáveis mais tarde. Normalize os fluxos por interface, SSID ou VLAN, local, janela temporal e direção, e tenha em conta o NAT, o encaminhamento assimétrico, o encapsulamento e os dispositivos partilhados antes de definir qualquer limiar (guia da Vectra para análise de tráfego encriptado). O contexto de rede não é ruído em torno da análise, faz parte dela.
Se pretender toda a rotina numa única página para a equipa, esta é a sequência:
| Ponto de captura | Ideal para | Compromisso |
|---|---|---|
| Porta SPAN ou espelho (mirror) | Captura de pacotes de uma porta ou VLAN | Apenas vê o tráfego espelhado e pode perder uma das direções |
| TAP de rede | Captura total de pacotes numa única ligação | Hardware dedicado; captura ambas as direções com fiabilidade |
| Exportação de fluxos (NetFlow, sFlow, IPFIX) | Monitorização a longo prazo a partir do router ou firewall | Mais económica; mantém resumos de fluxos e não pacotes |
Criar uma linha de base para o tráfego normal
Um número só se torna um sinal quando se sabe qual é habitualmente esse valor. As linhas de base são ignoradas por serem enfadonhas, e o custo surge mais tarde sob a forma de uma fila de alertas que todos colocam em silêncio.
Monitorizar os totais em tempo real é a parte mais simples. Saber que totais estão errados para esta hora neste local é a outra parte.
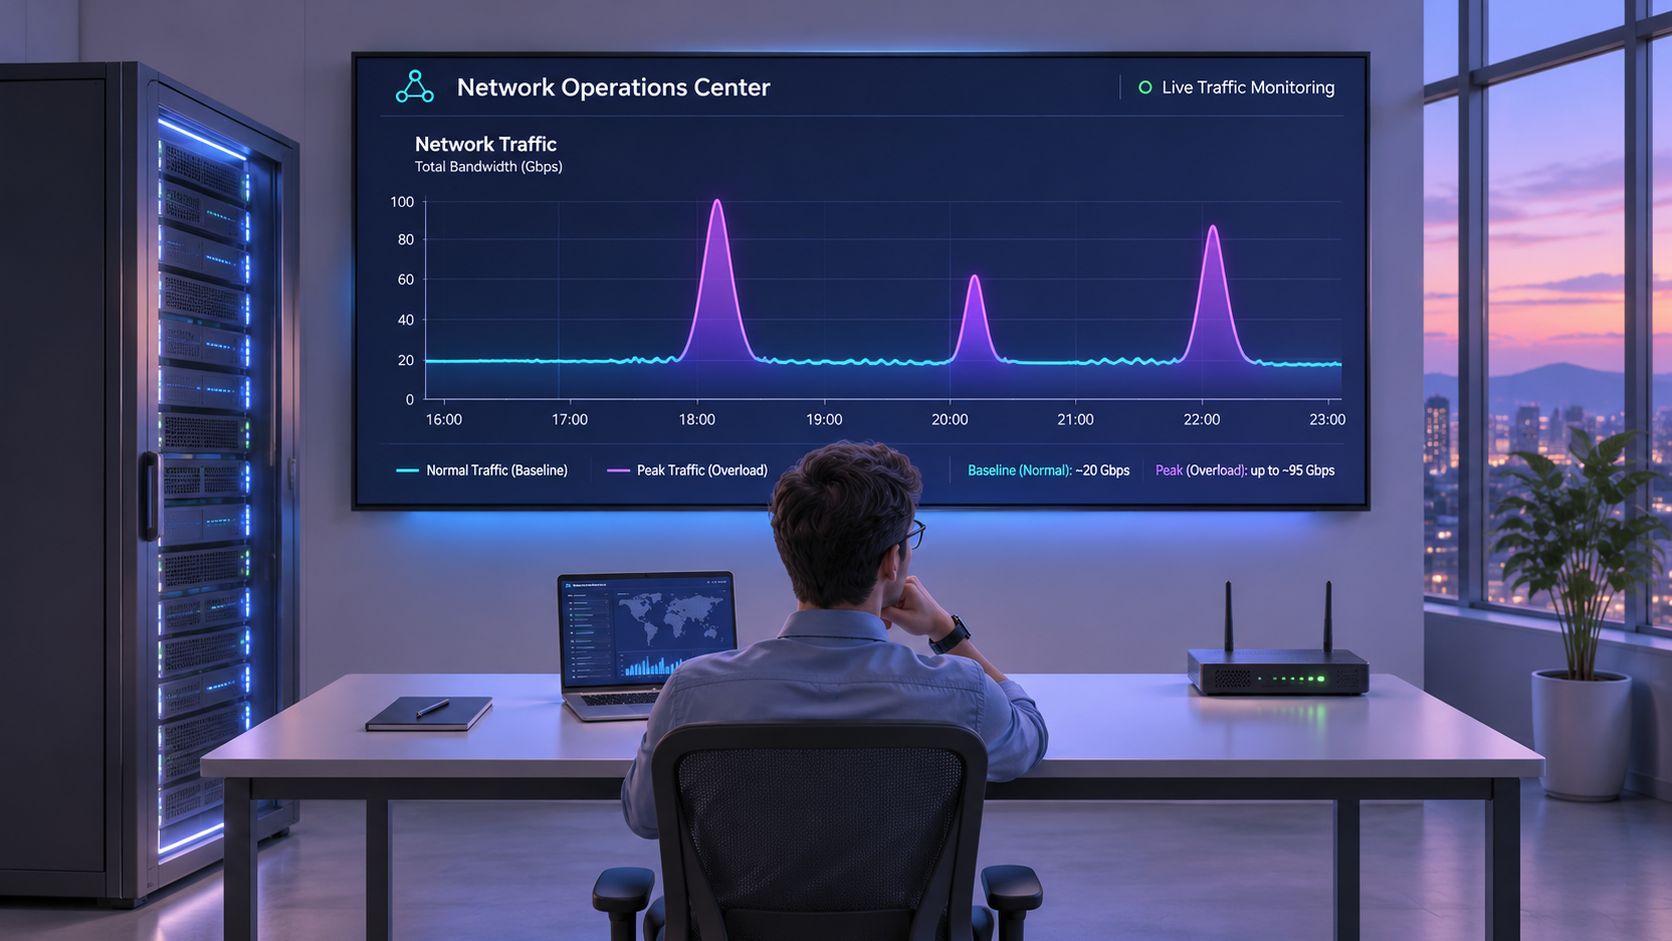
O crescimento faz com que qualquer linha de base expire rapidamente. A previsão da Cisco projetava um aumento do tráfego IP mundial de 122,4 exabytes por mês em 2017 para 396,0 exabytes por mês em 2022, uma taxa de crescimento anual composta de 26%, e situava o tráfego nas horas de ponta em cerca de 7,2 petabits por segundo face a uma média próxima de 1 petabit por segundo (Cisco Global IP Traffic Forecast). O desvio entre a média e o pico é o que sobrecarrega as ligações.
O crescimento ainda não estabilizou. O Cloudflare Radar registou um crescimento de 17,2% no tráfego global da Internet durante 2024 (Retrospetiva de 2024 do Cloudflare Radar), o que é suficiente para fazer com que uma linha de base com dois anos descreva uma rede que já não existe.
O que registar a cada hora
- Volume por SSID e VLAN, e não apenas por uplink, porque um uplink estável oculta o segmento que cresceu.
- Taxa de consultas de DNS e quota de NXDOMAIN, medidas por mil consultas para que o rácio se mantenha perante o crescimento do tráfego.
- Principais destinos e novas ligações por minuto, registados em função da hora da semana e não do dia.
- Contexto temporal, para que períodos letivos, noites de eventos e padrões hoteleiros de fim de semana sejam etiquetados em vez de tratados como anomalias.
Crie ao longo de, pelo menos, duas semanas, abrangendo o comportamento em dias úteis e fins de semana, bem como horas de maior e menor movimento. Defina limites por hora da semana, para que um pico numa sexta-feira à noite num hotel não crie um incidente a cada sete dias.
Três dias consecutivos fora do intervalo previsto para a mesma hora justificam investigação. Um valor atípico isolado é habitualmente a transmissão de um jogo, a implementação de software ou uma apresentação de conferência, devendo constar das notas e não de um processo de escalamento.
Interpretar o tráfego quando este está encriptado
O TLS 1.3, o QUIC em UDP/443, o HTTP/3, as VPNs e o DNS encriptado colocaram a maior parte dos dados fora de alcance. Qualquer plano assente na leitura do conteúdo das páginas é agora um plano destinado a desiludir quem o solicitou.
O painel continua a ser útil. Apenas responde a perguntas diferentes daquelas a que costumava responder.
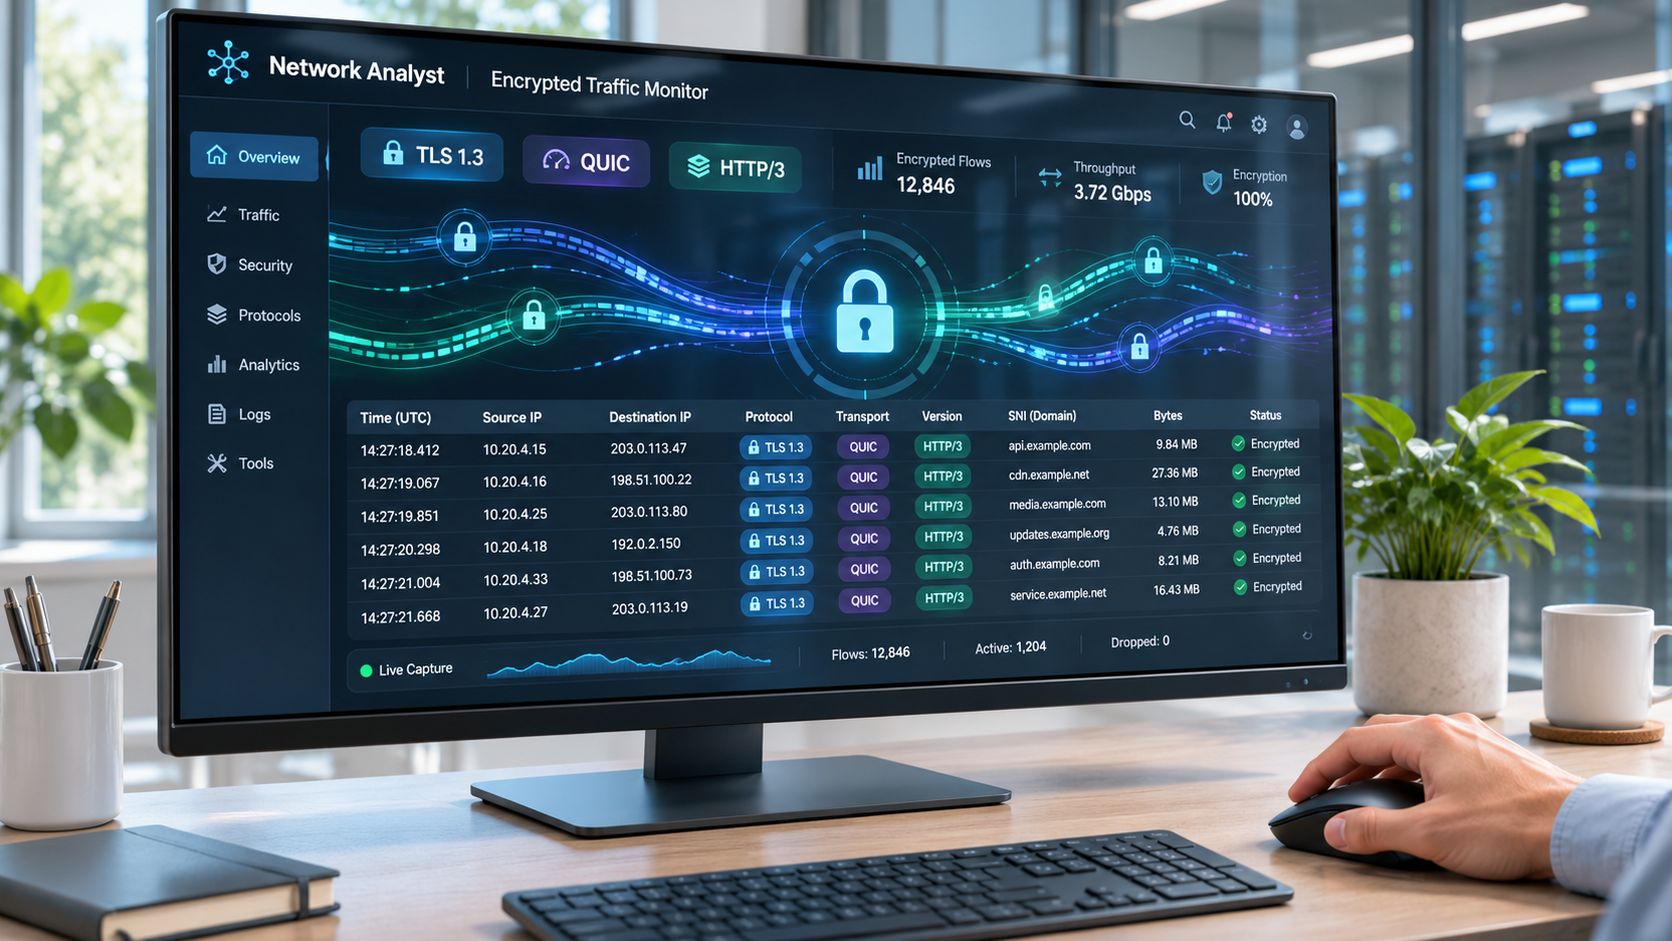
Os metadados revelam mais do que aparentam. Investigadores que treinaram um modelo em 500 sites com suporte a QUIC identificaram 70% dos websites monitorizados com 90% de precisão recorrendo apenas a pacotes DNS, subindo para cerca de 80% de capacidade de recuperação (recall) com 90% de precisão quando o DNS-over-QUIC foi combinado com tráfego HTTP/3 (investigação da A*STAR sobre tráfego encriptado). O tamanho, a temporização e a direção dos pacotes continuam a transmitir muita informação.
Isto suporta a deteção de anomalias, a classificação de aplicações e a triagem de ameaças. O que não suporta é qualquer afirmação sobre o que alguém leu, escreveu ou pretendia fazer. Torne essa distinção explícita antes que alguém prometa a uma chefia um relatório sobre conteúdos de navegação.
Para uma demonstração detalhada do que permanece legível após a encriptação numa captura real:
A avaliação é o momento em que o trabalho sobre tráfego encriptado geralmente falha. Divida os dados de treino e de teste por fluxo completo, não por pacote, porque a divisão por pacote liberta dados de sessão quase idênticos para ambos os conjuntos; uma avaliação recente caiu para apenas 40% de precisão quando a separação ao nível do fluxo foi aplicada (avaliação da classificação de tráfego encriptado no arXiv).
Os registos do resolver dependem inteiramente do local onde o DNS termina. Se parte da sua infraestrutura alcança resolvers de DNS encriptados e endpoints de DoH que não controla, documente essa lacuna em vez de descrever uma visibilidade que não tem.
Identificar problemas de segurança e de desempenho
Um anfitrião a enviar sinais (beaconing) para um domínio de comando e controlo e um anfitrião a sobrecarregar uma ligação parecem semelhantes num dashboard. Ambos geram tráfego. Exigem primeiras verificações distintas e uma suposição errada pode desperdiçar a primeira hora.
As ameaças numa rede são suficientemente comuns para serem planeadas. A Akamai indicou em 2023 que entre 10% e 16% das organizações detetaram tráfego de comando e controlo nas suas redes em qualquer trimestre (investigação da Akamai sobre tráfego DNS malicioso). O beaconing é concebido para se assemelhar à navegação normal, pelo que a sua identificação é feita através de padrões e não por volume.
| Sintoma | Causa provável | Primeira verificação |
|---|---|---|
| Navegação lenta em horas de ponta | Saturação da ligação | Utilização por hora face à referência base |
| Ligações pequenas regulares a um domínio desconhecido | Comunicação periódica de comando e controlo (beaconing) | Intervalo de ligação e histórico de DNS do anfitrião |
| Upload de grandes dimensões a partir de um anfitrião durante a noite | Exfiltração ou cópia de segurança não programada | Volume habitual de tráfego de saída do anfitrião |
| Pico de respostas NXDOMAIN | Consultas de software malicioso ou falha no resolvedor | Domínios mais consultados e registos do resolvedor |
| Aumento de retransmissões com utilização normal | Cabo danificado ou interferência de WiFi | Contadores de erros e perdas por AP |
| Consultas repetidas a um domínio por múltiplos anfitriões | Aplicação comprometida ou dispositivo mal configurado | Anfitriões de origem e reputação do destino |
Como se manifesta o beaconing num registo de fluxo
Um dispositivo que contacta um domínio com um intervalo constante, com tamanhos de pedido e resposta pequenos e consistentes, em nada se assemelha ao padrão diurno desse mesmo anfitrião. Extraia os intervalos de ligação e o histórico de DNS desse anfitrião antes de bloquear o que quer que seja. Uma Smart TV a verificar atualizações de firmware num horário fixo imitará o mesmo comportamento e fará perder um dia da sua semana.
Grandes carregamentos durante a noite exigem contexto e não alarme. Compare o volume de saída do anfitrião com o seu padrão normal e, em seguida, verifique se a janela de cópia de segurança mudou ou se foi instalado um novo cliente de sincronização na cloud. A pergunta útil é se a transferência é invulgar para esse anfitrião, e não se é grande em termos absolutos.
Consulte a lista de bloqueios e o feed de ameaças antes de culpar a rede. Registe a ocorrência com carimbo de data/hora, anfitrião e destino para que a pessoa seguinte possa verificar em vez de repetir o processo. Essas evidências também permitem demonstrar o que foi bloqueado, em vez de argumentar com base num alerta vago.
Quando o sintoma se revela ser congestão em vez de comprometimento, as abordagens mudam. O bloqueio de anúncios e rastreadores ao nível do DNS pode reduzir o tráfego Web em 20% a 40% e acelerar o carregamento de páginas, sem necessidade de alterações nos dispositivos (Reduzir a utilização de largura de banda). Trata-se de uma primeira verificação prática, uma vez que reduz a procura sem mexer na configuração dos clientes, enquanto a utilização por hora continua a mostrar se a própria linha de base se alterou.
Manter evidências sem recolher dados em excesso
Mais dados de pacotes não significam automaticamente mais segurança. As capturas integrais aumentam os custos de armazenamento, a exposição da privacidade e o volume de trabalho dos analistas, continuando a não permitir a leitura de cargas úteis encriptadas. A questão fundamental a colocar sobre cada registo é mais restrita: isto serve para contenção, proteção, auditoria ou resolução de problemas?
A visibilidade tem o hábito de desaparecer. Quando o DNS não termina em servidores controlados pela empresa, as organizações perdem visibilidade sobre as consultas e ganham pontos cegos para atividades de exfiltração e de negação de serviço (análise da infraestrutura de DNS da EfficientIP). Isto justifica manter as evidências do resolvedor sob o seu próprio controlo, e não capturar tudo.
O conjunto mínimo justificável:
- Carimbo de data/hora e rede ou SSID, para que cada registo esteja associado a um local e a uma política.
- Categoria da política e ação realizada, incluindo bloqueios e a explicação apresentada ao utilizador.
- Domínio consultado, classificação de ameaças e estado do sistema, o que geralmente é suficiente para reconstituir o que aconteceu.
- Não URLs completos, payloads ou históricos de navegação, a menos que exista uma base jurídica clara e um período de retenção definido.
A retenção é uma decisão, não um padrão. Mantenha registos de fluxos e de DNS resumidos durante um período definido, conserve as capturas completas apenas enquanto um incidente estiver ativo e elimine-as quando o caso for concluído.
Antes de iniciar a recolha: quem pode ler os registos, durante quanto tempo são guardados e o que foi comunicado aos utilizadores. Se não conseguir responder a estas três questões, tem um hábito de armazenamento em vez de uma política de governação.
Quando o DNS também efetua a filtragem, a camada de relatórios suporta a maior parte das provas. Vale a pena ler um guia sobre registos e relatórios de filtragem de DNS antes de conceber o formato dos registos, pois adaptar categorias e justificações de políticas a posteriori é um processo moroso e complexo.
Escolha a sua primeira configuração de monitorização
O ponto de partida depende do que se está a proteger, e as redes públicas estão a tornar-se o padrão e não a exceção. A Wireless Broadband Alliance comunicou em 2025 que 46% dos inquiridos planeavam implementar WiFi pública à escala municipal em 2025 ou 2026, enquanto 15% já tinham implementado uma rede desse tipo (relatório do setor da WBA de 2025).
Num pequeno escritório, comece pela exportação de fluxos do router, registos de DNS e uma linha de base de duas semanas; de seguida, crie um painel que mostre a utilização da ligação, os maiores consumidores de tráfego e a percentagem de NXDOMAIN. Essa vista única responde à maioria das reclamações em dias úteis sem que ninguém precise de abrir um ficheiro de captura.
Para um recinto com vários locais ou campus, adicione vistas por SSID e por VLAN, limites de janela temporal e um registo da camada de DNS que guarde cada domínio bloqueado com a respetiva política aplicada. O trabalho adicional reside na normalização e não nas ferramentas.
Para redes públicas ou de WiFi para visitantes, mantenha a mesma política e registo por SSID e informe claramente os utilizadores sobre o que é registado e durante quanto tempo. A transparência não tem custos e resolve a maioria das reclamações antes de chegarem à gestão.
A captura de pacotes mantém-se como uma ferramenta para incidentes ativos, e não como um feed permanente. Avalie a configuração pela rapidez com que responde a uma pergunta: este período de lentidão deve-se a capacidade, a uma falha no dispositivo ou a uma ameaça?
Purple Shield funciona como DNS de proteção em qualquer rede WiFi ou em redes Purple Access, com uma política para cada uma, e uma rede pode ser protegida gratuitamente durante 30 dias.
Escolha uma rede esta semana, capture a respetiva hora de ponta, compare-a com a mesma hora na linha de base e anote a primeira conclusão com o respetivo carimbo de data/hora, anfitrião e destino. Esse único documento vale mais do que outro dashboard.
Purple Shield responde a todas as consultas de DNS nas redes que protege, para que um domínio seja verificado antes de uma ligação ser aberta, e o painel de controlo mostra o que foi bloqueado, que ameaças foram travadas e como a rede foi utilizada entre espaços e SSIDs. Se prefere comprovar o sucedido com base em registos de consultas em vez de executar capturas de pacotes continuamente, comece com a avaliação gratuita para uma rede. Visite Purple Shield para ver como seriam aplicadas as políticas e os relatórios por SSID na sua infraestrutura.