
Was ist Command and Control? C2 erklärt mit DNS-Schutz
Was ist Command and Control? Erfahren Sie, wie C2 funktioniert, wie Angreifer es nutzen und wie Schutzmechanismen auf DNS-Ebene Callbacks blockieren, bevor sie eine Verbindung herstellen.
Published 7. November 2026
Command and Control (C2) ist die Phase eines Cyberangriffs, in der ein Angreifer mit den von ihm kompromittierten Systemen kommuniziert und diese steuert.
Sie betreiben Gäste-WiFi in einem Hotel, auf einem Campus oder in einem Krankenhaus. Ein Besucher verbindet ein Laptop, akzeptiert die Nutzungsbedingungen und beginnt zu surfen. Was Sie nicht sehen können, ist, ob dieses Laptop bereits infiziert angetroffen ist oder ob im Hintergrund laufende Software versucht, Kontakt zu einem Angreifer aufzunehmen.
Das Gerät gehört Ihnen nicht, und Sie können nicht davon ausgehen, dass ein Sicherheits-Agent installiert ist. Aber Sie steuern, wie es Ihr Netzwerk nutzt. Bei Callbacks, die von einem Domänennamen abhängen, bietet die DNS-Abfrage eine frühe Gelegenheit, das Ziel zu überprüfen, bevor eine Verbindung zugelassen wird.
Inhaltsverzeichnis
- Was Command and Control in einfachen Worten bedeutet
- Wie ein C2-Kanal von der Infektion bis zum Befehl funktioniert
- Gängige C2-Kanäle und wie sie sich jeweils tarnen
- Warum Angreifer auf DNS und rotierende Domains setzen
- DNS-Signale, die auf einen Rückruf hinweisen
- Wie Schutzmaßnahmen auf DNS-Ebene einen Rückruf stoppen
- Überprüfen Sie Ihre Rückrufsperre vor einem Vorfall
Was Command and Control einfach erklärt bedeutet
Stellen Sie sich einen infizierten Laptop wie ein gestohlenes Auto vor, das in einer Garage versteckt ist. Der ursprüngliche Diebstahl hat bereits stattgefunden. C2 ist die Fernbedienung, die der Dieb behält und mit der er den Motor starten, die Route ändern und Anweisungen von woanders senden kann.
Die Unterscheidung ist wichtig, da das Eindringen in ein Gerät und dessen anschließende Steuerung zwei verschiedene Aktivitäten sind.
Command and Control (C2) ist die Phase eines Cyberangriffs, in der ein Angreifer mit den von ihm kompromittierten Systemen kommuniziert und diese steuert.
Phishing, ein ausgenutzter Dienst oder gestohlene Anmeldedaten können den Einstiegspunkt bilden. C2 stellt den dauerhaften Kommunikationspfad bereit. MITRE ATT&CK behandelt dies als eigenständige Taktik von Angreifern und dokumentiert 18 Enterprise C2-Techniken, welche die Kommunikation mit Systemen unter der Kontrolle eines Angreifers innerhalb des Netzwerks eines Opfers abdecken.
Diese Kommunikation muss keinen offensichtlichen Malware-Server einbeziehen. Angreifer können Anweisungen als gewöhnlichen Datenverkehr tarnen, Nachrichten codieren oder alternative Routen einrichten.
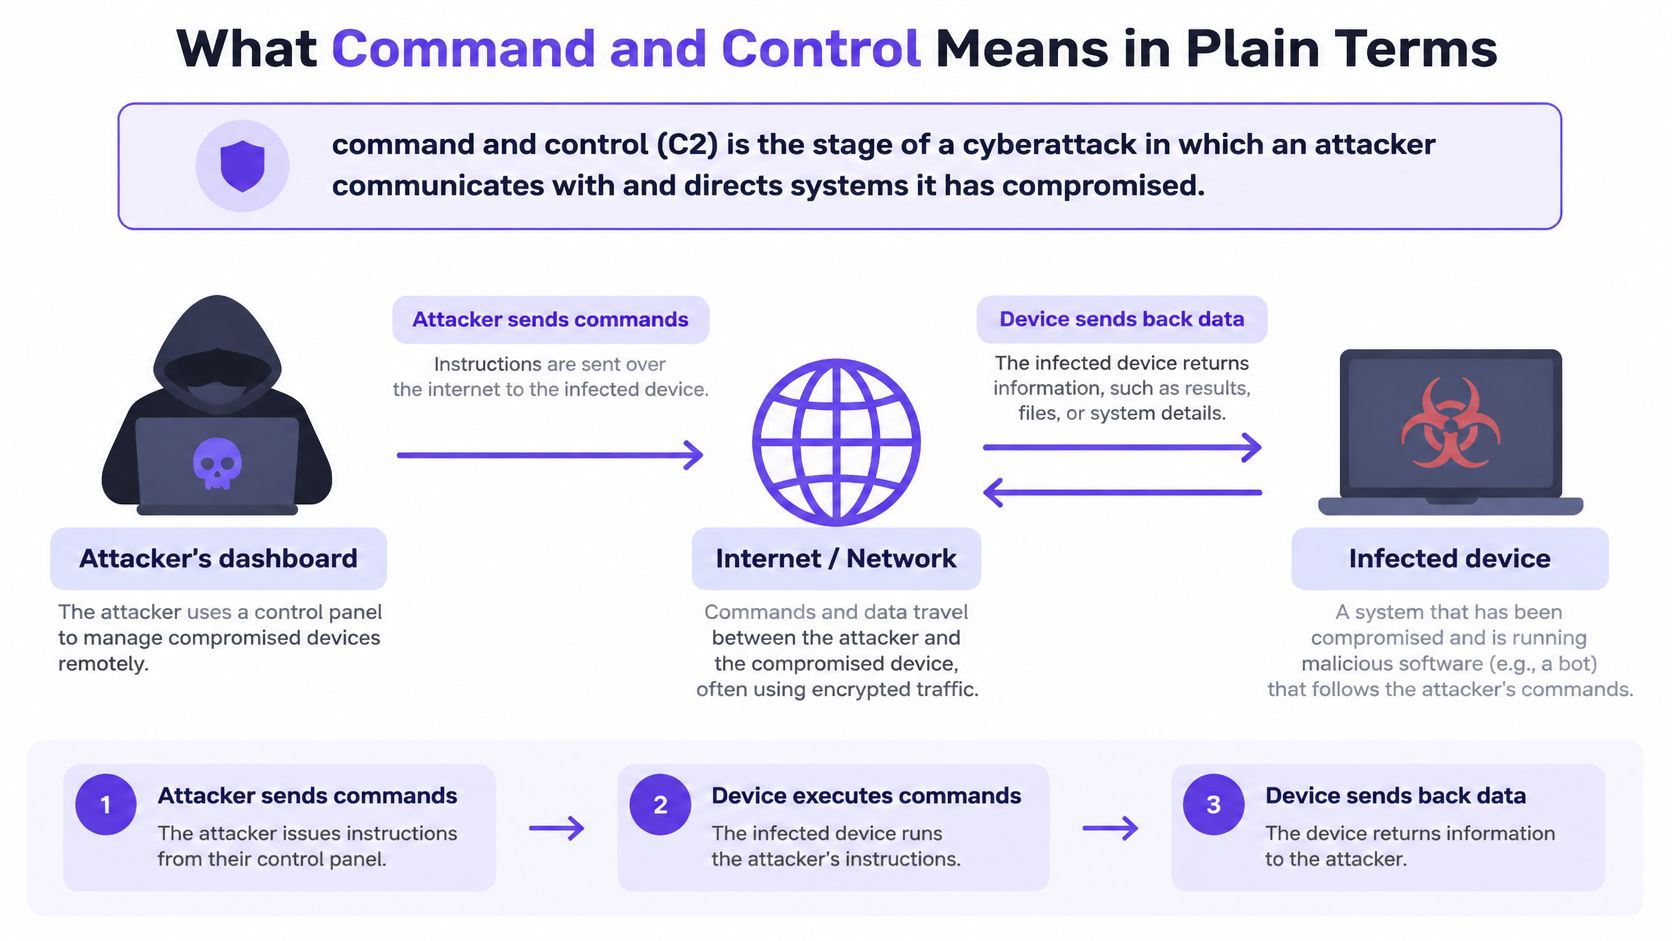
Was eine dauerhafte Kontrolle einem Angreifer ermöglicht
Sobald ein funktionierender Kanal besteht, kann der Angreifer das kompromittierte System anweisen:
- Befehle ausführen: Aufgaben unter Nutzung der Zugriffsrechte ausführen, die der infizierten Software zur Verfügung stehen.
- Tools herunterladen: Funktionen hinzufügen, die über die ursprüngliche Infektion hinausgehen.
- Laterale Ausbreitung: Versuchen, andere Systeme im Netzwerk zu erreichen.
- Informationen entwenden: Zugängliche Dateien oder gesammelte Ergebnisse nach außen senden.
- Dauerhaften Zugriff aufrechterhalten: Zugriffsrechte bewahren, damit die Aktivitäten später fortgesetzt werden können.
Dies sind mögliche Aktionen, kein automatisches Ergebnis jeder Infektion. Berechtigungen, Segmentierung und andere Sicherheitskontrollen schränken weiterhin ein, was der Angreifer erreichen kann.
Ebenso ist das Löschen des ursprünglichen schädlichen Downloads kein Beweis dafür, dass die Kontrolle beendet ist. Eine andere Komponente oder ein anderer Kommunikationsweg kann bestehen bleiben. Sicherheitsteams müssen sowohl feststellen, was ausgeführt wird, als auch, ob unautorisierte Kommunikationen weiterhin funktionieren.
Für einen Betreiber, der sich fragt, was Command-and-Control in der Praxis bedeutet, lautet die Antwort: Fernsteuerung nach einer Kompromittierung. Bei geteiltem WiFi ändert das die Abwehrfrage: Es geht nicht nur darum, ob ein Gerät infiziert ist, sondern ob Ihr Netzwerk ihm erlaubt, seinen Controller zu erreichen.
Wie ein C2-Kanal funktioniert: Von der Infektion bis zum Befehl
Stellen Sie sich den Laptop eines Besuchers vor, der bereits vor der Ankunft an Ihrem Standort infiziert war. Das Verbinden mit Ihrem WiFi verursacht nicht die Infektion, kann der Schadsoftware jedoch einen neuen Weg ins Internet eröffnen.
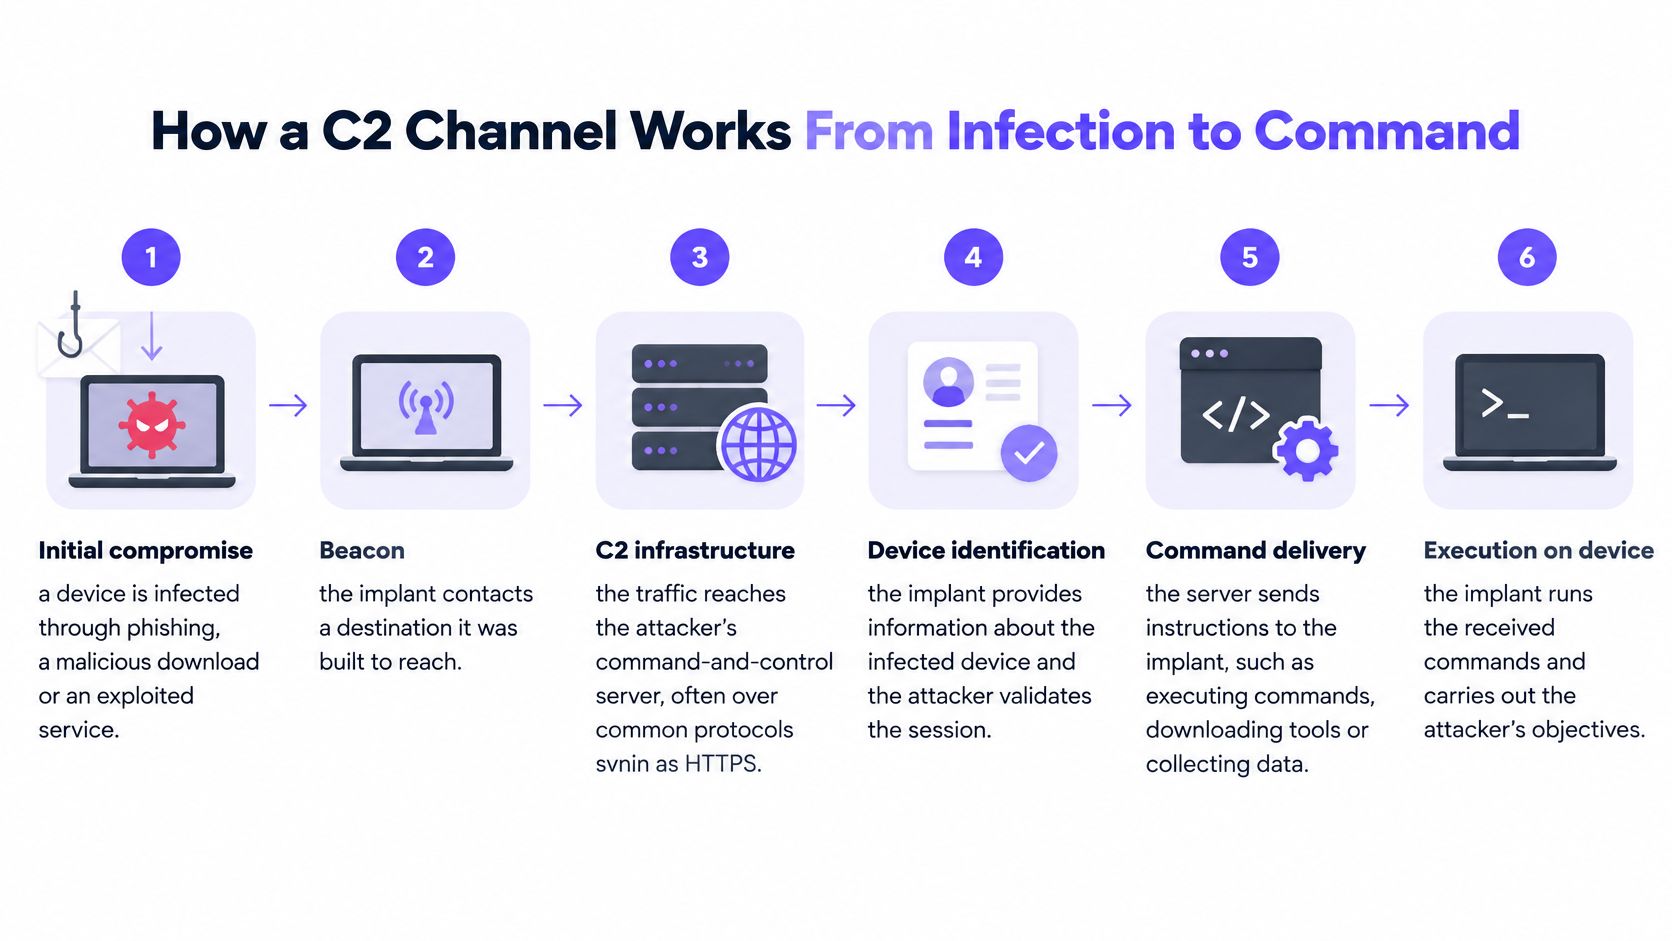
Die folgende Sequenz trennt die Absicht der Software zum Check-in von der Netzwerkaktivität, die zum Abschließen dieses Check-ins erforderlich ist.
Erstkompromittierung. Ein Phishing-Anhang, ein bösartiger Download oder ein ausgenutzter Dienst führt ein Implantat ein, also die Software, die auf dem kompromittierten Gerät ausgeführt wird. Sicherheitsteams sollten den ursprünglichen Zugangspunkt von nachfolgenden Netzwerkaktivitäten unterscheiden, da das Blockieren des einen nicht zwangsläufig das andere behebt.
Beacon-Vorbereitung. Das Implantat bereitet eine Kontaktaufnahme vor (oft als Beacon bezeichnet), um seine Verfügbarkeit zu signalisieren und Anweisungen anzufordern. Ein Timer kann diese Aktivität auslösen, ohne dass der Benutzer etwas öffnet. Browseraktivitäten allein erklären daher nicht jede Verbindung.
Namensauflösung. Wenn das Ziel eine Domain verwendet und noch keine nutzbare Adresse vorhanden ist, fordert das Gerät das DNS auf, diesen Namen in eine Adresse zu übersetzen. Dies ist ein frühzeitiger, leichtgewichtiger Entscheidungspunkt, an dem Sicherheitsteams das Ziel bewerten können, bevor die entsprechende Serververbindung startet.
Befehlsübermittlung. Bei erfolgreicher Kommunikation kann der Controller Anweisungen zurückgeben, wie z. B. das Herunterladen eines weiteren Tools oder das Sammeln von Dateien. Sicherheitsteams müssen nun den Inhalt und die Folgen des Austauschs berücksichtigen, nicht nur dessen Ziel.
Ausführung und dauerhafter Zugriff. Das Implantat führt die Aufgabe aus und gibt möglicherweise Ergebnisse zurück oder versucht bei fehlschlagender Kommunikation einen alternativen Weg. Eine Untersuchung muss daher nach Folgeaktivitäten suchen, anstatt einen einzelnen blockierten Versuch als Ende des Vorfalls zu betrachten.
Analysieren Sie das Muster, nicht nur die Anfrage
Eine kleine Abfrage, die in regelmäßigen Abständen an eine unbekannte Domäne wiederholt wird, verdient eine Untersuchung. Eine gelegentliche Anfrage an einen bekannten Dienst kann Routine sein, aber weder Zeitpunkt noch Vertrautheit entscheiden die Frage allein. Auch legitime Update-Software meldet sich automatisch.
Für weiterführende Hintergrundinformationen bietet Statlyst mit Malware-Trends in Zahlen Kontext zu Malware-Aktivitäten. Operativ sollte Ihre Entscheidung jedoch auf dem Ziel, dem Netzwerkkontext des anfordernden Geräts und den begleitenden Ereignissen basieren.
Sie müssen die bösartige Datei nicht finden, bevor Sie deren nächsten domänenabhängigen Check-in unterbrechen. Das ist eine nützliche Eindämmung, selbst während jemand anderes die Sanierung des Geräts übernimmt.
Gängige C2-Kanäle und wie sie sich unauffällig einfügen
Verschiedene C2-Kanäle ähneln unterschiedlichen Arten legitimer Aktivität. Sicherheitsteams benötigen daher auf jeden Kanal abgestimmte Kontrollen.
C2-Kanäle, wie sie sich einfügen und wo man sie abfängt
| Kanal | Warum er unauffällig bleibt | Wo Angriffe abgefangen werden |
|---|---|---|
| HTTP und HTTPS | Datenverkehr ähnelt regulärem Web-Browsing | TLS-fähige Filterung und Reputationsprüfungen für Zieladressen |
| DNS | Namensauflösungen, die nahezu jedes Netzwerk zulassen muss | Resolver mit Bedrohungskategorien und Abfrage-Protokollierung |
| Nachrichten von und zu Mailservern, die von Benutzern erwartet werden | Mail-Gateway-Überprüfung auf Links und Anhänge | |
| Fernzugriff (RDP, Telnet) | Sieht aus wie Administrator-Sitzungen | Gästenetzwerke segmentieren und ausgehende Admin-Ports blockieren |
| Industrielle Protokolle (DNP3, Modbus) | Erwarteter Datenverkehr innerhalb operativer Netzwerke | Protokollkonformes Monitoring und OT-Segmentierung |
HTTP und HTTPS bieten eine nützliche Tarnung, da Anwendungen kontinuierlich Webanfragen senden. Ein kleiner verschlüsselter Rückruf kann wie ein gewöhnlicher Anwendungsaufruf aussehen. Die Reputationsprüfung des Ziels hilft hierbei, während TLS-fähige Kontrollen eine sorgfältige Bereitstellung erfordern - insbesondere dort, wo die Überprüfung des verschlüsselten Datenverkehrs von Gästen Datenschutz- und Betriebsprobleme verursachen würde.
DNS bietet einen weiteren Vorteil: Geräte benötigen Namensauflösung für gewöhnliche Dienste. Das Industrial Control Systems ATT&CK-Framework von MITRE führt DNS als Standard-C2-Mechanismus auf Anwendungsebene auf, einschließlich des Versteckens von Daten in DNS-Feldern und der Nutzung von DNS-Tunneling. Hier dient DNS nicht nur der Lokalisierung eines Controllers; die Abfragen und Antworten selbst können Nachrichten übertragen.
Passen Sie die Steuerung an den jeweiligen Kanal an
E-Mail kann Anweisungen über die gewohnte Mail-Infrastruktur übertragen. Gateway-Prüfungen von Links und Anhängen sind nützlich, aber kein Ersatz für die Überwachung des gesamten Kommunikationswegs.
Hinterfragen Sie bei Fernzugriffsprotokollen, warum ein Gastgerät überhaupt einen ausgehenden administrativen Zugriff benötigt. Beschränken Sie unnötige Dienste und trennen Sie Gästenetzwerke von Verwaltungssystemen. Eine autorisierte Fernverwaltung sollte über eine definierte Route verfügen anstatt über eine pauschale Ausnahme.
Industrielle Protokolle gehören in einen anderen Kontext. Ein Krankenhaus oder ein Campus mit operationalen Geräten sollte diese Umgebung vom Besucherzugang getrennt halten und eine Überwachung einsetzen, die das erwartete Protokollverhalten versteht.
Verschlüsselung verändert auch, was Beobachter sehen können. Bei DNS über HTTPS übertragen sich Namensauflösungsanfragen innerhalb von HTTPS, sodass die Resolver-Durchsetzung verschlüsselte Alternativen berücksichtigen muss, anstatt nur den herkömmlichen DNS-Datenverkehr abzudecken.
Der häufige Fehler besteht darin, ein zugelassenes Protokoll als vertrauenswürdigen Zweck zu behandeln. Ein bekannter Port oder eine verschlüsselte Verbindung ist kein Beleg dafür, dass das Ziel sicher ist.
Warum Angreifer auf DNS und rotierende Domains setzen
Ein statisches Ziel gibt Verteidiger etwas Stabiles zum Blockieren. Angreifer können die Unterbrechung erschweren, indem sie die Namen ändern, die die Malware zu erreichen versucht.
Ein Domain-Generierungs-Algorithmus (DGA) berechnet potenzielle Namen aus einem Startwert, der vom Datum abhängen kann. In einem hypothetischen Beispiel mit täglichem Startwert generiert die Malware jeden Tag einen neuen Satz von Namen, während der Angreifer einen passenden Namen registriert. Die Blockliste von gestern enthält möglicherweise nicht das Ziel von heute.
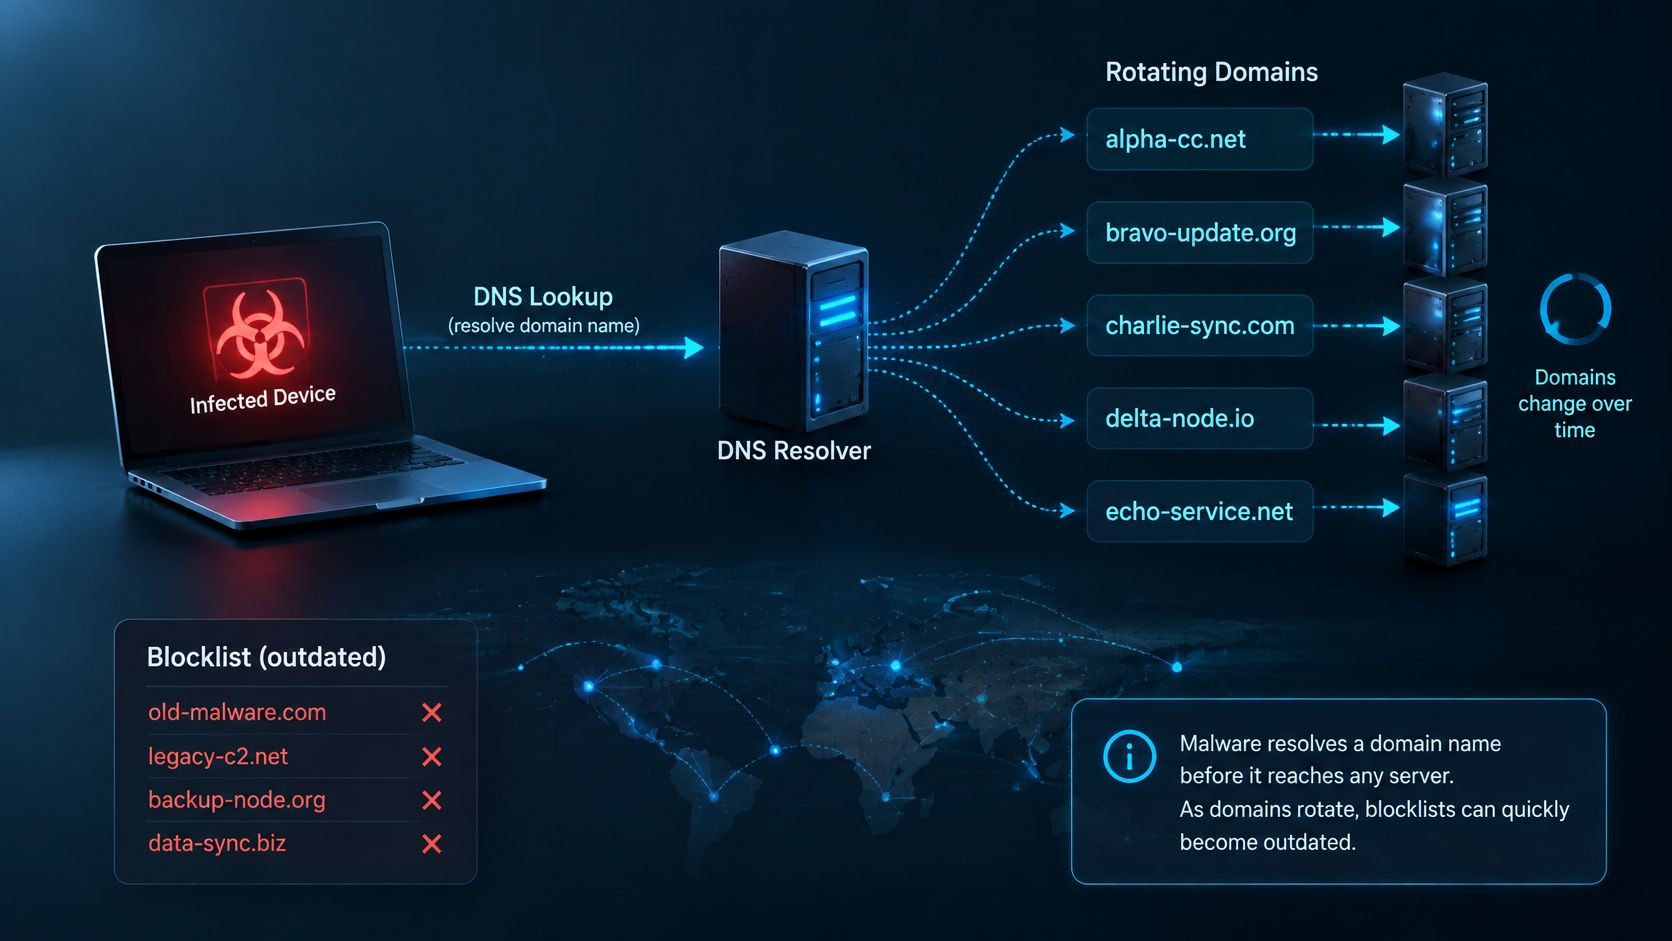
Angreifer können Zieladressen oder -ports auch aus DNS-Antworten ableiten oder Einträge über kompromittierte DNS-Infrastrukturen Dritter ändern. Die DNS-Sicherheitsrichtlinie der CISA beschreibt DNS-Sicherheitsdienste als Analyse von Abfragen und Ergreifung von Schutzmaßnahmen gegen Malware, Ransomware, Phishing, Viren, bösartige Websites und Spyware.
Eingreifen, bevor das Ziel akzeptiert wird
Wenn ein schützender Resolver einen schädlichen Namen erkennt, kann er die verwendbare Antwort zurückhalten. Für eine Verbindung, die von dieser Antwort abhängt, wird das wechselnde Backend des Angreifers nie zum nächsten Ziel des Geräts.
Das deckt nicht jeden möglichen Callback-Pfad über DNS ab. Zwischengespeicherte Antworten, fest codierte Adressen und alternative Auflösungswege erfordern weitere Kontrollen. Wo jedoch eine neue Auflösung erforderlich ist, ist die Überprüfung des Namens praktischer, als jeder sich ändernden Serveradresse einzeln nachzujagen.
DNS-Signale, die auf einen Callback hinweisen
Diese DNS-Muster helfen bei der Priorisierung von Untersuchungen, aber jedes ist ein Hinweis, kein Beweis für eine Infektion.
DNS-Signale, was sie nahelegen und wie man reagiert
| Signal | Mögliche Bedeutung | Reaktion |
|---|---|---|
| Zufällig wirkende Domainnamen mit hoher Entropie | Möglicherweise algorithmisch generierte C2-Domain | Als bösartig eingestufte Domain blockieren und Quellgerät überprüfen |
| Wiederholte Abfragen desselben Namens in regelmäßigen Abständen | Mögliche Beaconing-Kontaktaufnahmen mit einem Controller | Warnung auslösen und Netzwerksegment identifizieren |
| Sehr kurze TTL bei Antworten | Mögliche Infrastruktur-Rotation zur Umgehung von Sperrlisten | Vor dem Handeln mit anderen Signalen korrelieren |
| TXT-lastiger Abfrage- oder Antwort-Datenverkehr | Möglicherweise im DNS kodierte Befehle oder Daten | Auf Tunneling untersuchen und bösartiges Ziel blockieren |
| Wiederholt fehlgeschlagene Abfragen desselben Namens | Mögliche erneute Versuche bei einer inaktiven oder per Sinkhole umgeleiteten Domain | Gerät prüfen und nach Ausweich-Domains suchen |
Hohe Entropie bedeutet, dass ein Name ungewöhnlich unvorhersehbar aussieht. Legitime Dienste nutzen ebenfalls maschinell generierte Namen, weshalb das Aussehen allein keine fundierte Blockierungsregel darstellt.
Eine kurze Time to Live (TTL) weist einen Resolver an, eine Antwort nicht lange zu speichern. Dies kann schnelle Infrastrukturänderungen unterstützen, aber auch legitime Dienste nutzen kurzlebige Antworten. Ebenso haben TXT-Einträge legitime Zwecke, obwohl Angreifer sie missbrauchen können, um codierte Inhalte zu übertragen.
Erkenntnisse kombinieren, bevor eskaliert wird
Eine zufällig wirkende Domäne wird bedenklicher, wenn dieselbe Quelle sie in regelmäßigen Abständen anfordert, kurzlebige Antworten erhält und nach Fehlschlägen verwandte Namen versucht. Diese Kombination ist nützlicher, als jede ungewöhnliche Abfrage als separaten Notfall zu behandeln.
Threat Intelligence Feeds können Zielkontext hinzufügen. Nutzen Sie diesen Kontext zusammen mit dem Abfrageverlauf, Richtlinienentscheidungen und der Netzwerkzuordnung, nicht als Ersatz dafür.
Praktische Regel: Zeichnen Sie das, was das Netzwerk beobachtet hat, getrennt von dem auf, was der Analyst vermutet.
Beispielsweise kann ein Protokoll belegen, dass eine Quelle eine blockierte Domäne angefordert hat. Es belegt jedoch nicht, dass das Gerät den Befehl eines Angreifers ausgeführt hat oder dass Daten das Netzwerk verlassen haben.
Gäste-WiFi macht die Zuordnung besonders wichtig. Die CISA-Leitlinien zur Implementierung von Gästenetzwerken fordern, dass DNS-Anfragen von Gästen über Protective DNS geleitet werden und der Gäste-Datenverkehr segmentiert und gekennzeichnet wird, damit ungewöhnliche Ereignisse nach Quellgruppen priorisiert werden können.
Bewahren Sie den Zeitstempel, Informationen zur anfordernden Quelle, SSID oder VLAN, den abgefragten Namen und das Richtlinienergebnis auf. Beschränken Sie den Zugriff und die Aufbewahrung gemäß den Datenschutzanforderungen Ihrer Organisation. Sie können eine Reaktion koordinieren, ohne die persönlichen Dateien eines Besuchers zu überprüfen oder unnötige Identitätsdaten zu erfassen.
Wie Schutzmechanismen auf DNS-Ebene einen Callback stoppen
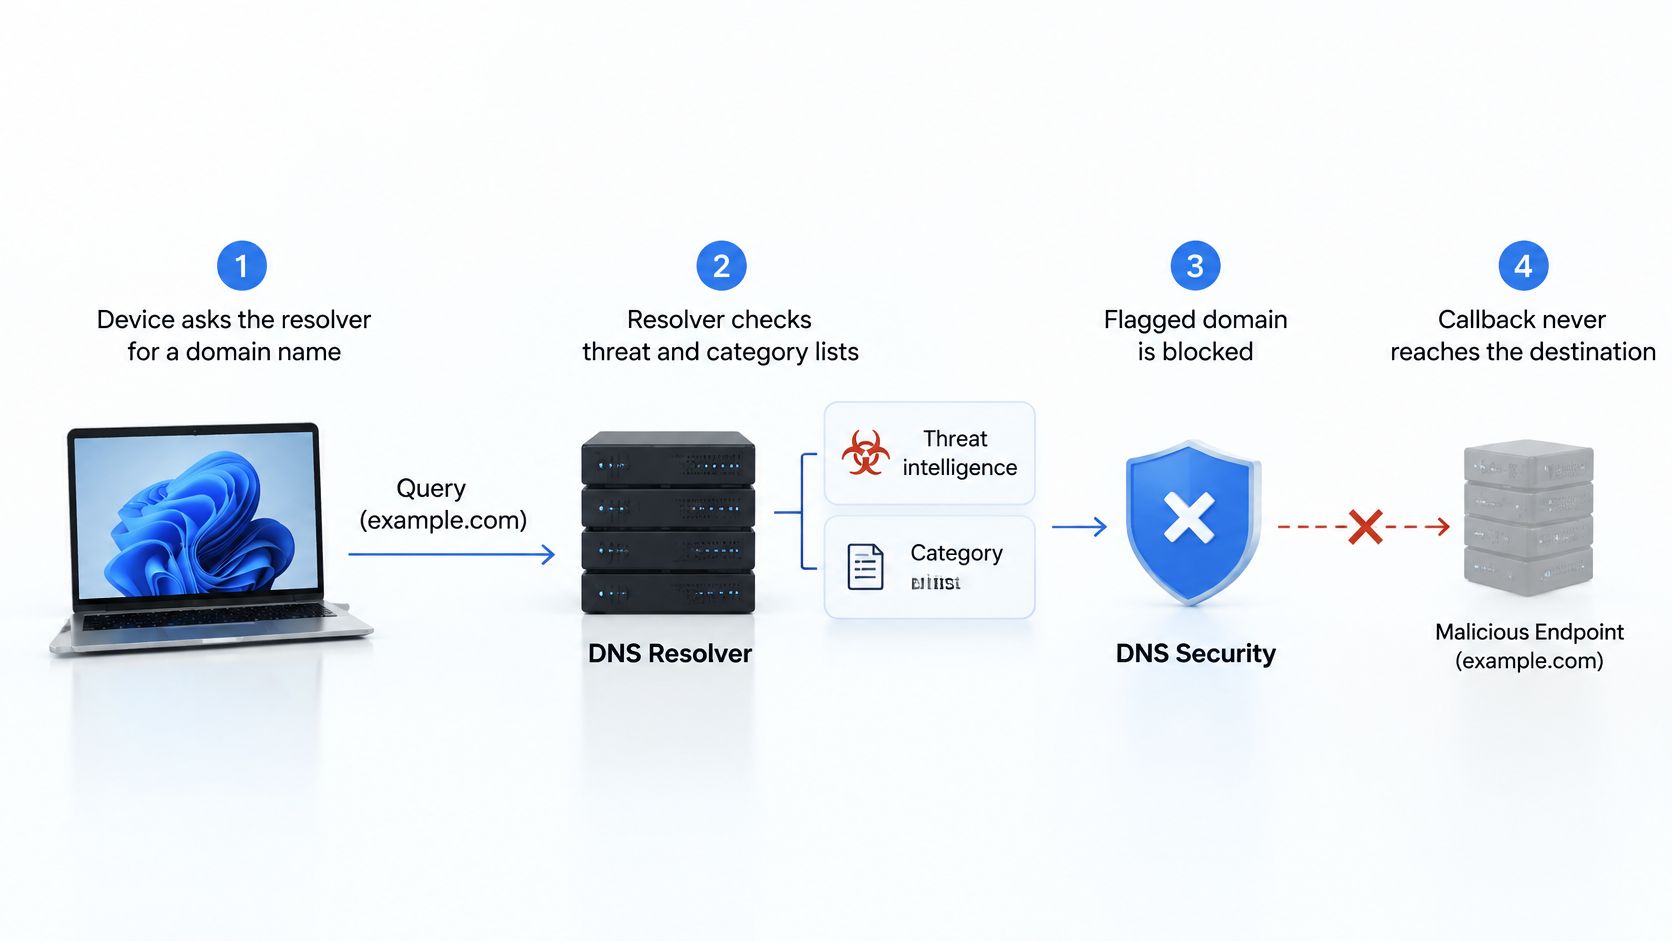
- Das Gerät fordert einen Namen an. Seine Abfrage erreicht den genehmigten Resolver.
- Der Resolver prüft die Richtlinien. Bedrohungsinformationen und Kategorie-Regeln bestimmen, ob das Ziel zulässig ist.
- Ein bösartiges Ziel wird blockiert. Der Resolver gibt eine Blockierungsantwort anstelle der verwendbaren Zieladresse zurück.
- Die Entscheidung wird aufgezeichnet. In den Protokollen werden Zeit und Quellkontext gespeichert, wobei die Zuordnung zu SSID oder VLAN durch die Netzwerkintegration bereitgestellt wird.
Das Diagramm zeigt diese Entscheidung vor der Zielverbindung.
Richten Sie die Richtlinie für Gäste-WiFi-WiFi ein
Konfigurieren Sie Gäste-Netzwerke so, dass sie den zugelassenen Resolver verwenden, und beschränken Sie unautorisierte Auflösungswege. Planen Sie ein Fail-Closed-Verhalten ein, damit ein Ausfall des Richtliniendienstes keine ungeprüften Anfragen unbemerkt zulässt, und testen Sie die Auswirkungen auf die Verfügbarkeit vor der Bereitstellung.
Ein DNS-Sinkhole ist ein weiterer Reaktionsansatz, der eine schädliche Abfrage auf ein kontrolliertes Ziel umleitet. Ihre Protokolle sollten zwischen Umleitung, Verweigerung oder einer anderen Blockierungsreaktion unterscheiden.
Das Video bietet eine zusätzliche Erklärung des DNS-Schutzansatzes.
DNS-Filterung bereinigt das Gerät nicht. Fest codierte Adressen umgehen die Namensauflösung und bereits aufgebaute Sitzungen können fortbestehen. Kombinieren Sie den DNS-Schutz daher mit Segmentierung und Regeln für ausgehende Verbindungen.
Das Stoppen einer erforderlichen Abfrage stoppt die Anweisungen über diese Route, entfernt jedoch nicht die Infektion.
Prüfen Sie Ihre Callback-Blockierung vor einem Vorfall
Nutzen Sie diese Checkliste diese Woche gemeinsam mit Ihrem Netzwerk- oder IKT-Team:
- Durchsetzung am Resolver bestätigen. Überprüfen Sie SSIDs für Gäste, Mitarbeiter und Studenten separat. Verifizieren Sie, wohin deren Anfragen geleitet werden, anstatt sich nur auf die vorgesehene Konfiguration zu verlassen.
- Zulässige und blockierte Ergebnisse testen. Versuchen Sie von jedem SSID aus ein als sicher bekanntes Ziel sowie die dafür vorgesehene, harmlose Test-Domain des Filterdienstes aufzurufen. Verwenden Sie keine aktive Malware-Infrastruktur.
- Ausfallverhalten testen. Testen Sie in einem genehmigten Wartungsfenster, was passiert, wenn der Richtliniendienst nicht verfügbar ist. Bestätigen Sie, dass das Netzwerk der vorgesehenen Fail-Closed-Richtlinie folgt und das Team eine handlungsrelevante Warnmeldung erhält.
- Zuordnung prüfen. Stellen Sie sicher, dass die Datensätze blockierter Ereignisse die SSID, die VLAN und die Uhrzeit enthalten - entweder direkt oder durch zuverlässige Korrelation. Überprüfen Sie, ob ein Analyst die relevanten Nachweise abrufen kann.
- Zuständigkeiten für Eskalationen zuweisen. Vereinbaren Sie, wer eine Warnmeldung prüft, wer ein Quellgerät einschränken kann und wer mit dem Standort, dem Gast oder dem Gerätebesitzer kommuniziert.
Änderungen testen, ohne die Gesamtumgebung zu stören
Ein erfolgreicher Test erfordert mehr als eine sichtbare Sperrseite. Bewahren Sie das erwartete Ergebnis, das beobachtete Ergebnis und den relevanten Protokolleintrag auf, damit eine andere Person nachvollziehen kann, was passiert ist.
Beziehen Sie gewöhnliche Gästeaktivitäten in das Pilotprojekt ein. Überprüfen Sie, ob legitimes Surfen und essenzielle Standort-Dienste nutzbar bleiben, und dokumentieren Sie, wie Mitarbeiter mit einer irrtümlichen Blockierung umgehen sollten. Eine präzise definierte Richtlinie ist einfacher zu unterstützen als eine unerkärte Unterbrechung.
Für Kunden, die ein Change-Management betreiben, planen wir ein Pilotprojekt an einem SSID mit Ihrem Team oder IKT-Anbieter, bevor umfassendere Änderungen vorgenommen werden. Das gibt den Verantwortlichen für die Freigabe einen definierten Rahmen und Prüfungsnachweise.
Die Entscheidung ist einfach: Kann Ihr aktuelles Netzwerk nachweisen, was blockiert wurde, wo es passiert ist und wer reagieren sollte? Wenn dies nicht der Fall ist, beginnen Sie mit der Resolver-Durchsetzung und Quellenzuordnung in einem Pilot-Gäste-WiFi SSID und erweitern Sie diese erst, wenn die Tests verlässliche Ergebnisse liefern.
Purple Shield blockiert Command-and-Control-Rückrufe sowie bekannte Phishing- und Malware-Domains bereits bei der DNS-Abfrage, sodass die entsprechende Verbindung gar nicht erst aufgebaut wird. Besuchen Sie Purple Shield, um den Schutz Ihres Gäste-WiFi WiFi zu besprechen und ein Pilotprojekt mit Ihrem Team oder ITK-Anbieter zu planen.