
¿Qué es el comando y control? C2 explicado con defensa de DNS
¿Qué es el comando y control? Conozca cómo funciona C2, cómo lo utilizan los atacantes y cómo las defensas a nivel de DNS bloquean las devoluciones de llamada antes de que se conecten.
Published 7 de noviembre de 2026
El comando y control (C2) es la etapa de un ciberataque en la que un atacante se comunica con los sistemas que ha comprometido y los dirige.
Usted opera WiFi para invitadosWiFi en un hotel, campus u hospital. Un visitante conecta una computadora portátil, acepta los términos de acceso y comienza a navegar. Lo que usted no puede ver es si esa computadora portátil ya llegó infectada o si el software que se ejecuta en segundo plano está intentando contactar a un atacante.
Usted no es dueño del dispositivo y no puede asumir que hay un agente de seguridad instalado. Sin embargo, sí controla cómo utiliza su red. Para las devoluciones de llamada (callbacks) que dependen de un nombre de dominio, la búsqueda DNS le brinda una oportunidad temprana de verificar el destino antes de permitir una conexión.
Tabla de contenido
- Qué significa Comando y Control en términos sencillos
- Cómo funciona un canal de C2 desde la infección hasta el comando
- Canales comunes de C2 y cómo se mimetiza cada uno
- Por qué los atacantes recurren al DNS y a dominios rotativos
- Señales de DNS que apuntan a una devolución de llamada
- Cómo las defensas a nivel de DNS detienen una devolución de llamada
- Compruebe el bloqueo de devoluciones de llamada antes de que ocurra un incidente
Qué significa comando y control en términos sencillos
Imagine una computadora portátil infectada como un automóvil robado oculto en un estacionamiento. El robo inicial ya ocurrió. El C2 es el control remoto que conserva el ladrón, lo que le permite encender el motor, cambiar la ruta y enviar instrucciones desde cualquier otro lugar.
La distinción es importante porque ingresar a un dispositivo y controlarlo después son actividades diferentes.
El comando y control (C2) es la etapa de un ciberataque en la que un atacante se comunica con los sistemas que ha comprometido y los dirige.
El phishing, un servicio explotado o las credenciales robadas pueden proporcionar el punto de entrada. El C2 suministra la ruta de comunicación continua. MITRE ATT&CK considera esto como una táctica de adversario diferenciada y documenta 18 técnicas C2 de Enterprise, que cubren la comunicación con sistemas bajo el control de un atacante dentro de la red de la víctima.
Esa comunicación no tiene por qué involucrar a un servidor de malware evidente. Los atacantes pueden disfrazar las instrucciones como tráfico ordinario, codificar mensajes o establecer rutas alternativas.
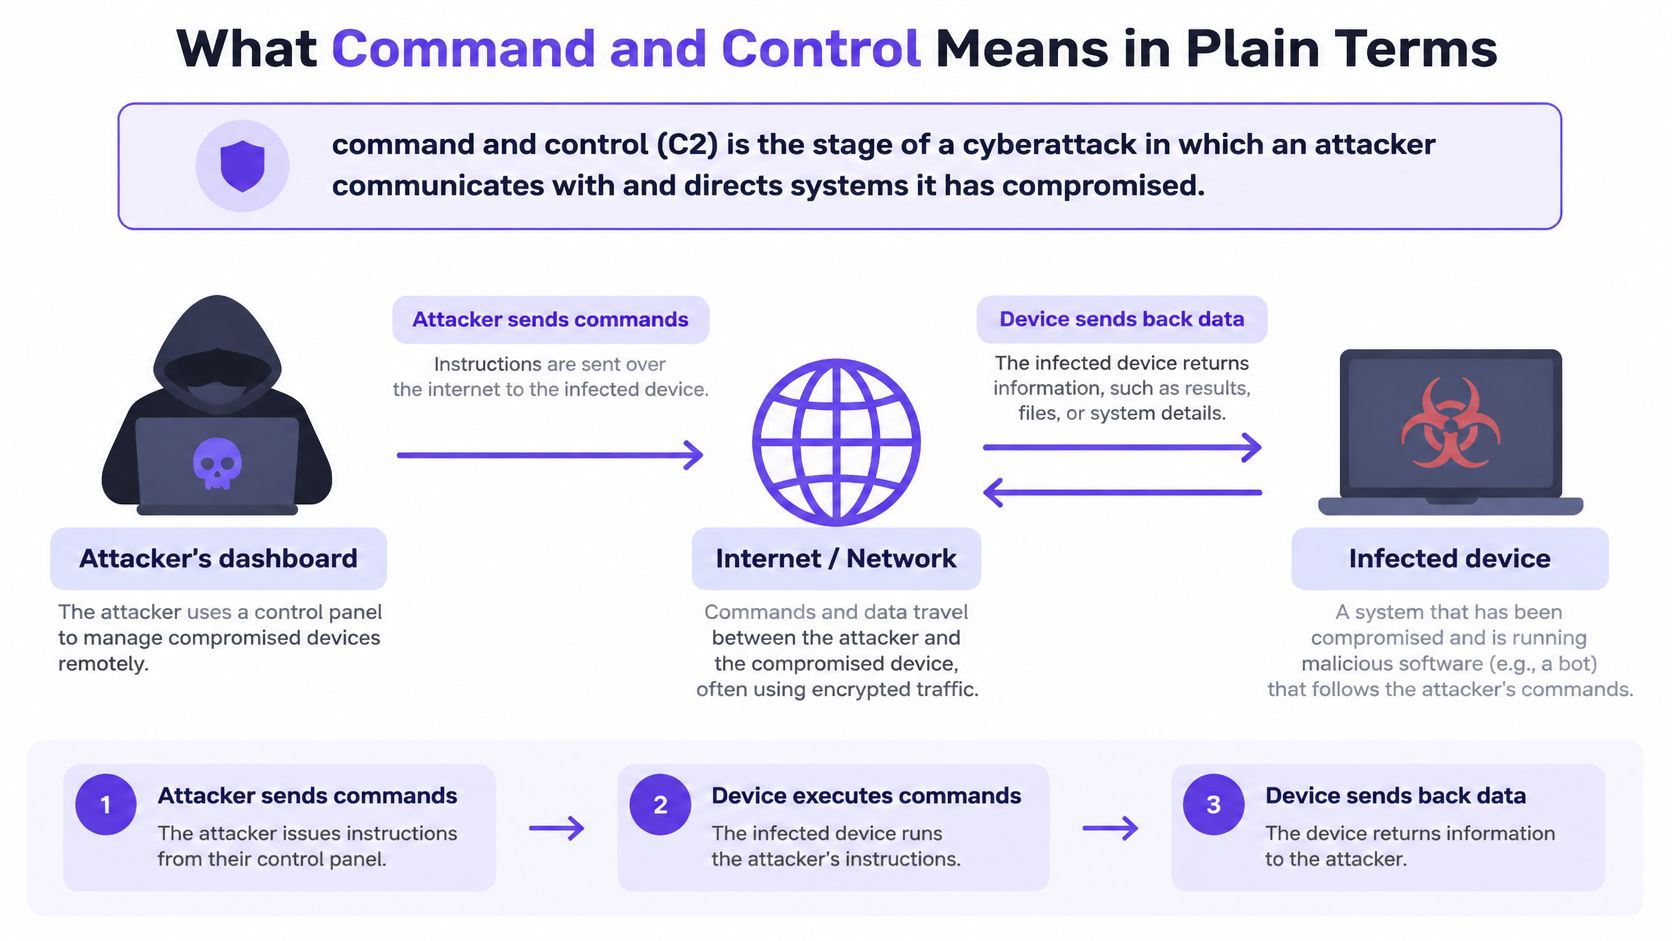
Lo que el control continuo le permite hacer a un atacante
Una vez que existe un canal operativo, el atacante puede dirigir el sistema comprometido para:
- Ejecutar comandos: Ejecute tareas utilizando el acceso disponible para el software infectado.
- Descargar herramientas: Añada capacidades más allá de las incluidas en la infección original.
- Moverse lateralmente: Intente alcanzar otros sistemas en la red.
- Robar información: Envíe al exterior archivos accesibles o resultados recopilados.
- Mantener la persistencia: Conserve el acceso para que la actividad pueda continuar más adelante.
Estas son acciones posibles, no el resultado automático de cada infección. Los permisos, la segmentación y otros controles de seguridad siguen limitando lo que el atacante puede lograr.
Del mismo modo, eliminar la descarga maliciosa original no es prueba de que el control haya terminado. Es posible que permanezca otro componente o ruta de comunicación. Los encargados de la defensa deben determinar tanto lo que se está ejecutando como si las comunicaciones no autorizadas siguen funcionando.
Para un operador que se pregunta qué es comando y control en términos prácticos, la respuesta es la dirección remota después de una vulneración. En redes WiFi compartidas, esto cambia la cuestión defensiva: no se trata solo de si un dispositivo está infectado, sino de si su red le permitirá comunicarse con su controlador.
Cómo funciona un canal C2 desde la infección hasta el comando
Considere la computadora portátil de un visitante que se infectó antes de llegar a su establecimiento. Conectarse a su WiFi WiFi no causa la infección, pero puede ofrecerle al software malicioso una nueva ruta de acceso a Internet.
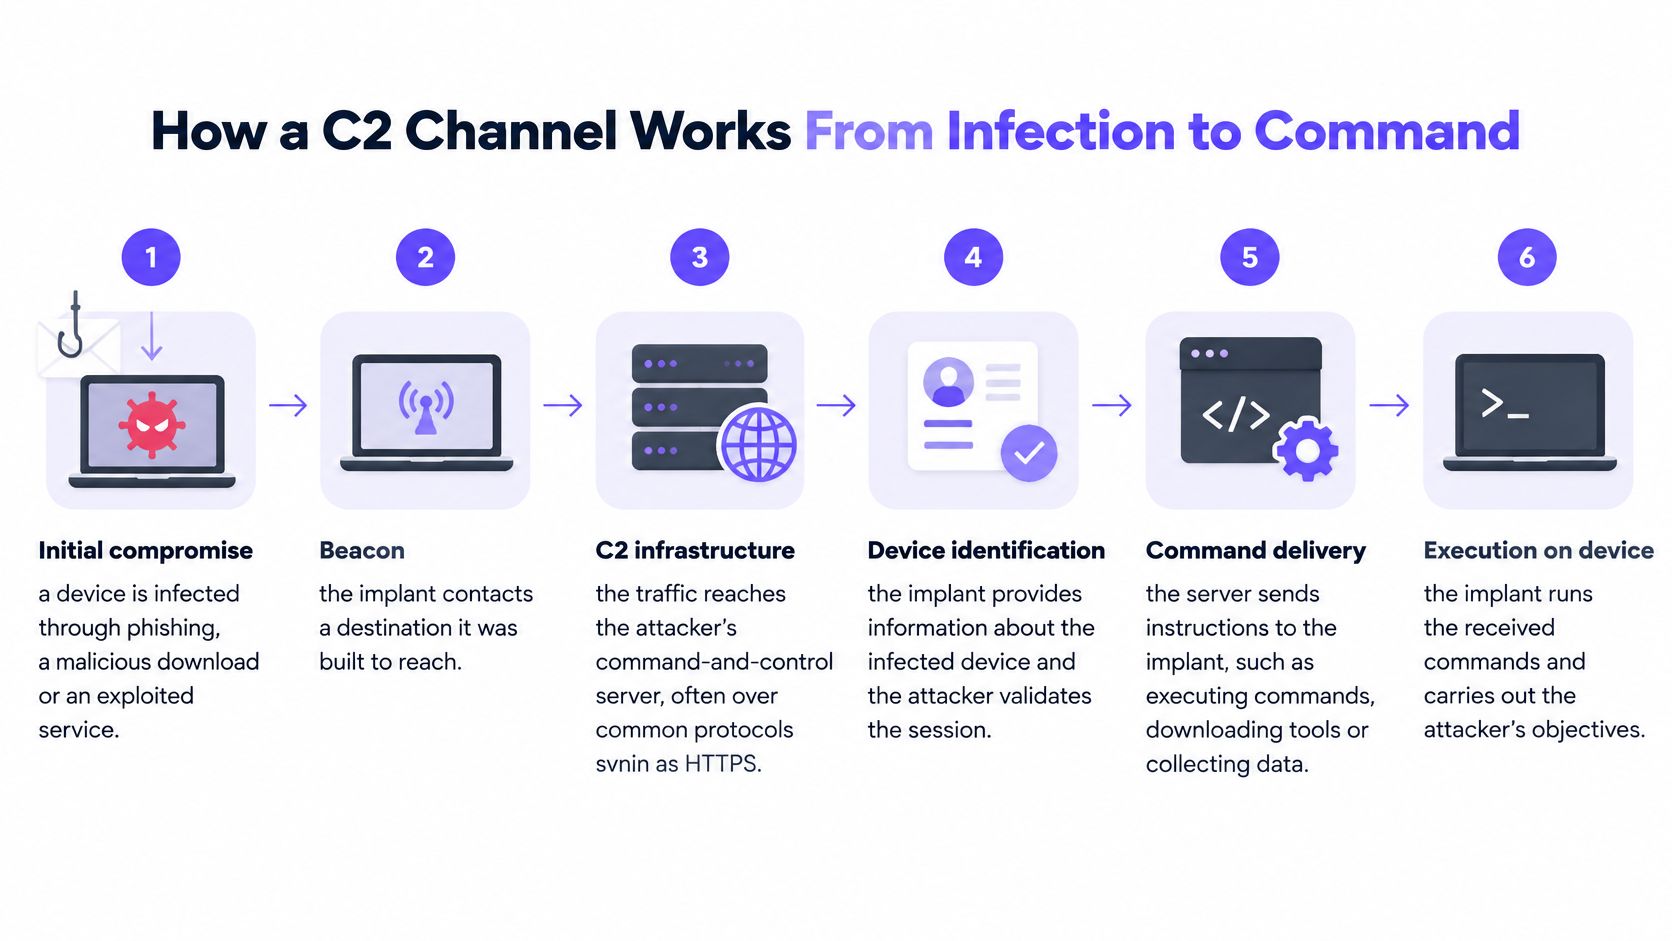
La siguiente secuencia separa la intención del software de realizar la comprobación de la actividad de red necesaria para completarla.
Compromiso inicial. Un archivo adjunto de phishing, una descarga maliciosa o un servicio explotado introducen un implante, es decir, el software que se ejecuta en el dispositivo comprometido. Los equipos de defensa deben distinguir el punto de entrada original de la actividad de red posterior, ya que bloquear uno no necesariamente resuelve el otro.
Preparación de la señal de localización (beacon). El implante prepara una verificación de estado, a menudo denominada beacon, para anunciar que está disponible y solicitar tareas. Un temporizador puede activar esta actividad sin que el usuario abra nada, por lo que la actividad del navegador por sí sola no explicará todas las conexiones.
Resolución de nombres. Si el destino utiliza un dominio y aún no hay una dirección utilizable disponible, el dispositivo solicita al DNS que traduzca ese nombre a una dirección. Este es un punto de decisión ligero y temprano donde los equipos de defensa pueden evaluar el destino antes de que comience la conexión correspondiente con el servidor.
Entrega de comandos. Si la comunicación es exitosa, el controlador puede devolver instrucciones, como descargar otra herramienta o recopilar archivos. Los equipos de defensa ahora tienen que considerar el contenido y las consecuencias del intercambio, no solo su destino.
Ejecución y acceso continuo. El implante lleva a cabo la tarea y puede devolver resultados o intentar una ruta alternativa si la comunicación falla. Por lo tanto, una investigación debe buscar actividades de seguimiento en lugar de tratar un solo intento bloqueado como el fin del incidente.
Interprete el patrón, no solo la solicitud
Una pequeña búsqueda que se repite con un programa regular hacia un dominio no familiar amerita una investigación. Una solicitud ocasional a un servicio conocido puede ser habitual, pero ni la frecuencia ni la familiaridad resuelven la pregunta por sí solas. El software de actualización legítimo también realiza comprobaciones de forma automática.
Para obtener un contexto más amplio, la sección tendencias de malware en números de Statlyst ofrece información sobre la actividad del malware. Sin embargo, a nivel operativo, su decisión debe basarse en el destino, el contexto de red del dispositivo solicitante y los eventos circundantes.
No es necesario encontrar el archivo malicioso antes de interrumpir su próxima comprobación dependiente del dominio. Esa es una contención útil, incluso mientras otra persona se encarga de la remediación del dispositivo.
Canales C2 comunes y cómo se mimetiza cada uno
Los diferentes canales de C2 se asemejan a distintos tipos de actividad legítima, por lo que los defensores necesitan controles adecuados para cada uno.
Canales de C2: cómo se camuflan y dónde detectarlos
| Canal | Por qué se mimetiza | Dónde la detectan los defensores |
|---|---|---|
| HTTP y HTTPS | El tráfico se asemeja a la navegación web habitual | Filtrado con reconocimiento de TLS y comprobaciones de reputación en destinos |
| DNS | Búsquedas de nombres que casi todas las redes deben permitir | Resolutor con categorías de amenazas y registro de consultas |
| Correo electrónico | Mensajes hacia y desde servidores de correo que los usuarios esperan | Escaneo en la puerta de enlace de correo en busca de enlaces y archivos adjuntos |
| Acceso remoto (RDP, telnet) | Parece sesiones de administrador | Segmentar redes de invitados y bloquear puertos de administración salientes |
| Protocolos industriales (DNP3, Modbus) | Tráfico previsto dentro de redes operativas | Monitoreo con reconocimiento de protocolos y segmentación de OT |
HTTP y HTTPS constituyen un disfraz útil porque las aplicaciones envían solicitudes web constantemente. Una pequeña devolución de llamada cifrada puede parecer una llamada de aplicación ordinaria. La reputación del destino ayuda, mientras que los controles compatibles con TLS requieren un despliegue cuidadoso, especialmente donde inspeccionar el tráfico cifrado de los invitados crearía problemas operativos y de privacidad.
El DNS tiene una ventaja diferente: los dispositivos necesitan resolución de nombres para los servicios habituales. El marco ATT&CK para sistemas de control industrial de MITRE registra el DNS como un mecanismo de C2 estándar en la capa de aplicación, lo que incluye ocultar datos en campos DNS y usar tunelización DNS. En este caso, el DNS no solo localiza un controlador; las consultas y respuestas pueden llevar mensajes en sí mismas.
Adapte el control al canal
El correo electrónico puede transportar instrucciones a través de la infraestructura de correo prevista. Las verificaciones de puerta de enlace en enlaces y archivos adjuntos son útiles, pero no sustituyen el monitoreo de la ruta de comunicación general.
Para los protocolos de acceso remoto, pregúntese por qué un dispositivo de invitado necesitaría acceso administrativo saliente. Restrinja los servicios innecesarios y mantenga las redes de invitados separadas de los sistemas de administración. La administración remota autorizada debe tener una ruta definida en lugar de una excepción generalizada.
Los protocolos industriales pertenecen a un contexto diferente. Un hospital o campus con equipo operativo debe mantener ese entorno separado del acceso de visitantes y utilizar un monitoreo que comprenda el comportamiento esperado del protocolo.
El cifrado también altera lo que los observadores pueden ver. Con DNS sobre HTTPS, las solicitudes de resolución de nombres viajan dentro de HTTPS, por lo que la aplicación del solucionador debe tomar en cuenta las alternativas cifradas en lugar de limitarse al tráfico DNS convencional.
El error común consiste en tratar un protocolo permitido como un propósito de confianza. Un puerto familiar o una conexión cifrada no garantizan que el destino sea seguro.
Por qué los atacantes recurren al DNS y a los dominios rotativos
Un destino estático ofrece a los defensores algo estable que bloquear. Los atacantes pueden dificultar la interrupción cambiando los nombres a los que el malware intenta acceder.
Un algoritmo de generación de dominios, o DGA por sus siglas en inglés, calcula nombres candidatos a partir de una semilla, la cual puede depender de la hora o fecha. En un ejemplo hipotético con semilla diaria, el malware genera un nuevo conjunto de nombres cada día, mientras que el atacante registra el nombre correspondiente. Es posible que la lista de bloqueos de ayer no contenga el destino de hoy.
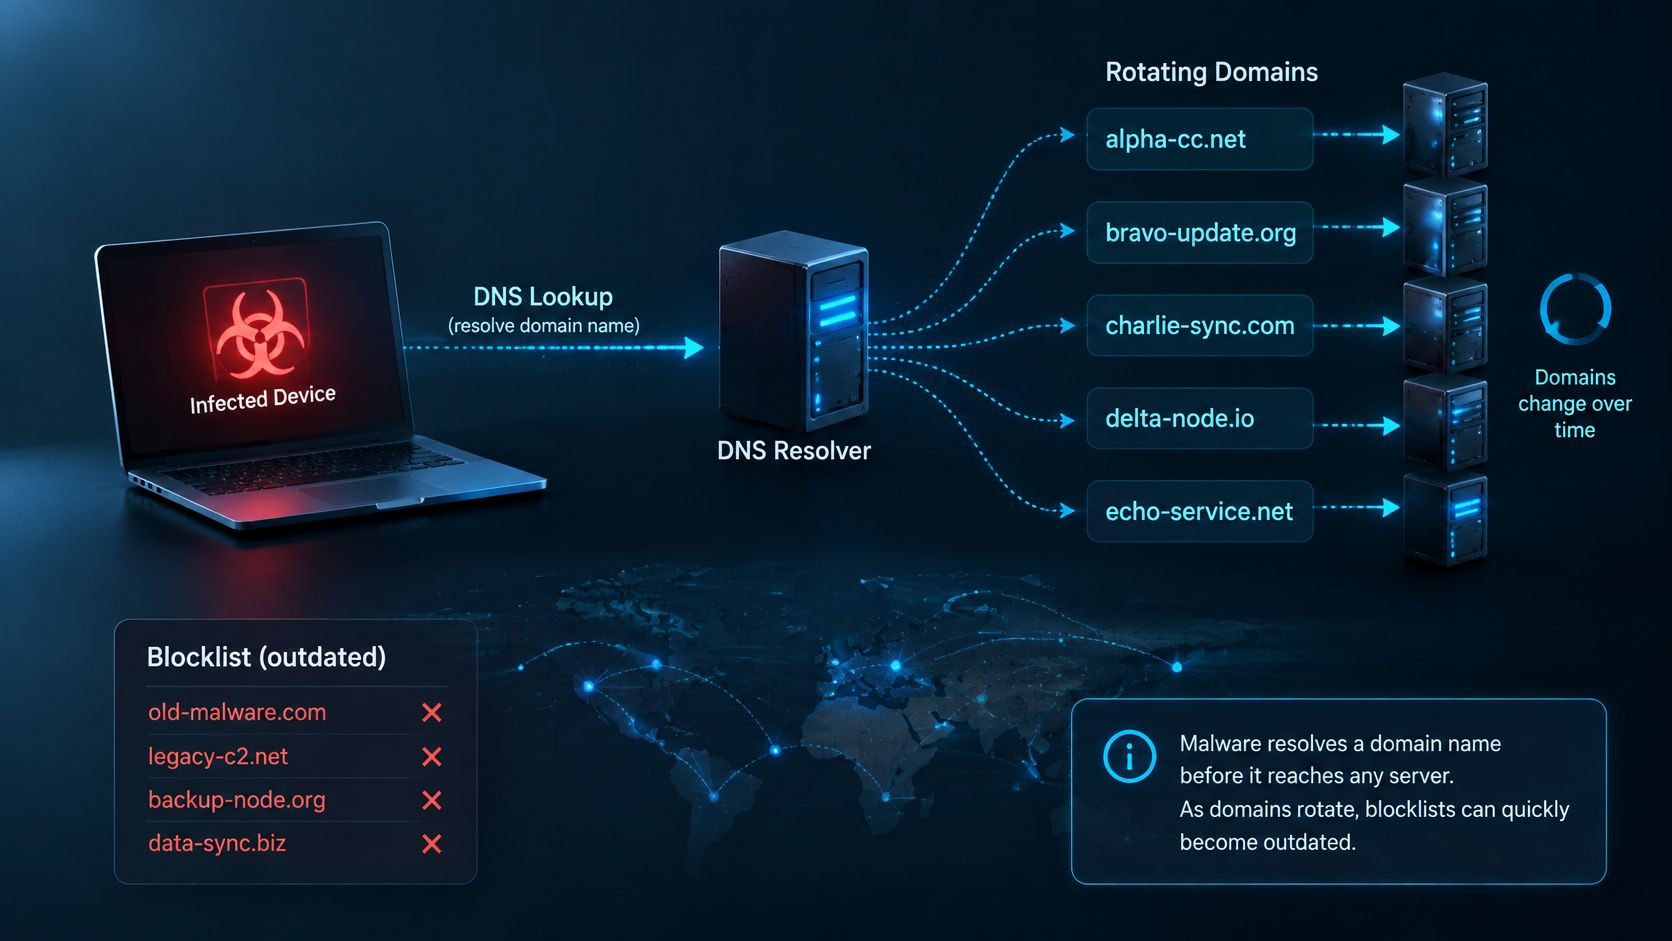
Los atacantes también pueden obtener direcciones o puertos de destino a partir de respuestas DNS, o alterar registros a través de infraestructura DNS de terceros comprometida. La guía de seguridad DNS de CISA describe los servicios de seguridad DNS como el análisis de consultas y la adopción de medidas de mitigación contra malware, ransomware, phishing, virus, sitios maliciosos y spyware.
Intervenga antes de aceptar el destino
Cuando un solucionador de protección reconoce un nombre malicioso, puede denegar la respuesta útil. Para una conexión que depende de esa respuesta, el entorno secundario cambiante del atacante nunca se convierte en el siguiente destino del dispositivo.
Eso no coloca al DNS en todas las rutas posibles de devolución de llamada. Las respuestas en caché, las direcciones codificadas de forma rígida y las rutas de resolución alternativas requieren otros controles. Pero donde es necesaria una nueva búsqueda, verificar el nombre es más práctico que rastrear individualmente cada dirección de servidor cambiante.
Señales de DNS que indican una retrollamada
Estos patrones de DNS ayudan a priorizar la investigación, pero cada uno es una pista, no una prueba de infección.
Señales de DNS: qué sugieren y cómo responder
| Señal | Lo que sugiere | Respuesta |
|---|---|---|
| Nombres de dominio de alta entropía que parecen aleatorios | Posible dominio C2 generado de forma algorítmica | Bloquear un dominio evaluado como malicioso y revisar el dispositivo de origen |
| Búsquedas repetidas a un mismo nombre en intervalos regulares | Posibles verificaciones tipo beaconing a un controlador | Generar una alerta e identificar el segmento de red |
| TTL muy corto en las respuestas | Posible rotación de infraestructura para evadir listas de bloqueo | Correlacionar con otras señales antes de actuar |
| Tráfico de consultas o respuestas con alto volumen de registros TXT | Comandos o datos posiblemente codificados en DNS | Investigar para detectar tunelización y bloquear un destino malicioso |
| Búsquedas fallidas repetidas a un mismo nombre | Posibles reintentos hacia un dominio inactivo o desviado a un sinkhole | Revisar el dispositivo y buscar dominios alternativos de respaldo |
La alta entropía significa que un nombre parece inusualmente impredecible. Los servicios legítimos también utilizan nombres generados por máquinas, por lo que la apariencia por sí sola no es una regla de bloqueo sólida.
Un tiempo de vida corto, o TTL, le indica a un solucionador que no conserve una respuesta por mucho tiempo. Eso puede respaldar cambios rápidos de infraestructura, pero los servicios legítimos también utilizan respuestas de corta duración. Del mismo modo, los registros TXT tienen propósitos legítimos aunque los atacantes puedan abusar de ellos para transportar contenido codificado.
Combine las pruebas antes de escalar
Un dominio de apariencia aleatoria resulta más preocupante cuando la misma fuente lo solicita a intervalos regulares, recibe respuestas de corta duración y luego intenta nombres relacionados tras los fallos. La combinación es más útil que tratar cada consulta inusual como una emergencia independiente.
Las fuentes de inteligencia de amenazas pueden aportar contexto sobre el destino. Utilice ese contexto junto con el historial de consultas, las decisiones de directivas y la atribución de red, no como un reemplazo de estos.
Regla práctica: Registre lo que observó la red por separado de lo que sospecha el analista.
Por ejemplo, un registro puede confirmar que un origen solicitó un dominio bloqueado. No confirma que el dispositivo haya ejecutado la orden de un atacante ni que la información haya salido de la red.
El WiFi para invitados hace que la atribución sea especialmente importante. La guía de implementación de redes de invitados de CISA exige que las solicitudes DNS de los invitados pasen a través de DNS protector y que el tráfico de los invitados se segmente y etiquete para que los eventos anómalos puedan clasificarse por grupo de origen.
Conserve la marca de tiempo, la información de la fuente solicitante, SSID o VLAN, el nombre consultado y el resultado de la directiva. Limite el acceso y la retención de acuerdo con los requisitos de privacidad de su organización. Puede coordinar una respuesta sin inspeccionar los archivos personales de un visitante ni recopilar detalles de identidad innecesarios.
Cómo las defensas a nivel de DNS detienen una retrollamada
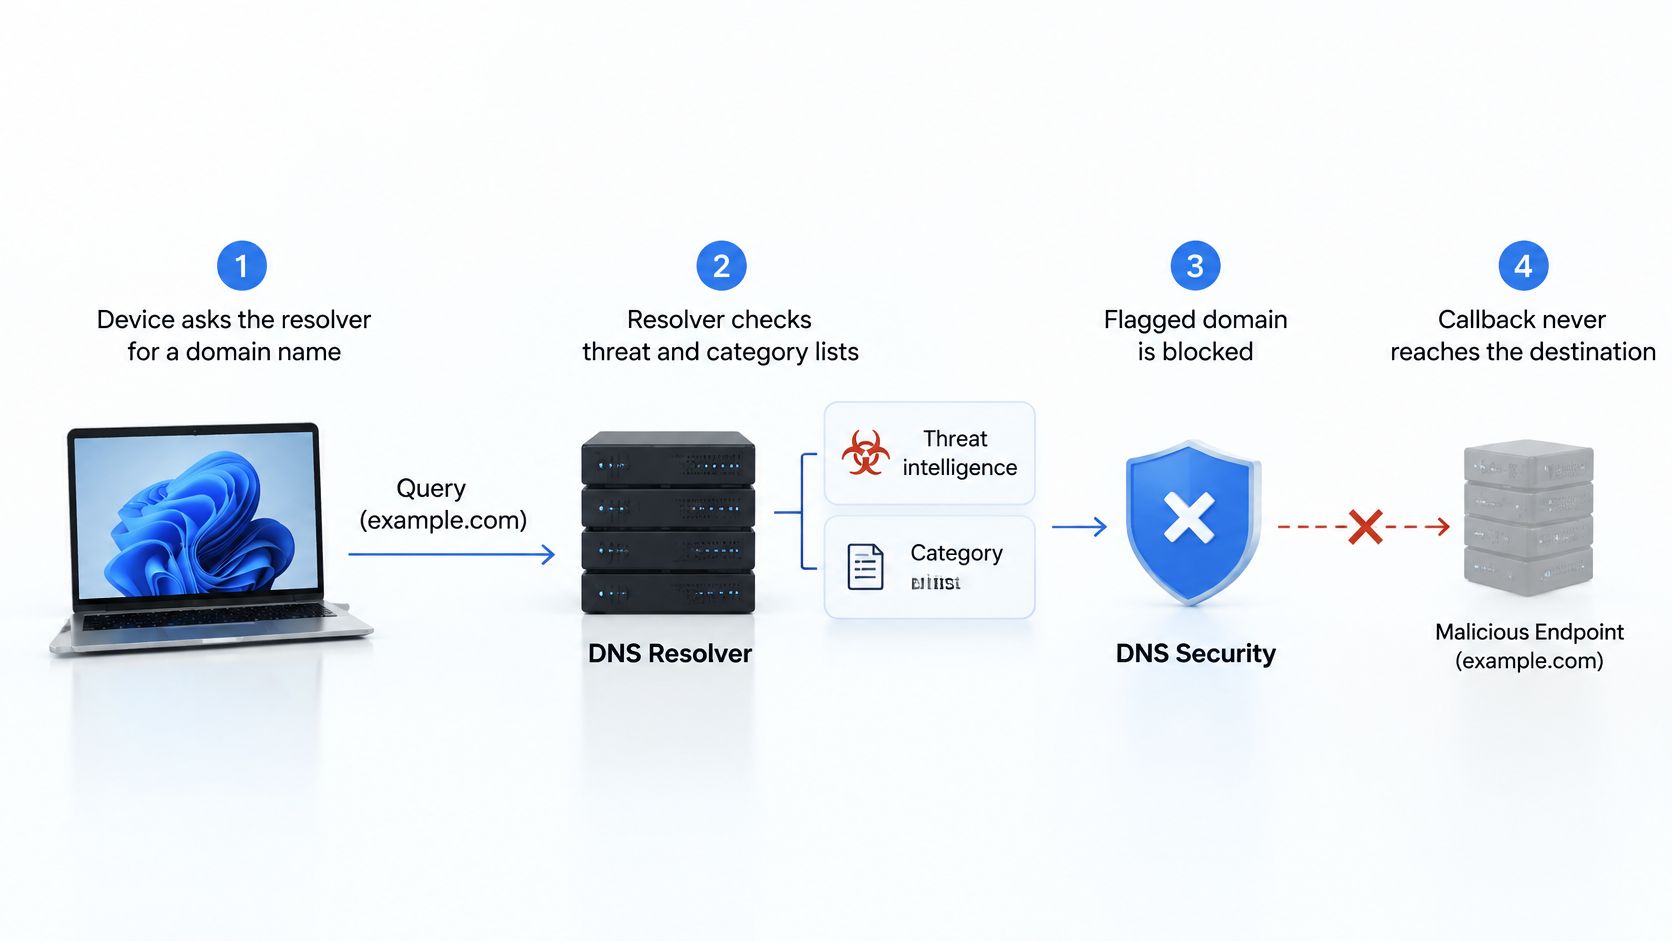
- El dispositivo solicita un nombre. Su consulta llega al resolutor aprobado.
- El resolutor verifica la directiva. La inteligencia contra amenazas y las reglas de categorías determinan si el destino está permitido.
- Se bloquea un destino malicioso. El resolutor devuelve una respuesta de bloqueo en lugar de la dirección de destino usable.
- Se registra la decisión. Los registros conservan la hora y el contexto de origen, con la atribución de SSID o VLAN proporcionada por la integración de la red.
El diagrama muestra esa decisión antes de la conexión con el destino.
Haga cumplir la política en la red WiFiWiFi para invitados
Configure las redes de invitados para que utilicen el resolvedor aprobado y restrinja las rutas de resolución no autorizadas. Planifique un comportamiento de cierre por falla para que una interrupción del servicio de directivas no permita solicitudes no verificadas sin detección, y evalúe las consecuencias de disponibilidad antes de la implementación.
Un DNS sinkhole es otro enfoque de respuesta que redirige una búsqueda maliciosa a un destino controlado. Sus registros deben diferenciar la redirección del rechazo o de cualquier otra respuesta de bloqueo.
El video ofrece una explicación adicional sobre el enfoque de protección de DNS.
El filtrado DNS no desinfecta el dispositivo. Las direcciones codificadas de forma rígida evitan la resolución de nombres y las sesiones ya establecidas pueden continuar, por lo que se recomienda combinar la protección DNS con la segmentación y las reglas de conexión saliente.
Detener una búsqueda requerida interrumpe las instrucciones a través de esa ruta, pero no elimina la infección.
Verifique su bloqueo de retrollamadas antes de un incidente
Utilice esta lista de verificación con su equipo de redes o TIC esta semana:
- Confirme la aplicación del resolutor. Verifique los SSID de invitados, personal y estudiantes por separado. Compruebe a dónde van sus solicitudes, en lugar de confiar únicamente en la configuración prevista.
- Pruebe los resultados permitidos y bloqueados. Desde cada SSID, intente acceder a un destino seguro conocido y al dominio de prueba inofensivo designado por el servicio de filtrado. No utilice infraestructura de malware activa.
- Ponga a prueba el comportamiento en caso de falla. En una ventana de mantenimiento aprobada, pruebe qué sucede cuando el servicio de políticas no está disponible. Confirme que la red siga la política prevista de cierre por falla y que el equipo reciba una alerta procesable.
- Inspeccione la atribución. Asegúrese de que los registros de eventos bloqueados contengan el SSID, la VLAN y la hora, ya sea directamente o mediante una correlación confiable. Verifique que un analista pueda recuperar la evidencia relevante.
- Asigne la responsabilidad de la escalación. Acuerde quién revisa una alerta, quién puede restringir un dispositivo de origen y quién se comunica con el recinto, el invitado o el propietario del dispositivo.
Realice cambios piloto sin interrumpir la infraestructura
Una prueba satisfactoria requiere algo más que una página de bloqueo visible. Conserve el resultado esperado, el resultado observado y la entrada de registro relevante para que otra persona pueda verificar lo sucedido.
Incluya la actividad habitual de los invitados en la prueba piloto. Verifique que la navegación legítima y los servicios esenciales del establecimiento sigan estando disponibles, y documente cómo debe proceder el personal ante un bloqueo por error. Una política con un alcance bien definido es más fácil de mantener que una interrupción sin explicación.
Para los clientes que gestionan el control de cambios, programamos una prueba piloto en un SSID junto con su equipo o proveedor de TIC antes de realizar cambios más amplios. Esto proporciona a los responsables de la aprobación un alcance definido y evidencia para revisar.
La decisión es sencilla: ¿puede su red actual demostrar qué bloqueó, dónde sucedió y quién debe responder? Si no puede, comience con la aplicación del solucionador y la atribución de origen en un piloto de SSID, y luego expanda solo después de que las pruebas produzcan resultados confiables.
Purple Shield bloquea las devoluciones de llamada de comando y control y los dominios conocidos de phishing y malware en la búsqueda de DNS, por lo que la conexión correspondiente nunca inicia. Visite Purple Shield para consultar cómo proteger su WiFi para invitados y planificar una prueba piloto con su equipo o proveedor de TIC.