
Qu'est-ce que le command and control ? Le C2 expliqué avec la défense DNS
Qu'est-ce que le command and control ? Découvrez le fonctionnement du C2, son utilisation par les attaquants et comment les défenses au niveau DNS bloquent les rappels avant qu'ils ne se connectent.
Published 7 novembre 2026
Le Command and Control (C2) est l'étape d'une cyberattaque au cours de laquelle un attaquant communique avec les systèmes qu'il a compromis et les dirige.
Vous gérez un réseau WiFi invité WiFi dans un hôtel, un campus ou un hôpital. Un visiteur connecte un ordinateur portable, accepte les conditions d'accès et commence à naviguer. Ce que vous ne pouvez pas voir, c'est si cet ordinateur portable est arrivé déjà infecté, ou si un logiciel fonctionnant en arrière-plan tente de contacter un attaquant.
L'appareil ne vous appartient pas et vous ne pouvez pas supposer qu'un agent de sécurité y est installé. En revanche, vous contrôlez la manière dont il utilise votre réseau. Pour les rappels qui dépendent d'un nom de domaine, la recherche DNS vous offre une opportunité précoce de vérifier la destination avant d'autoriser la connexion.
Table des matières
- Ce que signifie le command and control en termes simples
- Comment fonctionne un canal C2, de l'infection aux commandes
- Canaux C2 courants et méthodes de dissimulation
- Pourquoi les attaquants s'appuient sur le DNS et la rotation de domaines
- Signaux DNS indiquant une tentative de rappel (callback)
- Comment les défenses au niveau du DNS bloquent les rappels
- Vérifiez votre blocage des rappels avant qu'un incident ne survienne
Ce que signifie Command and Control en termes simples
Considérez un ordinateur portable infecté comme une voiture volée cachée dans un garage. Le vol initial a déjà eu lieu. Le C2 représente la télécommande que le voleur conserve, lui permettant de démarrer le moteur, de modifier son itinéraire et d'envoyer des instructions depuis un autre endroit.
La distinction est importante car s'introduire dans un appareil et le contrôler par la suite sont deux activités différentes.
Le Command and Control (C2) est l'étape d'une cyberattaque au cours de laquelle un attaquant communique avec les systèmes qu'il a compromis et les dirige.
L'hameçonnage, l'exploitation d'un service ou le vol d'identifiants peuvent constituer le point d'entrée. Le C2 fournit quant à lui le canal de communication continu. MITRE ATT&CK considère cela comme une tactique d'attaque distincte et documente 18 techniques de C2 d'entreprise, couvrant la communication avec des systèmes sous le contrôle d'un attaquant au sein du réseau d'une victime.
Cette communication ne doit pas nécessairement impliquer un serveur de logiciels malveillants évident. Les attaquants peuvent dissimuler des instructions sous forme de trafic ordinaire, coder des messages ou établir des itinéraires alternatifs.
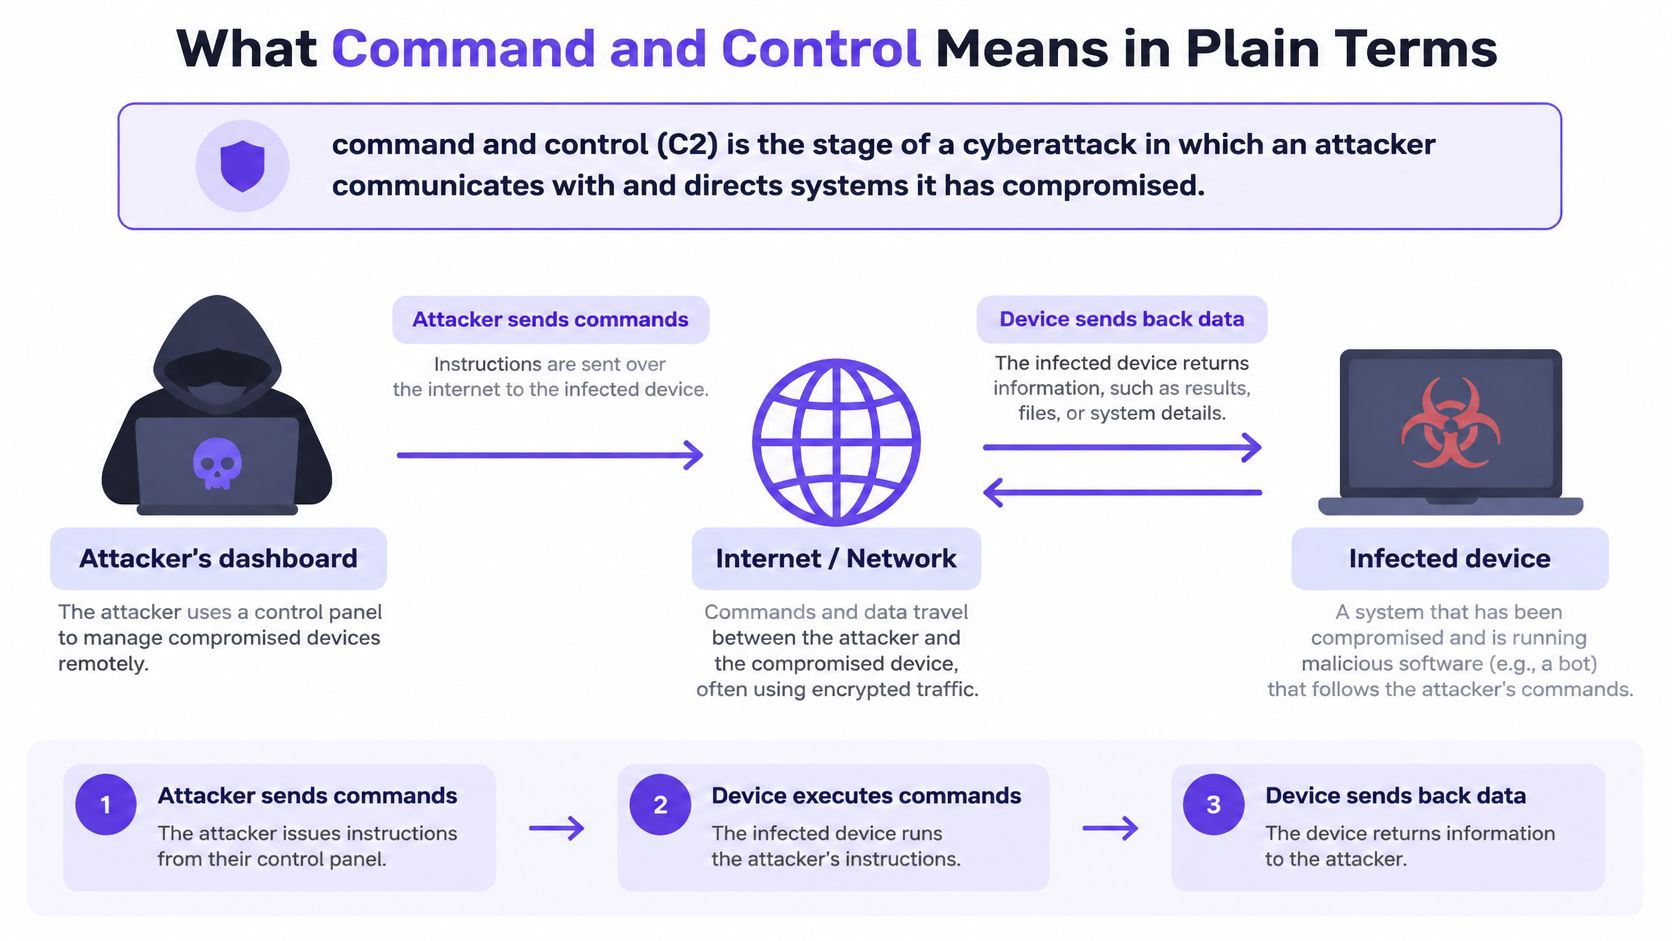
Ce qu'un contrôle continu permet à un attaquant de faire
Lorsqu'un canal opérationnel existe, l'attaquant peut ordonner au système compromis de :
- Exécuter des commandes : Exécuter des tâches en utilisant les accès disponibles pour le logiciel infecté.
- Télécharger des outils : Ajouter des capacités allant au-delà de celles de l'infection d'origine.
- Se déplacer latéralement : Tenter d'atteindre d'autres systèmes sur le réseau.
- Dérober des informations : Envoyer vers l'extérieur des fichiers accessibles ou des résultats collectés.
- Maintenir la persistance : Préserver l'accès afin que l'activité puisse se poursuivre ultérieurement.
Il s'agit d'actions possibles, et non d'un résultat automatique de chaque infection. Les autorisations, la segmentation et d'autres contrôles de sécurité restreignent toujours ce que l'attaquant peut accomplir.
De même, la suppression du téléchargement malveillant d'origine ne prouve pas que le contrôle a pris fin. Un autre composant ou une autre voie de communication peut subsister. Les équipes de défense doivent établir à la fois ce qui est en cours d'exécution et si des communications non autorisées fonctionnent toujours.
Pour un opérateur qui se demande ce qu'est le Command & Control en termes pratiques, la réponse est le pilotage à distance après un compromis. Sur un WiFi partagé, cela modifie la question défensive : il ne s'agit pas seulement de savoir si un appareil est infecté, mais si votre réseau lui permettra d'atteindre son contrôleur.
Comment fonctionne un canal C2, de l'infection au contrôle
Prenons le cas de l'ordinateur portable d'un visiteur infecté avant son arrivée dans votre établissement. Se connecter à votre WiFi n'est pas la cause de l'infection, mais cela peut offrir au logiciel malveillant une nouvelle voie d'accès à Internet.
La séquence suivante sépare l'intention du logiciel d'effectuer un contrôle de l'activité réseau nécessaire pour mener à bien ce contrôle.
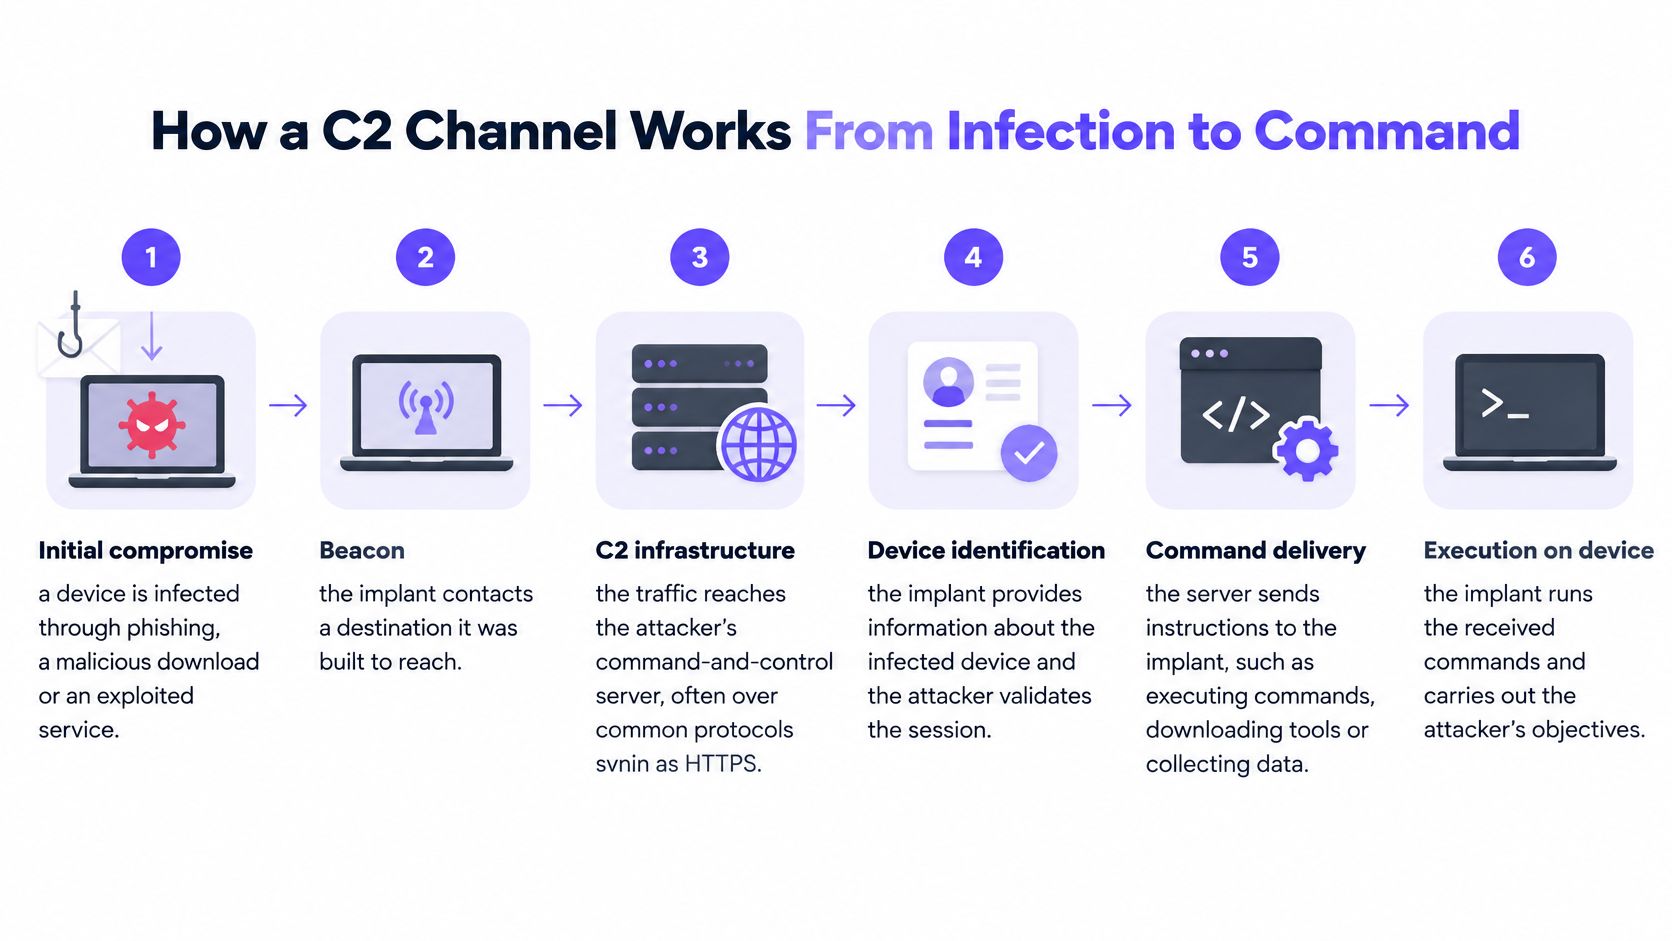
Compromission initiale. Une pièce jointe d'hameçonnage, un téléchargement malveillant ou un service exploité introduit un implant, c'est-à-dire le logiciel qui s'exécute sur l'appareil compromis. Les équipes de défense doivent distinguer le point d'entrée d'origine de l'activité réseau ultérieure, car le blocage de l'un n'éradique pas nécessairement l'autre.
Préparation des signaux de balisage (beacons). L'implant prépare une vérification de présence, souvent appelée beacon, afin d'annoncer qu'il est disponible et de demander des instructions. Un temporisateur peut déclencher cette activité sans que l'utilisateur n'ouvre quoi que ce soit ; l'activité du navigateur ne suffit donc pas à expliquer chaque connexion.
Résolution de nom. Si la destination utilise un domaine et qu'aucune adresse exploitable n'est déjà disponible, l'appareil demande au DNS de traduire ce nom en adresse. Il s'agit d'un point de décision précoce et léger où les défenseurs peuvent évaluer la destination avant le début de la connexion au serveur correspondant.
Transmission des commandes. Si la communication réussit, le contrôleur peut renvoyer des instructions, comme le téléchargement d'un autre outil ou la collecte de fichiers. Les équipes de défense doivent désormais prendre en compte le contenu et les conséquences de l'échange, et pas seulement sa destination.
Exécution et maintien de l'accès. L'implant exécute la tâche et peut renvoyer des résultats ou tenter un itinéraire alternatif en cas d'échec de la communication. Une investigation doit donc rechercher des activités de suivi au lieu de considérer une simple tentative bloquée comme la fin de l'incident.
Analyser le comportement, pas seulement la requête
Une recherche de petite taille répétée régulièrement vers un domaine inconnu mérite une investigation. Une requête occasionnelle vers un service connu peut être courante, mais ni la fréquence ni la notoriété ne permettent de trancher à elles seules. Les logiciels de mise à jour légitimes effectuent également des vérifications automatiques.
Pour un contexte plus large, l'étude de Statlyst sur les tendances des logiciels malveillants en chiffres fournit un éclairage sur l'activité des malwares. D'un point de vue opérationnel, votre décision doit toutefois reposer sur la destination, le contexte réseau de l'appareil émetteur et les événements environnants.
Vous n'avez pas besoin de trouver le fichier malveillant avant de perturber son prochain contrôle dépendant d'un domaine. C'est un confinement utile, même pendant que quelqu'un d'autre s'occupe de la résolution du problème sur l'appareil.
Les canaux C2 courants et la façon dont chacun s'infiltre
Les différents canaux C2 ressemblent à différents types d'activités légitimes, c'est pourquoi les équipes de défense ont besoin de contrôles adaptés à chacun d'entre eux.
Canaux C2, comment ils se fondent dans le trafic et où les intercepter
| Canal | Pourquoi il se fond dans le trafic | Où les défenseurs le détectent |
|---|---|---|
| HTTP et HTTPS | Le trafic ressemble à une navigation web de routine | Filtrage pris en charge par TLS et contrôles de réputation des destinations |
| DNS | Recherches de noms que presque tous les réseaux doivent autoriser | Résolveur avec catégories de menaces et journalisation des requêtes |
| Messages vers et depuis les serveurs de messagerie attendus par les utilisateurs | Analyse de la passerelle de messagerie pour les liens et pièces jointes | |
| Accès distant (RDP, telnet) | Ressemble à des sessions d'administration | Segmenter les réseaux invités et bloquer les ports d'administration sortants |
| Protocoles industriels (DNP3, Modbus) | Trafic attendu au sein des réseaux opérationnels | Surveillance prenant en charge les protocoles et segmentation OT |
HTTP et HTTPS offrent un camouflage efficace, car les applications envoient constamment des requêtes web. Un petit rappel chiffré peut ressembler à un appel applicatif ordinaire. La réputation de la destination constitue une aide, mais les contrôles prenant en charge TLS nécessitent un déploiement minutieux, en particulier lorsque l'inspection du trafic chiffré des invités engendrerait des problèmes opérationnels et de confidentialité.
Le DNS présente un autre avantage : les appareils ont besoin de la résolution de noms pour les services ordinaires. Le référentiel ATT&CK de MITRE pour les systèmes de contrôle industriel répertorie le DNS comme un mécanisme C2 standard de la couche application, incluant la dissimulation de données dans les champs DNS et l'utilisation du tunnel DNS. Ici, le DNS ne se contente pas de localiser un contrôleur ; les requêtes et les réponses peuvent transporter elles-mêmes des messages.
Adapter le contrôle au canal
L'e-mail peut acheminer des instructions via l'infrastructure de messagerie classique. Les contrôles de passerelle sur les liens et les pièces jointes sont utiles, mais ils ne remplacent pas la surveillance du parcours de communication dans son ensemble.
Concernant les protocole d'accès à distance, demandez-vous pourquoi un appareil invité aurait besoin d'un accès d'administration sortant. Restreignez les services inutiles et isolez les réseaux invités des systèmes de gestion. L'administration à distance autorisée doit disposer d'un itinéraire défini plutôt que d'une exception générale.
Les protocoles industriels relèvent d'un contexte différent. Un hôpital ou un campus disposant d'équipements opérationnels doit maintenir cet environnement séparé de l'accès des visiteurs et utiliser une surveillance capable de comprendre le comportement attendu des protocoles.
Le chiffrement modifie également ce que les observateurs peuvent voir. Avec le DNS over HTTPS, les requêtes de résolution de noms circulent au sein du trafic HTTPS ; l'application des règles par le résolveur doit donc prendre en compte les alternatives chiffrées et ne pas se limiter au seul trafic DNS conventionnel.
L'erreur courante consiste à traiter un protocole autorisé comme un usage de confiance. Un port familier ou une connexion chiffrée ne garantissent pas que la destination est sûre.
Pourquoi les attaquants s'appuient sur le DNS et les domaines rotatifs
Une destination statique offre aux défenseurs un élément stable à bloquer. Les attaquants peuvent rendre la neutralisation plus difficile en modifiant les noms que le logiciel malveillant tente d'atteindre.
Un algorithme de génération de domaines (DGA) calcule des noms candidats à partir d'une graine, qui peut dépendre du temps. Dans un exemple hypothétique avec graine quotidienne, le logiciel malveillant génère un nouvel ensemble de noms chaque jour, tandis que l'attaquant enregistre un nom correspondant. La liste de blocage d'hier peut ne pas contenir la destination d'aujourd'hui.
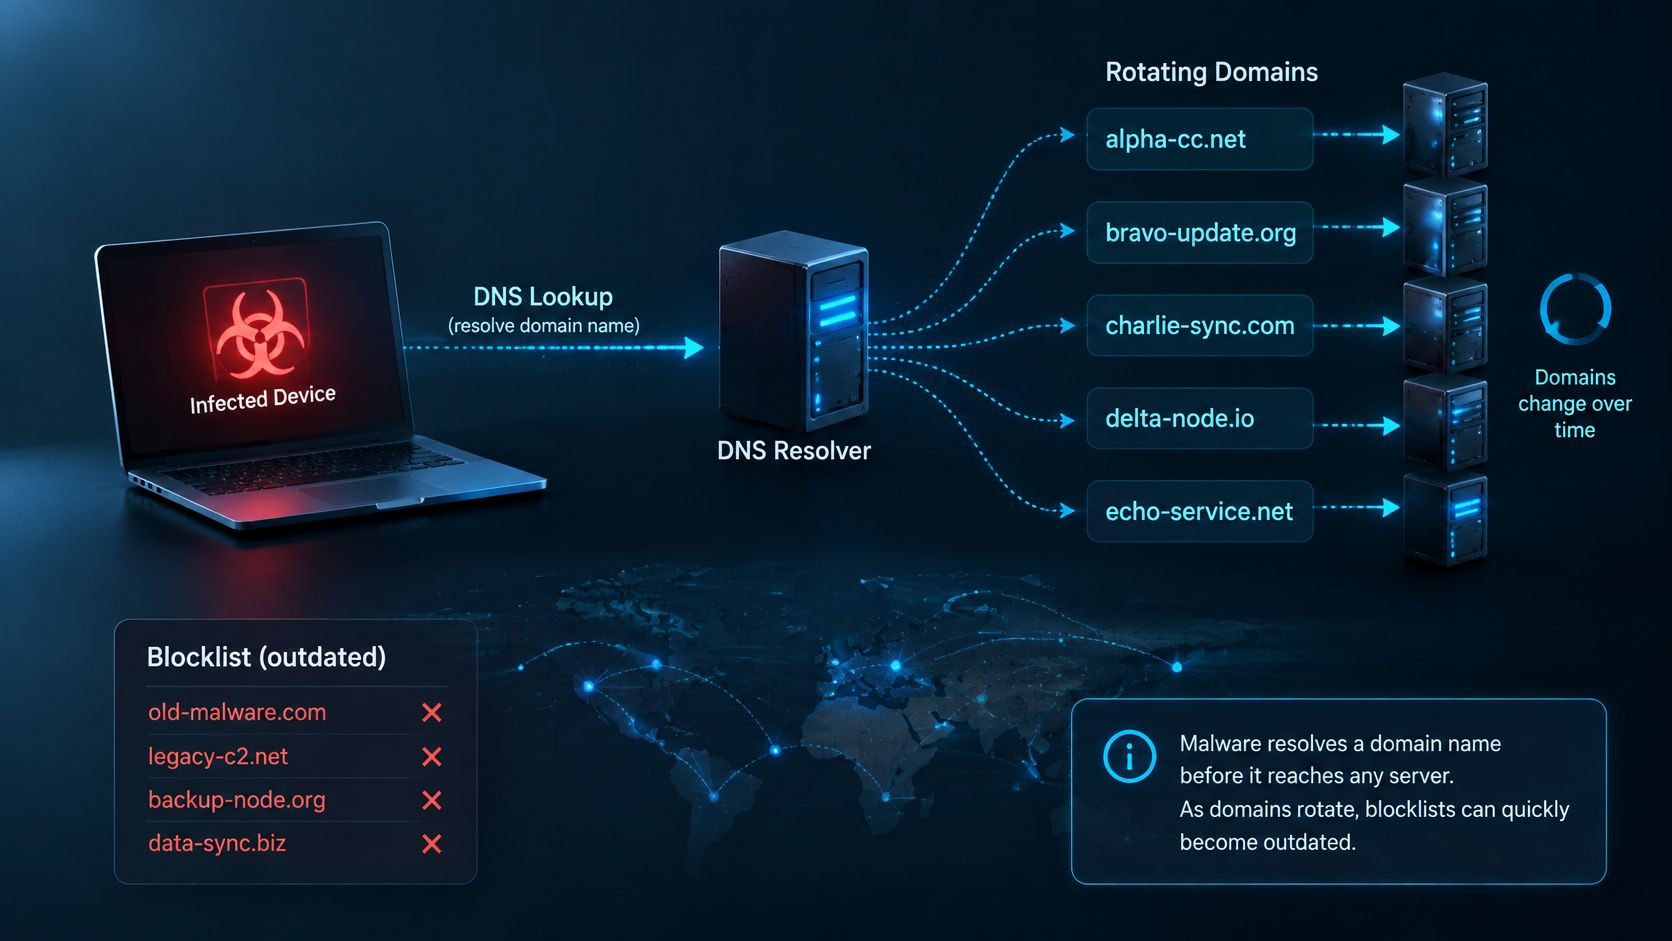
Les attaquants peuvent également déduire les adresses ou ports de destination à partir des réponses DNS, ou modifier les enregistrements via une infrastructure DNS tierce compromise. Les recommandations de la CISA sur la sécurité DNS indiquent que les services de sécurité DNS analysent les requêtes et prennent des mesures d'atténuation contre les logiciels malveillants, les ransomwares, l'hameçonnage, les virus, les sites malveillants et les logiciels espions.
Intervenir avant d'accepter la destination
Lorsqu'un résolveur protecteur identifie un nom malveillant, il peut refuser de fournir la réponse exploitable. Pour une connexion dépendante de cette réponse, l'infrastructure distante évolutive de l'attaquant ne devient jamais la destination suivante de l'appareil.
Cela ne place pas le DNS sur tous les chemins de rappel possibles. Les réponses en cache, les adresses codées en dur et les itinéraires de résolution alternatifs nécessitent d'autres contrôles. Toutefois, lorsqu'une nouvelle recherche est nécessaire, la vérification du nom s'avère plus pratique que la recherche individuelle de chaque adresse de serveur modifiée.
Signaux DNS indiquant un rappel
Ces modèles DNS aident à prioriser l'investigation, mais chacun est un indice, pas une preuve d'infection.
Signaux DNS, ce qu'ils suggèrent et comment réagir
| Signal | Hypothèse associée | Réponse |
|---|---|---|
| Noms de domaine aléatoires et à forte entropie | Domaine C2 potentiellement généré par algorithme | Bloquer un domaine évalué comme malveillant et examiner l'appareil source |
| Recherches répétées pour un nom à intervalles réguliers | Signaux de balisage potentiels vers un contrôleur | Déclencher une alerte et identifier le segment réseau |
| TTL très court sur les réponses | Rotation d'infrastructure potentielle pour contourner les listes de blocage | Corréler avec d'autres signaux avant d'agir |
| Trafic de requêtes ou de réponses fort en enregistrements TXT | Commandes ou données potentiellement encodées dans le DNS | Rechercher une éventuelle création de tunnel et bloquer la destination malveillante |
| Échecs de recherche répétés pour un nom | Tentatives répétées potentielles contre un domaine inactif ou redirigé (sinkhole) | Vérifier l'appareil et rechercher des domaines de secours |
Une entropie élevée signifie qu'un nom semble particulièrement imprévisible. Les services légitimes utilisent également des noms générés par machine, donc l'apparence seule ne constitue pas une règle de blocage fiable.
Un durée de vie (TTL) courte indique à un résolveur de ne pas conserver une réponse longtemps. Cela peut faciliter les changements rapides d'infrastructure, mais les services légitimes utilisent également des réponses à courte durée de vie. De même, les enregistrements TXT ont des usages légitimes, bien que des attaquants puissent les détourner pour transporter du contenu encodé.
Regrouper les preuves avant toute escalade
Un domaine d'apparence aléatoire devient plus préoccupant lorsque la même source le demande à intervalles réguliers, reçoit des réponses à courte durée de vie, puis tente d'interroger des noms associés après des échecs. La combinaison de ces éléments est plus utile que le fait de traiter chaque requête inhabituelle comme une urgence distincte.
Les flux de Threat Intelligence peuvent apporter du contexte sur les destinations. Utilisez ce contexte en complément de l'historique des requêtes, des décisions de politique et de l'attribution réseau, et non pour les remplacer.
Règle pratique : Enregistrez ce que le réseau a observé séparément de ce que l'analyste soupçonne.
Par exemple, un journal peut établir qu'une source a demandé un domaine bloqué. Il n'établit pas que l'appareil a exécuté la commande d'un attaquant ou que des données ont quitté le réseau.
Le WiFi invité WiFi rend l'attribution particulièrement importante. Les directives de mise en œuvre des réseaux invités de la CISA préconisent que les requêtes DNS des invités transitent par un DNS protecteur et que le trafic invité soit segmenté et étiqueté afin de pouvoir trier les événements anormaux par groupe source.
Conservez l'horodatage, les informations sur la source de la requête, SSID ou VLAN, le nom interrogé et le résultat de la politique. Limitez l'accès et la rétention conformément aux exigences de confidentialité de votre organisation. Vous pouvez coordonner une réponse sans inspecter les fichiers personnels d'un visiteur ni collecter des données d'identité superflues.
Comment les défenses au niveau du DNS bloquent un rappel
- L'appareil demande un nom. Sa requête atteint le résolveur approuvé.
- Le résolveur vérifie la politique. Les informations sur les menaces et les règles de catégorie déterminent si la destination est autorisée.
- Une destination malveillante est bloquée. Le résolveur renvoie une réponse de blocage plutôt que l'adresse de destination utilisable.
- La décision est enregistrée. Les journaux conservent l'heure et le contexte de la source, avec l'attribution SSID ou VLAN fournie par l'intégration réseau.
Le schéma montre cette décision avant la connexion à la destination.
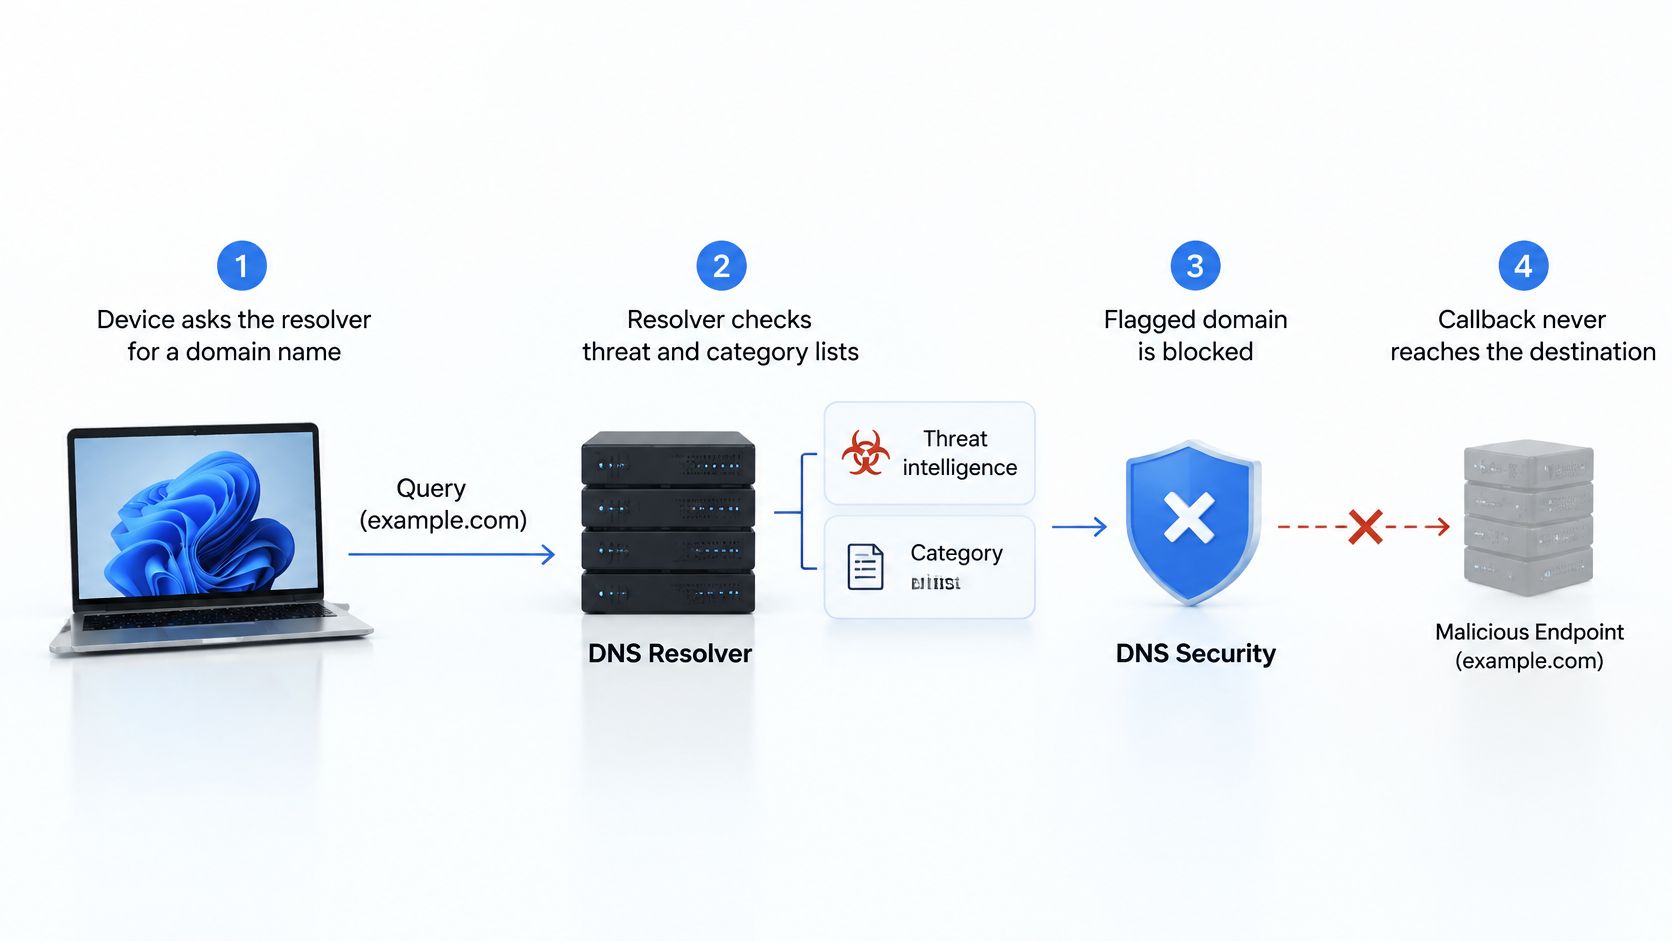
Appliquer la politique sur le WiFi invitéWiFi
Configurez les réseaux invités pour utiliser le résolveur approuvé et restreindre les itinéraires de résolution non autorisés. Prévoyez un comportement de fermeture en cas de défaillance afin qu'une panne du service de politique ne permette pas de requêtes non vérifiées sans détection, et testez les conséquences sur la disponibilité avant le déploiement.
Un DNS sinkhole constitue une autre méthode de réponse, qui réoriente une recherche malveillante vers une destination contrôlée. Vos journaux doivent distinguer la réorientation du refus ou de toute autre réponse de blocage.
La vidéo fournit une explication supplémentaire de l'approche de protection DNS.
Le filtrage DNS ne nettoie pas l'appareil. Les adresses codées en dur contournent la résolution de noms, et les sessions déjà établies peuvent se poursuivre. Il convient donc d'associer la protection DNS à la segmentation et à des règles de connexion sortante.
L'arrêt d'une recherche requise interrompt les instructions via cet itinéraire, mais ne supprime pas l'infection.
Vérifiez le blocage des rappels avant qu'un incident ne survienne
Utilisez cette liste de contrôle avec votre équipe réseau ou TIC cette semaine :
- Confirmer l'application sur le résolveur. Vérifiez séparément les SSID invités, du personnel et des étudiants. Vérifiez la destination réelle de leurs requêtes au lieu de vous fier uniquement à la configuration prévue.
- Tester les autorisations et les blocages. Depuis chaque SSID, tentez d'accéder à une destination connue comme sûre et au domaine de test inoffensif désigné par le service de filtrage. N'utilisez pas d'infrastructure malveillante active.
- Tester le comportement en cas de défaillance. Lors d'une fenêtre de maintenance approuvée, testez ce qui se produit lorsque le service de politique n'est pas disponible. Confirmez que le réseau applique la politique de fermeture sécurisée prévue (fail-closed) et que l'équipe reçoit une alerte exploitable.
- Inspecter l'attribution. Assurez-vous que les enregistrements d'événements bloqués contiennent le SSID, l' VLAN et l'heure, directement ou par une corrélation fiable. Vérifiez qu'un analyste peut récupérer les preuves pertinentes.
- Attribuer la responsabilité de l'escalade. Déterminez qui examine une alerte, qui peut restreindre un appareil source et qui communique avec le site, l'invité ou le propriétaire de l'appareil.
Tester les modifications sans perturber le parc informatique
Un test réussi nécessite plus qu'une page de blocage visible. Conservez le résultat attendu, le résultat observé et l'entrée de journal correspondante afin qu'une autre personne puisse vérifier ce qui s'est produit.
Intégrez l'activité habituelle des visiteurs dans la phase pilote. Vérifiez que la navigation légitime et les services essentiels de l'établissement restent utilisables, et documentez la marche à suivre par le personnel en cas de blocage erroné. Une politique au périmètre clairement défini est plus facile à gérer qu'une interruption inexpliquée.
Pour les clients appliquent une gestion des changements, nous planifions un pilote sur un SSID avec votre équipe ou votre prestataire TIC avant toute modification plus large. Cela offre aux responsables de la validation un périmètre défini et des éléments probants à examiner.
La décision est simple : votre réseau actuel peut-il prouver ce qu'il a bloqué, où cela s'est produit et qui doit intervenir ? Si ce n'est pas le cas, commencez par appliquer le filtrage sur le résolveur et l'attribution des sources dans le cadre d'un pilote SSID, puis étendez le dispositif seulement après l'obtention de résultats fiables lors des tests.
Purple Shield bloque les rappels de commande et contrôle ainsi que les domaines malveillants et d'hameçonnage connus dès la résolution DNS, afin que la connexion correspondante ne s'établisse jamais. Consultez Purple Shield pour découvrir comment protéger votre WiFi invité WiFi et planifier un projet pilote avec votre équipe ou votre prestataire TIC.