
Che cos'è il Command and Control? Il C2 spiegato con la difesa DNS
Che cos'è il Command and Control? Scopra come funziona il C2, come viene utilizzato dagli aggressori e come le difese a livello di DNS bloccano i callback prima della connessione.
Published 7 novembre 2026
Il Command and Control (C2) è la fase di un attacco informatico in cui un malintenzionato comunica con i sistemi compromessi e li dirige.
Gestisce il WiFi per ospiti WiFi in un hotel, campus o ospedale. Un visitatore connette un laptop, accetta i termini di accesso e inizia la navigazione. Ciò che Lei non può vedere è se quel laptop sia arrivato già infetto o se un software in esecuzione in background stia cercando di contattare un malintenzionato.
Il dispositivo non è di Sua proprietà e non è possibile presumere che vi sia installato un agente di sicurezza. Tuttavia, Lei ha il controllo su come tale dispositivo utilizza la rete. Per i callback che dipendono da un nome di dominio, la risoluzione DNS offre un'opportunità tempestiva per verificare la destinazione prima di autorizzare una connessione.
Sommario
- Che cosa significa Command and Control in parole semplici
- Come funziona un canale C2 dall'infezione al comando
- Canali C2 comuni e modalità di mimetizzazione di ciascuno
- Perché gli aggressori si affidano a DNS e domini rotanti
- Segnali DNS che indicano un callback
- Come le difese a livello DNS bloccano un callback
- Verificare il blocco dei callback prima che si verifichi un incidente
Che cosa significa Command and Control in parole semplici
Un portatile infetto può essere paragonato a un'auto rubata e nascosta in un garage. Il furto iniziale si è già verificato. Il C2 è il radiocomando in possesso del malintenzionato, che gli consente di avviare il motore, modificarne il percorso e inviare istruzioni da remoto.
La distinzione è importante perché introdursi in un dispositivo e controllarlo successivamente sono attività diverse.
Il Command and Control (C2) è la fase di un attacco informatico in cui un malintenzionato comunica con i sistemi compromessi e li dirige.
Il phishing, un servizio vulnerabile o credenziali rubate possono fornire il punto di ingresso. Il C2 fornisce il percorso di comunicazione continuo. MITRE ATT&CK tratta questa come una tattica distinta dell'avversario e documenta 18 tecniche Enterprise C2, che coprono la comunicazione con i sistemi sotto il controllo di un attaccante all'interno della rete della vittima.
Tale comunicazione non deve necessariamente coinvolgere un server malware evidente. Gli aggressori possono mascherare le istruzioni da traffico ordinario, codificare i messaggi o stabilire percorsi alternativi.
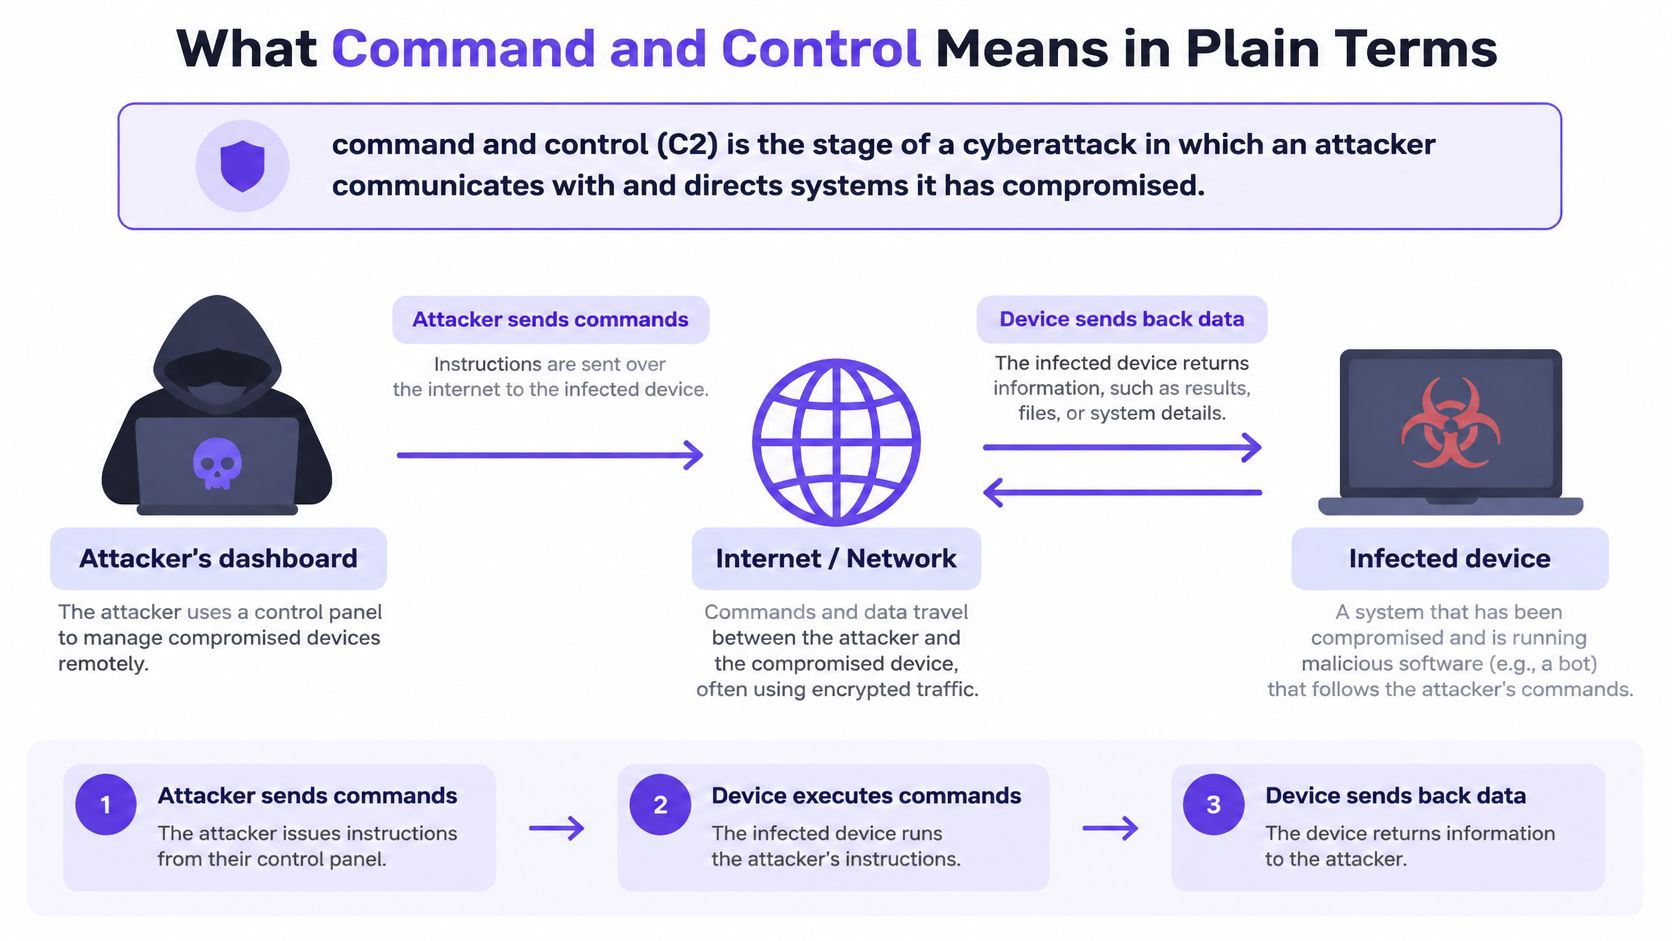
Che cosa consente di fare a un attaccante il controllo continuativo
Una volta stabilito un canale attivo, l'attaccante può istruire il sistema compromesso a:
- Esecuzione di comandi: eseguire le attività utilizzando l'accesso disponibile per il software infetto.
- Download di strumenti: aggiungere funzionalità oltre a quelle presenti nell'infezione originale.
- Spostamento laterale: tentare di raggiungere altri sistemi sulla rete.
- Sottrazione di informazioni: inviare all'esterno i file accessibili o i risultati raccolti.
- Mantenimento della persistenza: preservare l'accesso in modo che l'attività possa proseguire in seguito.
Si tratta di azioni possibili, non del risultato automatico di ogni infezione. Le autorizzazioni, la segmentazione e altri controlli di sicurezza limitano comunque ciò che l'aggressore può ottenere.
Allo stesso modo, l'eliminazione del download malevolo originale non costituisce la prova dell'avvenuta cessazione del controllo. Un altro componente o canale di comunicazione potrebbe rimanere attivo. I responsabili della sicurezza devono verificare sia i processi in esecuzione, sia l'eventuale operatività di comunicazioni non autorizzate.
Per un operatore che si chiede che cos'è il command and control in termini pratici, la risposta è la gestione remota a seguito di una compromissione. Su reti WiFi condivise, questo cambia il quesito difensivo: non ci si chiede solo se un dispositivo sia infetto, ma se la rete gli consentirà di raggiungere il proprio controller.
Come funziona un canale C2 dall'infezione al comando
Si consideri il portatile di un visitatore già infetto prima dell'arrivo nella struttura. La connessione alla rete WiFi non causa l'infezione, ma potrebbe offrire al software malevolo una nuova via di accesso a Internet.
La seguente sequenza separa l'intenzione del software di effettuare il check-in dall'attività di rete necessaria per completare tale check-in.
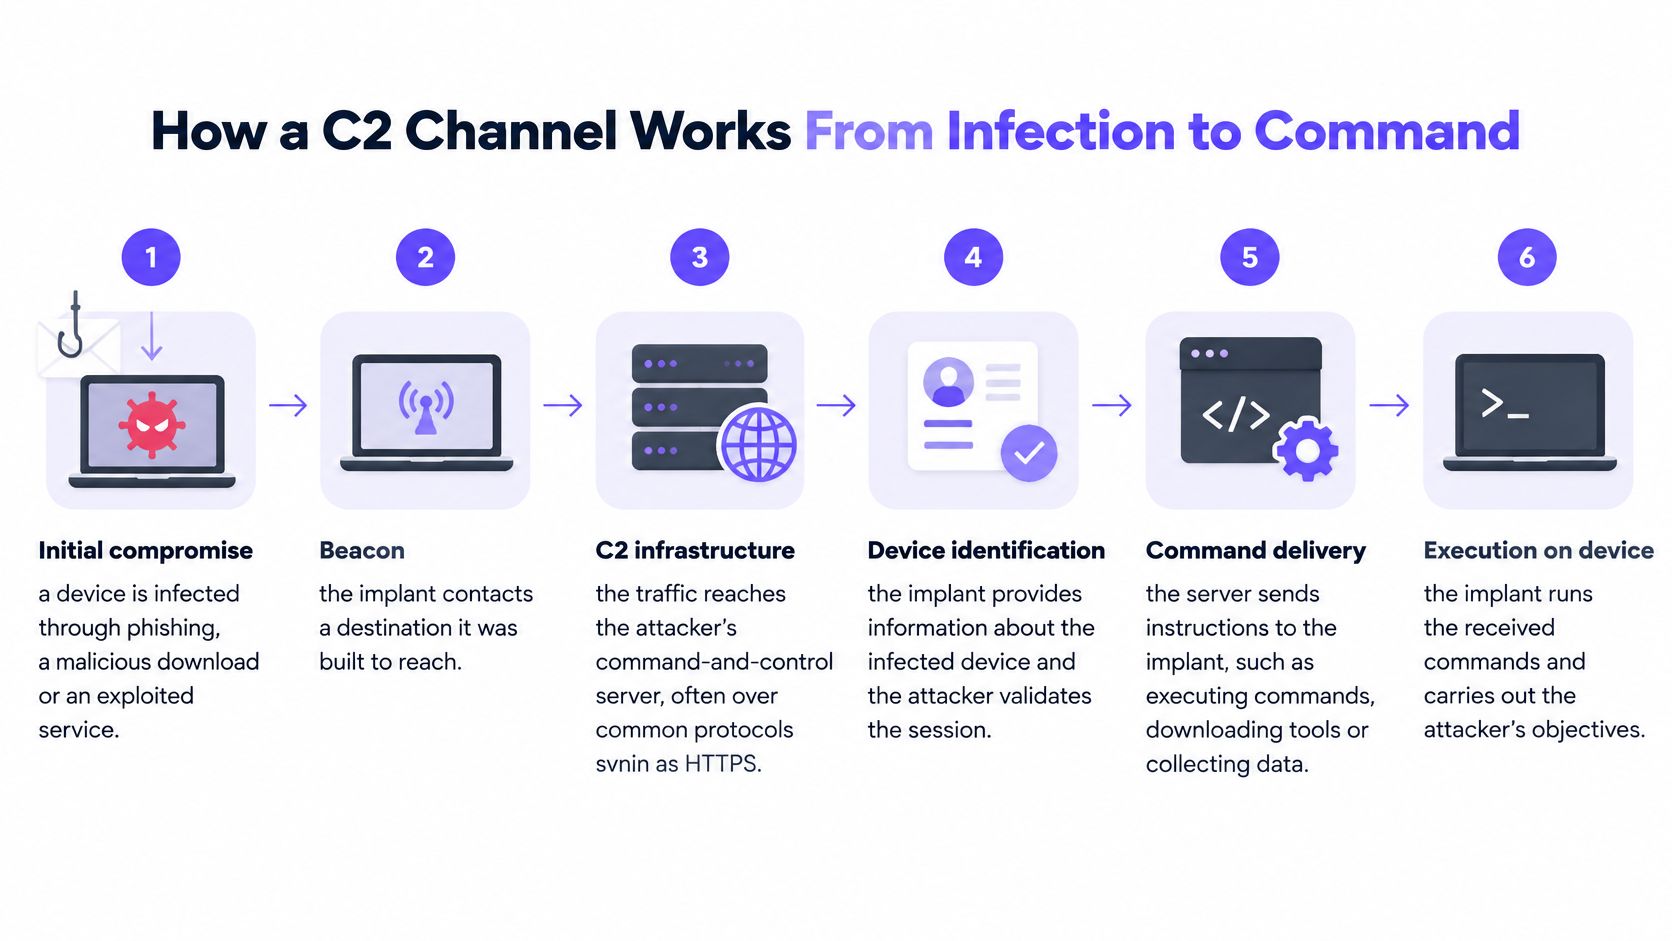
Compromissione iniziale. Un allegato di phishing, un download malevolo o un servizio vulnerato introduce un implant, ossia il software in esecuzione sul dispositivo compromesso. Chi si occupa della difesa deve distinguere il punto d'ingresso originale dalle successive attività di rete, poiché il blocco del primo non risolve necessariamente le seconde.
Preparazione del beacon. L'implant prepara un check-in, spesso chiamato beacon, per segnalare la propria disponibilità e richiedere istruzioni. Un timer può attivare questa attività senza che l'utente apra nulla, pertanto l'attività del browser da sola non spiega ogni connessione.
Risoluzione dei nomi. Se la destinazione utilizza un dominio e non è disponibile alcun indirizzo utilizzabile, il dispositivo richiede al DNS di tradurre tale nome in un indirizzo. Questo è un punto di decisione tempestivo e leggero in cui chi si occupa della difesa può valutare la destinazione prima dell'avvio della relativa connessione al server.
Invio dei comandi. Se la comunicazione ha esito positivo, il controller può restituire istruzioni, come il download di un altro strumento o la raccolta di file. Chi si occupa della difesa deve ora considerare il contenuto e le conseguenze dello scambio, non solo la sua destinazione.
Esecuzione e accesso continuato. L'implant esegue il compito e può restituire i risultati o tentare un percorso alternativo se la comunicazione fallisce. Un'indagine deve quindi cercare le attività successive anziché considerare un singolo tentativo bloccato come la conclusione dell'incidente.
Analizzare il pattern, non solo la richiesta
Una ricerca di ridotte dimensioni ripetuta a intervalli regolari verso un dominio sconosciuto merita un'indagine. Una richiesta occasionale a un servizio noto può rientrare nella routine, ma né la tempistica né la familiarità risolvono la questione da sole. Anche i software di aggiornamento legittimi eseguono controlli automatici.
Per un quadro generale più ampio, il report di Statlyst sui trend dei malware in numeri fornisce contesto sull'attività dei malware. A livello operativo, tuttavia, la Sua decisione dovrebbe basarsi sulla destinazione, sul contesto di rete del dispositivo richiedente e sugli eventi circostanti.
Non è necessario individuare il file malevolo prima di interrompere il suo successivo check-in dipendente dal dominio. Si tratta di un contenimento utile, anche mentre qualcun altro si occupa della bonifica del dispositivo.
I più comuni canali C2 e come ciascuno di essi si mimetizza
I diversi canali C2 assomigliano a differenti tipi di attività legittime, pertanto chi si occupa della difesa necessita di controlli adeguati a ciascuno di essi.
Canali C2, come mimetizzarsi e dove individuarli
| Canale | Perché si mimetizza | Dove viene intercettato dai difensori |
|---|---|---|
| HTTP e HTTPS | Il traffico assomiglia alla normale navigazione web | Filtraggio TLS e verifiche della reputazione sulle destinazioni |
| DNS | Risoluzioni dei nomi che quasi tutte le reti devono consentire | Resolver con categorie di minaccia e registrazione delle query |
| Messaggi da e verso i server di posta previsti dagli utenti | Scansione del mail gateway per link e allegati | |
| Accesso remoto (RDP, telnet) | Assomiglia a sessioni di amministrazione | Segmentazione delle reti ospiti e blocco delle porte admin in uscita |
| Protocolli industriali (DNP3, Modbus) | Traffico previsto all'interno delle reti operative | Monitoraggio basato su protocollo e segmentazione OT |
HTTP e HTTPS costituiscono un ottimo travestimento perché le applicazioni inviano costantemente richieste web. Una piccola callback crittografata può assomigliare a una normale chiamata applicativa. La reputazione della destinazione è di aiuto, mentre i controlli basati su TLS richiedono un'implementazione attenta, in particolare laddove l'ispezione del traffico crittografato degli ospiti creerebbe problemi operativi e di riservatezza.
Il DNS presenta un vantaggio diverso: i dispositivi necessitano della risoluzione dei nomi per i servizi ordinari. Il framework ATT&CK di MITRE per i sistemi di controllo industriale registra il DNS come un meccanismo standard C2 a livello di applicazione, inclusi il mascheramento dei dati nei campi DNS e l'uso del tunneling DNS. In questo caso, il DNS non si limita a individuare un controller; le query e le risposte stesse possono trasportare messaggi.
Adattare il controllo al canale
L'e-mail può veicolare istruzioni attraverso l'infrastruttura di posta prevista. I controlli del gateway su link e allegati sono utili, ma non sostituiscono il monitoraggio del percorso di comunicazione complessivo.
Per i protocolli di accesso remoto, occorre chiedersi perché un dispositivo ospite debba avere un accesso amministrativo in uscita. Limiti i servizi non necessari e mantenga le reti degli ospiti separate dai sistemi di gestione. L'amministrazione remota autorizzata deve seguire un percorso definito piuttosto che un'eccezione generalizzata.
I protocolli industriali afferiscono a un contesto differente. Un ospedale o un campus dotato di apparecchiature operative deve mantenere tale ambiente separato dall'accesso visitatori e impiegare un monitoraggio in grado di interpretare il comportamento previsto del protocollo.
La crittografia modifica anche ciò che gli osservatori possono vedere. Con il DNS over HTTPS, le richieste di risoluzione dei nomi viaggiano all'interno di HTTPS, pertanto l'applicazione delle regole del resolver deve considerare le alternative crittografate anziché solo il traffico DNS convenzionale.
L'errore comune consiste nel considerare un protocollo consentito come uno scopo affidabile. Una porta familiare o una connessione crittografata non confermano che la destinazione sia sicura.
Perché gli attaccanti si affidano al DNS e ai domini rotanti
Una destinazione statica offre ai difensori un elemento stabile da bloccare. Gli aggressori possono rendere più difficile l'interruzione modificando i nomi che il malware tenta di raggiungere.
Un algoritmo di generazione dei domini, o DGA, calcola i nomi candidati a partire da un seme (seed), che può dipendere dall'ora. In un ipotetico esempio con seme giornaliero, il malware genera un nuovo set di nomi ogni giorno, mentre l'aggressore registra un nome corrispondente. È possibile che l'elenco di blocco di ieri non contenga la destinazione di oggi.
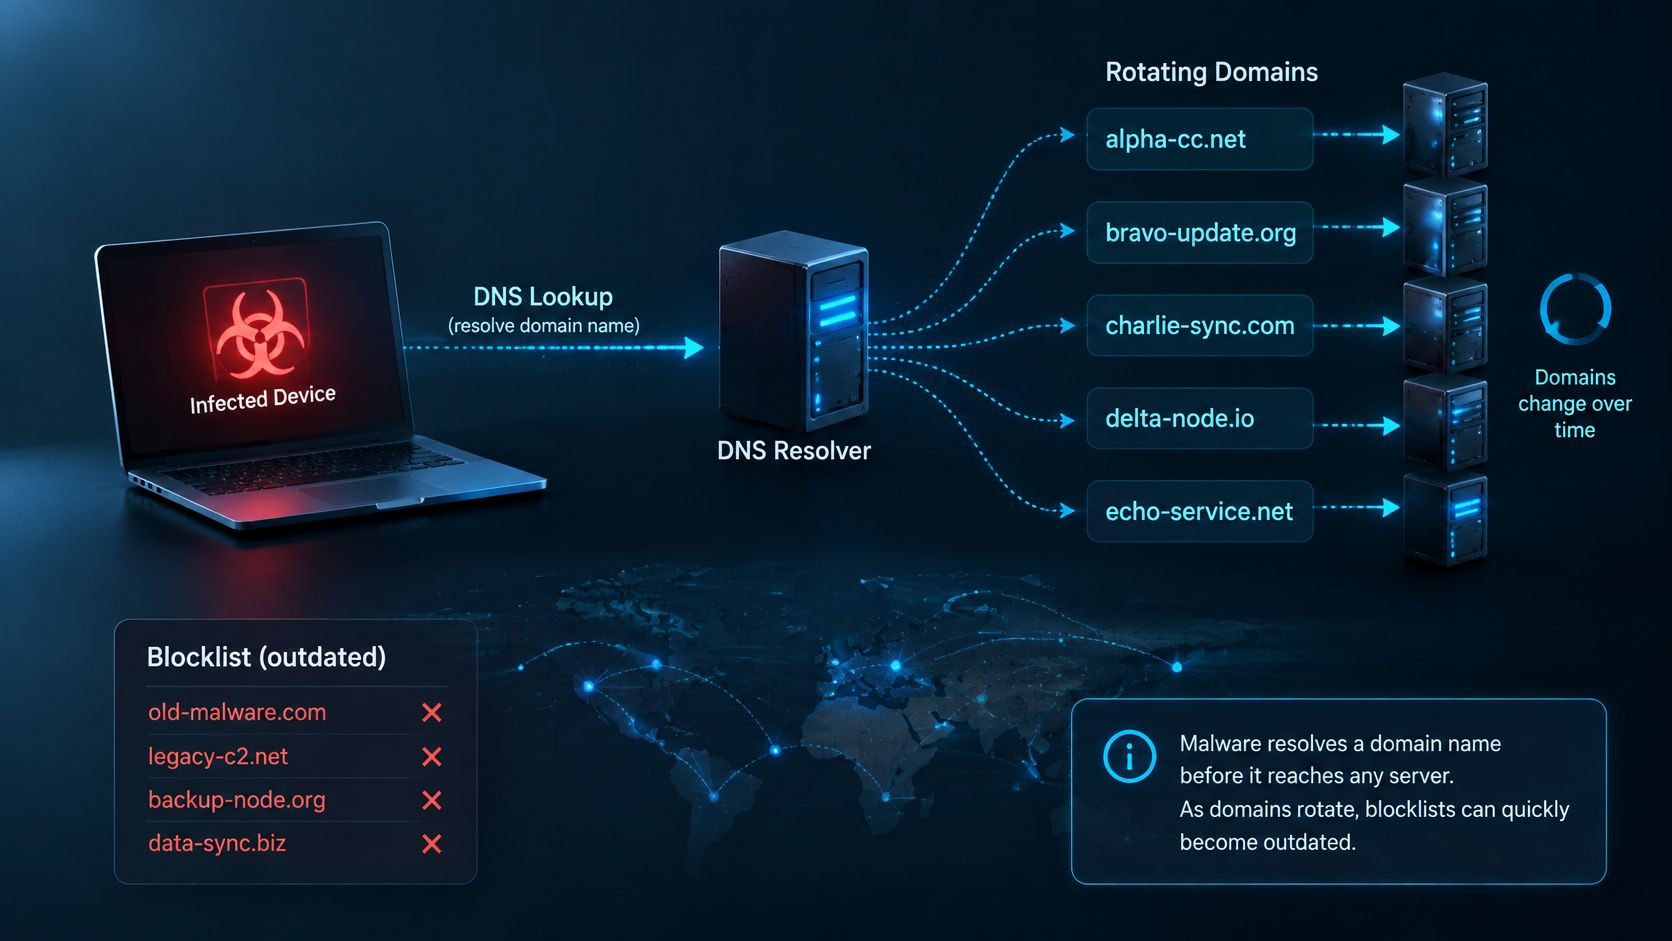
Gli aggressori possono anche ricavare indirizzi o porte di destinazione dalle risposte DNS, oppure alterare i record tramite infrastrutture DNS terze compromesse. La guida alla sicurezza DNS della CISA descrive i servizi di sicurezza DNS come capaci di analizzare le query e intraprendere azioni di mitigazione contro malware, ransomware, phishing, virus, siti malevoli e spyware.
Intervenire prima di accettare la destinazione
Quando un resolver di protezione individua un nome malevolo, può negare la risposta utilizzabile. Per una connessione dipendente da tale risposta, il backend dinamico dell'attaccante non diventerà mai la destinazione successiva del dispositivo.
Questo non inserisce il DNS in tutti i possibili percorsi di callback. Le risposte in cache, gli indirizzi hardcoded e i percorsi di risoluzione alternativi richiedono altri controlli. Tuttavia, laddove sia necessaria una nuova ricerca, verificare il nome è più pratico che inseguire individualmente ciascun indirizzo del server soggetto a modifiche.
Segnali DNS che indicano un callback
Questi modelli DNS aiutano a dare priorità all'indagine, ma ciascuno è un indizio, non una prova di infezione.
Segnali DNS, cosa suggeriscono e come rispondere
| Segnale | Cosa suggerisce | Risposta |
|---|---|---|
| Nomi di dominio ad alta entropia dall'aspetto casuale | Possibile dominio C2 generato algoritmicamente | Bloccare un dominio valutato come malevolo e verificare il dispositivo di origine |
| Ricerche ripetute verso un unico nome a intervalli regolari | Possibili check-in di beaconing verso un controller | Generare un avviso e identificare il segmento di rete |
| TTL molto breve sulle risposte | Possibile rotazione dell'infrastruttura per eludere le blacklist | Correlare con altri segnali prima di agire |
| Traffico di query o risposte con elevata presenza di record TXT | Comandi o dati possibilmente codificati nel DNS | Verificare l'eventuale presenza di tunneling e bloccare la destinazione malevola |
| Ricerche non riuscite ripetute verso un unico nome | Possibili reinterrogazioni verso un dominio inattivo o sottoposto a sinkholing | Verificare il dispositivo e cercare domini di fallback |
Un'entropia elevata indica che un nome appare insolitamente imprevedibile. Anche i servizi legittimi utilizzano nomi generati automaticamente, pertanto l'aspetto da solo non costituisce una regola di blocco solida.
Un Time to Live (TTL) breve indica a un resolver di non conservare una risposta a lungo. Questo può supportare rapidi cambiamenti di infrastruttura, ma anche i servizi legittimi utilizzano risposte a breve durata. Allo stesso modo, i record TXT hanno scopi legittimi, anche se gli attaccanti possono abusarne per veicolare contenuti codificati.
Combinare le evidenze prima di escalation
Un dominio dall'aspetto casuale diventa più preoccupante quando la stessa sorgente lo richiede a intervalli regolari, riceve risposte a breve durata e quindi prova nomi correlati a seguito di errori. Questa combinazione è più utile rispetto al trattare ogni query insolita come un'emergenza separata.
I feed di Threat Intelligence possono fornire ulteriore contesto sulla destinazione. È opportuno utilizzare tale contesto insieme alla cronologia delle query, alle decisioni di policy e all'attribuzione di rete, senza sostituire questi elementi.
Regola pratica: registrare ciò che la rete ha rilevato separatamente da ciò che l'analista sospetta.
Ad esempio, un registro può attestare che una sorgente ha richiesto un dominio bloccato. Non attesta tuttavia che il dispositivo abbia eseguito il comando di un malintenzionato o che i dati abbiano lasciato la rete.
Il WiFi per ospiti WiFi rende l'attribuzione particolarmente importante. Le linee guida per l'implementazione delle reti ospiti di CISA richiedono che le richieste DNS degli ospiti passino attraverso il Protective DNS e che il traffico degli ospiti sia segmentato ed etichettato, in modo che gli eventi anomali possano essere analizzati in base al gruppo di origine.
Conservi il timestamp, le informazioni sulla sorgente richiedente, SSID o VLAN, il nome interrogato e l'esito della policy. Limiti l'accesso e la conservazione in conformità ai requisiti di riservatezza della Sua organizzazione. Può coordinare una risposta senza ispezionare i file personali di un visitatore né raccogliere dettagli identificativi non necessari.
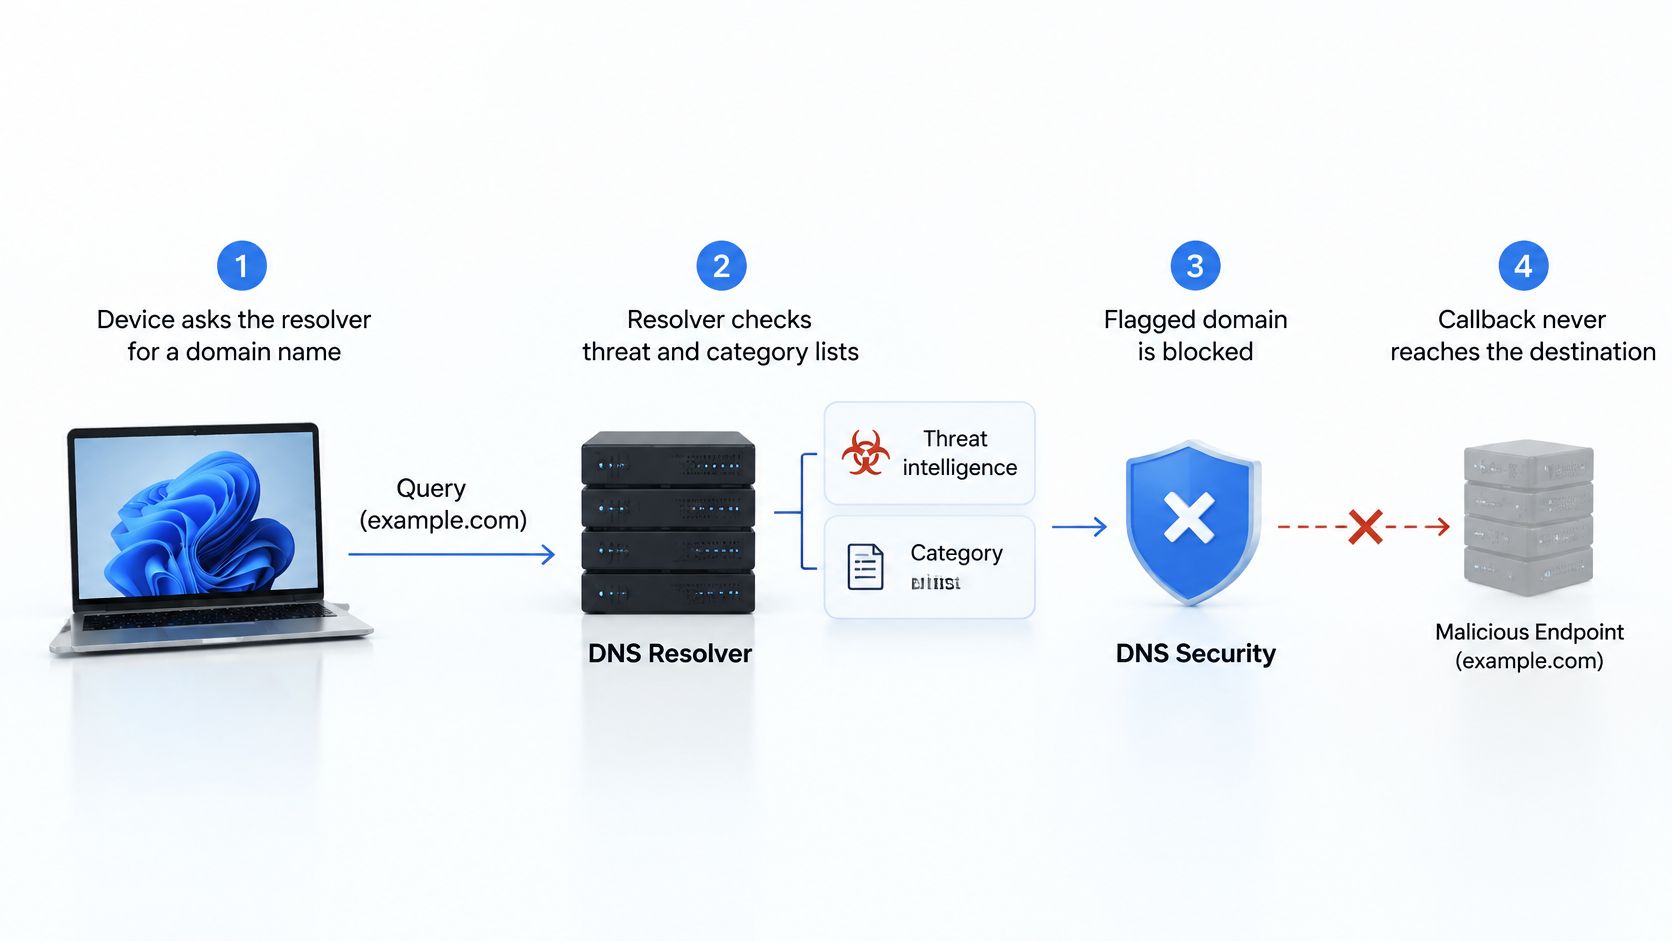
Come le difese a livello DNS bloccano un callback
- Il dispositivo richiede un nome. La relativa query raggiunge il resolver approvato.
- Il resolver verifica i criteri. L'intelligence sulle minacce e le regole di categoria determinano se la destinazione è consentita.
- Una destinazione malevola viene bloccata. Il resolver restituisce una risposta di blocco anziché l'indirizzo di destinazione utilizzabile.
- La decisione viene registrata. I log conservano l'ora e il contesto di origine, con l'attribuzione SSID o VLAN fornita dall'integrazione di rete.
Il diagramma mostra tale decisione prima della connessione alla destinazione.
Rendere valida la policy sulla rete WiFi per ospiti WiFi
Configurare le reti per ospiti in modo da utilizzare il resolver approvato e limitare i percorsi di risoluzione non autorizzati. Pianificare il comportamento fail-closed in modo che un'interruzione del servizio di policy non consenta richieste non verificate senza rilevamento, e testare le conseguenze sulla disponibilità prima della distribuzione.
Un DNS sinkhole costituisce un ulteriore approccio di risposta, reindirizzando una ricerca malevola verso una destinazione controllata. I log devono distinguere il reindirizzamento dal rifiuto o da un'altra risposta di blocco.
Il video fornisce una spiegazione aggiuntiva dell'approccio alla protezione DNS.
Il filtraggio DNS non bonifica il dispositivo. Gli indirizzi hardcoded aggirano la risoluzione dei nomi e le sessioni già stabilite potrebbero proseguire; pertanto, è necessario affiancare alla protezione DNS la segmentazione e le regole per le connessioni in uscita.
L'arresto di una ricerca richiesta blocca le istruzioni attraverso quel percorso, ma non rimuove l'infezione.
Verificare il blocco dei callback prima di un incidente
Utilizzi questa checklist con il proprio team di rete o ICT questa settimana:
- Confermare l'applicazione del resolver. Verificare separatamente gli SSID per ospiti, personale e studenti. Verificare dove vengono indirizzate le richieste, anziché affidarsi esclusivamente alla configurazione prevista.
- Testare i risultati consentiti e quelli bloccati. Da ciascun SSID, provare a raggiungere una destinazione nota come sicura e il dominio di test innocuo designato dal servizio di filtraggio. Non utilizzare infrastrutture malware attive.
- Verificare il comportamento in caso di guasto. In una finestra di manutenzione approvata, testare cosa accade quando il servizio di policy non è disponibile. Confermare che la rete applichi la politica di fail-closed prevista e che il team riceva un avviso da cui poter agire.
- Ispezionare l'attribuzione. Assicurarsi che i record degli eventi bloccati contengano l'elemento SSID, l'elemento VLAN e l'ora, direttamente o tramite una correlazione affidabile. Verificare che un analista possa recuperare le evidenze rilevanti.
- Assegnare la responsabilità di escalation. Concordare chi esamina un avviso, chi può limitare un dispositivo di origine e chi comunica con la sede, l'ospite o il proprietario del dispositivo.
Sperimentare le modifiche senza interrompere le attività operative
Un test riuscito richiede molto di più di una pagina di blocco visibile. Conservi il risultato previsto, il risultato osservato e la relativa voce di registro in modo che un'altra persona possa verificare quanto accaduto.
Includere le normali attività degli ospiti nella fase pilota. Verificare che la navigazione legittima e i servizi essenziali della struttura rimangano fruibili e documentare la procedura che lo staff deve seguire in caso di blocco errato. Una politica definita con precisione è più facile da gestire rispetto a un'interruzione non motivata.
Per i clienti che gestiscono il controllo delle modifiche, pianifichiamo una fase pilota su un SSID insieme al Suo team o al Suo fornitore ICT, prima di applicare modifiche su più ampia scala. In questo modo si forniscono ai responsabili dell'approvazione un perimetro definito e dati concreti da valutare.
La decisione è semplice: la Sua rete attuale è in grado di dimostrare che cosa ha bloccato, dove è successo e chi dovrebbe intervenire? In caso contrario, è consigliabile iniziare con l'applicazione delle regole del resolver e l'attribuzione della sorgente su un WiFi per ospiti SSID pilota, per poi espandere il servizio solo dopo che i test avranno fornito risultati affidabili.
Purple Shield blocca le callback di comando e controllo e i domini noti di phishing e malware al momento della risoluzione DNS, in modo che la connessione corrispondente non si avvii mai. Visiti il sito Purple Shield per discutere della protezione del Suo WiFi per ospiti WiFi e per pianificare un progetto pilota con il Suo team o fornitore ICT.