
O que é comando e controlo? C2 explicado com defesa de DNS
O que é comando e controlo? Saiba como funciona o C2, como os atacantes o utilizam e como as defesas ao nível do DNS bloqueiam as chamadas de retorno antes que estas se conetem.
Published 7 de novembro de 2026
O comando e controlo (C2) é a fase de um ciberataque na qual o atacante comunica com os sistemas comprometidos e os orienta.
Está a gerir WiFi num hotel, campus ou hospital. Um visitante liga um computador portátil, aceita os termos de acesso e começa a navegar. O que não consegue ver é se esse portátil já chegou infetado ou se o software em execução em segundo plano está a tentar contactar um atacante.
O dispositivo não lhe pertence e não pode presumir que exista um agente de segurança instalado. No entanto, controla a forma como ele utiliza a sua rede. Para retornos de chamada (callbacks) que dependem de um nome de domínio, a pesquisa de DNS oferece uma oportunidade inicial para verificar o destino antes de permitir uma ligação.
Índice
- O Que Significa Comando e Controlo em Termos Simples
- Como Funciona um Canal C2: Da Infeção ao Comando
- Canais C2 Comuns e Como Cada Um se Camufla
- Por Que Razão os Atacantes Recorrem ao DNS e a Domínios Rotativos
- Sinais de DNS Que Apontam Para um Callback
- Como as Defesas ao Nível do DNS Bloqueiam um Callback
- Verifique o Seu Bloqueio de Callbacks Antes de um Incidente
O que significa comando e controlo em termos simples
Pense num portátil infetado como um carro roubado escondido numa garagem. O roubo inicial já aconteceu. O C2 é o controlo remoto que o ladrão guarda, permitindo-lhe ligar o motor, alterar a rota e enviar instruções a partir de outro local.
A distinção é importante porque aceder a um dispositivo e controlá-lo posteriormente são atividades diferentes.
O comando e controlo (C2) é a fase de um ciberataque na qual o atacante comunica com os sistemas comprometidos e os orienta.
O phishing, um serviço explorado ou credenciais roubadas podem fornecer o ponto de entrada. O C2 fornece o caminho de comunicação contínuo. O MITRE ATT&CK trata isto como uma tática de adversário distinta e documenta 18 técnicas de C2 empresarial, cobrindo a comunicação com sistemas sob o controlo de um atacante dentro da rede da vítima.
Essa comunicação não tem de envolver um servidor de malware óbvio. Os atacantes podem disfarçar instruções como tráfego normal, codificar mensagens ou estabelecer rotas alternativas.
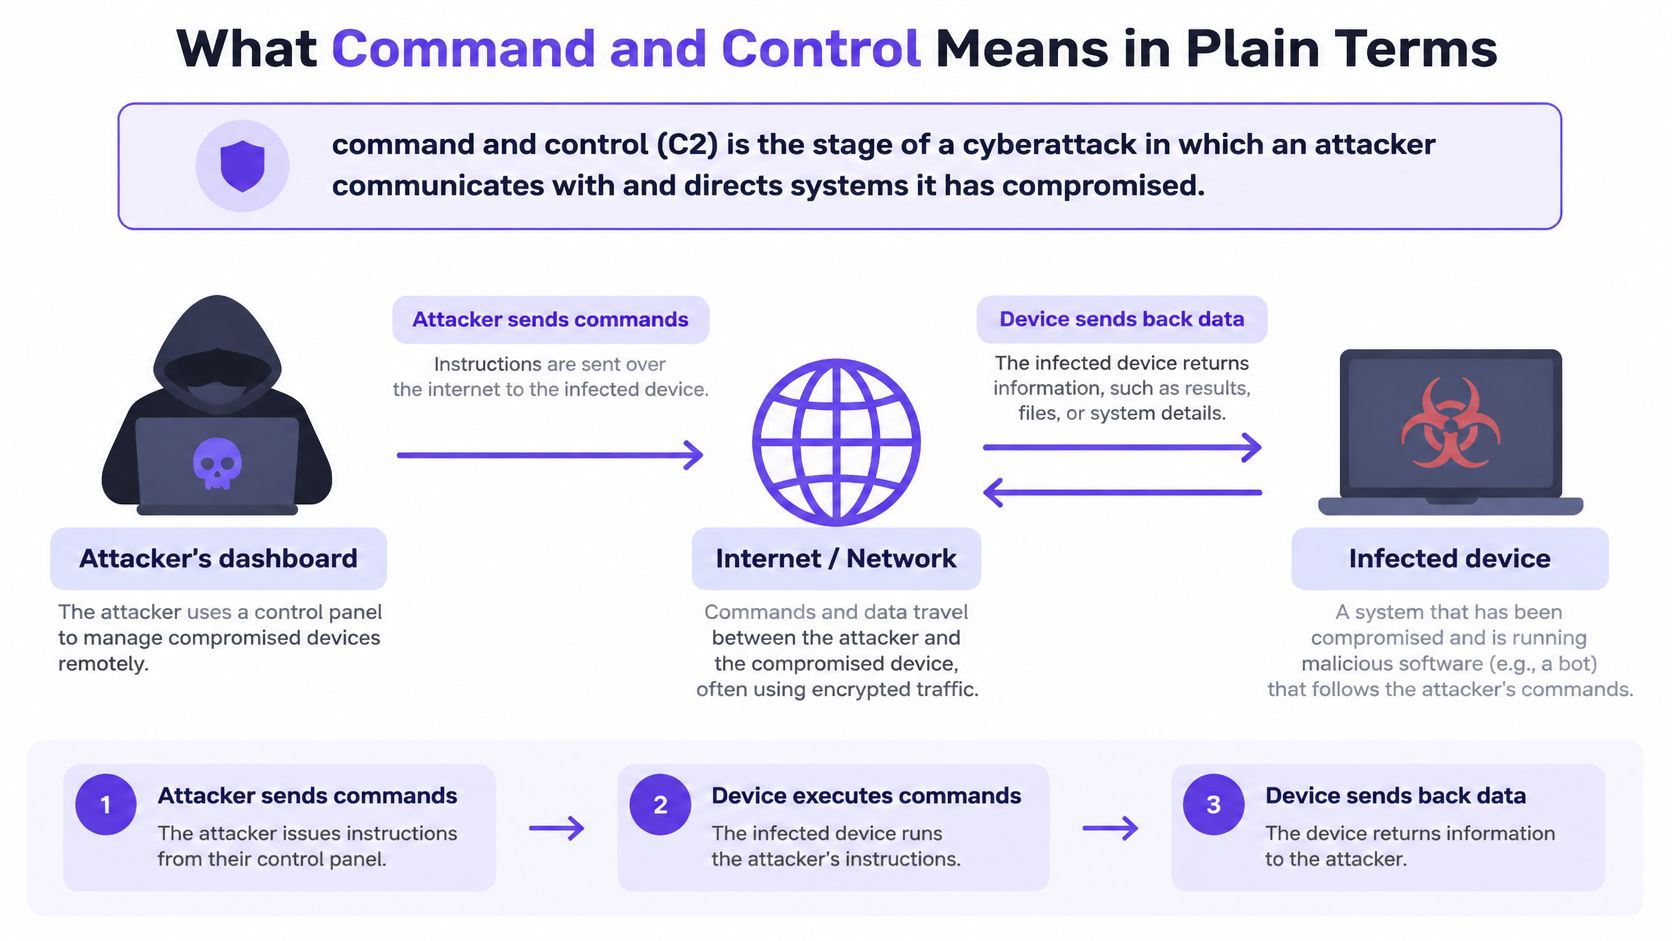
O que o controlo contínuo permite a um atacante fazer
Assim que exista um canal funcional, o atacante pode direcionar o sistema comprometido para:
- Executar comandos: Executar tarefas utilizando o acesso disponível para o software infetado.
- Transferir ferramentas: Adicionar capacidades para além das existentes na infeção original.
- Mover-se lateralmente: Tentar alcançar outros sistemas na rede.
- Roubar informação: Enviar ficheiros acessíveis ou resultados recolhidos para o exterior.
- Manter a persistência: Preservar o acesso para que a atividade possa continuar mais tarde.
Estas são ações possíveis, não um resultado automático de todas as infeções. As permissões, a segmentação e outros controlos de segurança continuam a limitar o que o atacante pode alcançar.
Da mesma forma, eliminar a transferência maliciosa original não é prova de que o controlo tenha terminado. Outro componente ou rota de comunicação pode permanecer ativo. Os encarregados da defesa precisam de determinar tanto o que está em execução como se as comunicações não autorizadas ainda funcionam.
Para um operador que pergunte o que é comando e controlo em termos práticos, a resposta é a direção remota após o comprometimento. Numa WiFi partilhada, isso altera a questão defensiva: não se trata apenas de saber se um dispositivo está infetado, mas se a sua rede permitirá que este alcance o seu controlador.
Como funciona um canal C2 desde a infeção até ao comando
Considere o portátil de um visitante que foi infetado antes de chegar ao seu local. O acesso ao seu WiFi não causa a infeção, mas pode fornecer ao software malicioso uma nova rota para a internet.
A seguinte sequência separa a intenção do software em fazer a verificação da atividade de rede necessária para concluir essa verificação.
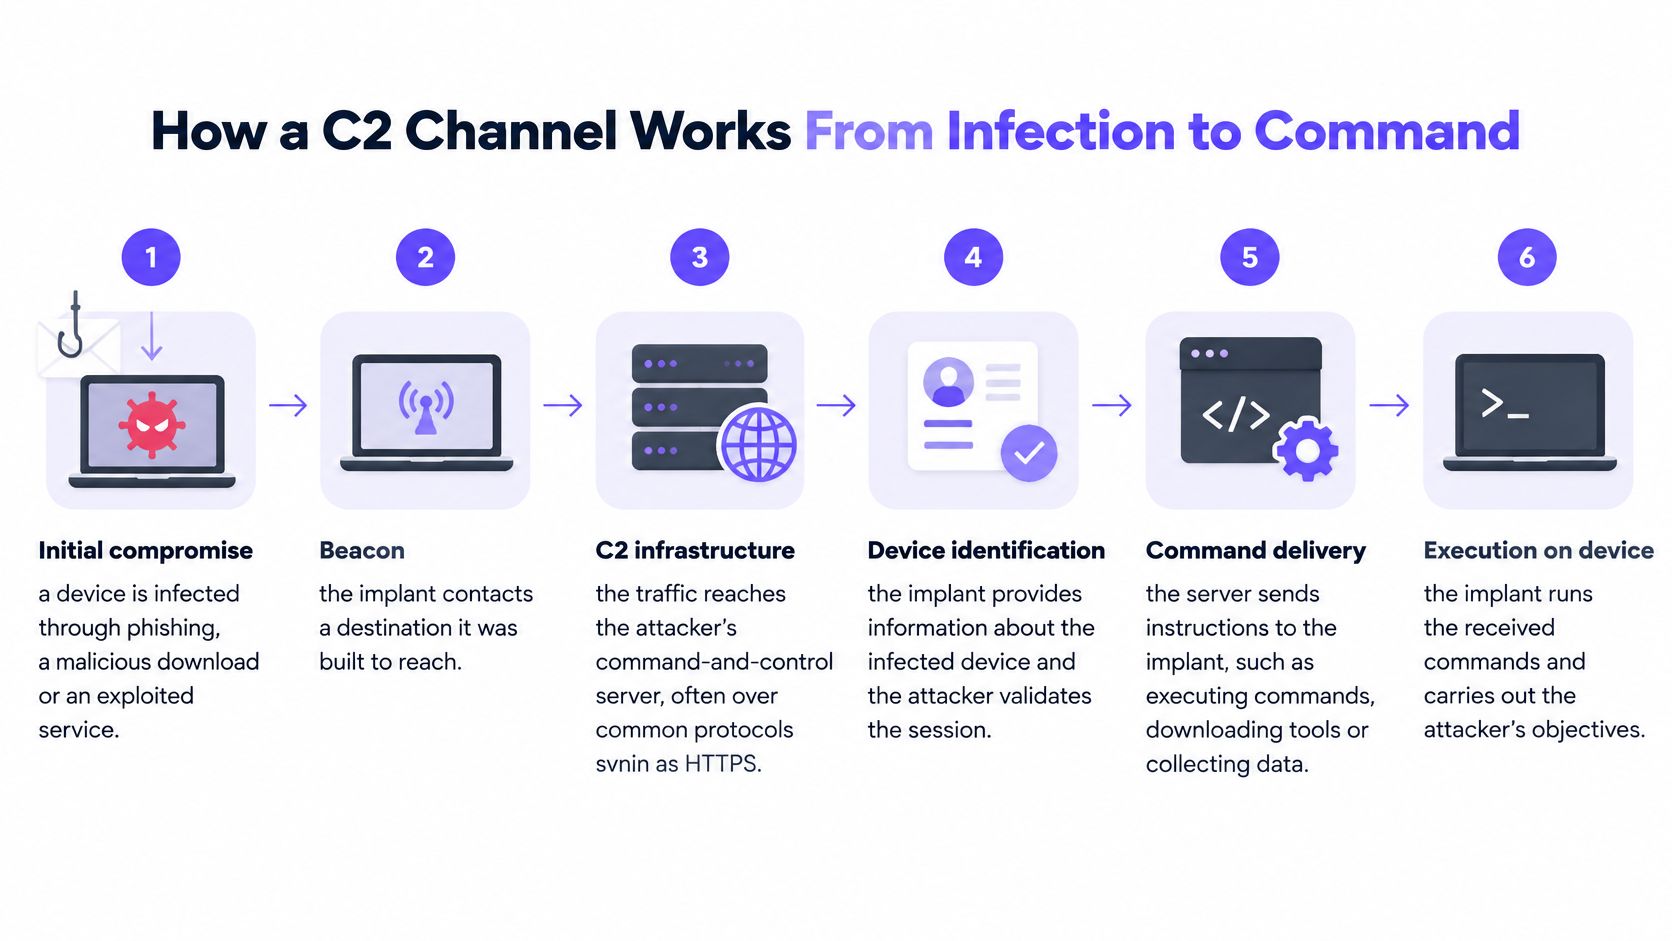
Comprometimento inicial. Um anexo de phishing, uma transferência maliciosa ou um serviço explorado introduz um implante, ou seja, o software executado no dispositivo comprometido. Os defensores devem distinguir o ponto de entrada original da atividade de rede subsequente, uma vez que bloquear um não resolve necessariamente o outro.
Preparação do beacon. O implante prepara um check-in, frequentemente chamado beacon, para anunciar que está disponível e solicitar tarefas. Um temporizador pode acionar esta atividade sem que o utilizador abra qualquer ficheiro ou aplicação, pelo que a atividade do navegador, por si só, não explicará todas as ligações.
Resolução de nomes. Se o destino utilizar um domínio e não houver um endereço utilizável disponível, o dispositivo solicita ao DNS a tradução desse nome num endereço. Este é um ponto de decisão inicial e simples no qual os defensores podem avaliar o destino antes do início da ligação ao servidor correspondente.
Entrega de comandos. Se a comunicação for bem-sucedida, o controlador pode devolver instruções, tais como transferir outra ferramenta ou recolher ficheiros. Os defensores têm agora de considerar o conteúdo e as consequências da troca de dados, e não apenas o seu destino.
Execução e acesso contínuo. O implante realiza a tarefa e pode devolver resultados ou tentar uma rota alternativa se a comunicação falhar. Assim, uma investigação precisa de procurar atividades de seguimento, em vez de tratar uma única tentativa bloqueada como o fim do incidente.
Interprete o padrão, não apenas o pedido
Uma pequena pesquisa repetida com um agendamento regular para um domínio desconhecido merece ser investigada. Um pedido ocasional a um serviço conhecido pode ser rotineiro, mas nem o tempo nem a familiaridade resolvem a questão por si só. O software de atualização legítimo também estabelece ligação automaticamente.
Para um contexto mais amplo, o relatório da Statlyst sobre tendências de malware em números fornece contexto sobre a atividade de malware. Operacionalmente, contudo, a sua decisão deve basear-se no destino, no contexto de rede do dispositivo requerente e nos eventos circundantes.
Não tem de encontrar o ficheiro malicioso antes de interromper a sua seguinte verificação dependente do domínio. Trata-se de um isolamento útil, mesmo enquanto outra pessoa trata da remediação do dispositivo.
Canais C2 comuns e como cada um se camufla
Diferentes canais de C2 assemelham-se a diferentes tipos de atividade legítima, pelo que os defensores precisam de controlos adequados a cada um deles.
Canais de C2, como se disfarçam e onde os detetar
| Canal | Por que motivo se dissimula | Onde os defensores o detetam |
|---|---|---|
| HTTP e HTTPS | O tráfego assemelha-se à navegação web de rotina | Filtragem compatível com TLS e verificações de reputação nos destinos |
| DNS | Resoluções de nomes que quase todas as redes têm de permitir | Resolutor com categorias de ameaças e registo de consultas |
| Mensagens de e para servidores de correio esperadas pelos utilizadores | Verificação de hiperligações e anexos no gateway de correio | |
| Acesso remoto (RDP, telnet) | Assemelha-se a sessões de administrador | Segmentar redes de visitantes e bloquear portas de administração de saída |
| Protocolos industriais (DNP3, Modbus) | Tráfego esperado dentro de redes operacionais | Monitorização compatível com os protocolos e segmentação de OT |
HTTP e HTTPS funcionam como um disfarce útil porque as aplicações enviam constantemente pedidos web. Um pequeno callback encriptado pode assemelhar-se a uma chamada de aplicação comum. A reputação do destino ajuda, enquanto os controlos com suporte a TLS exigem uma implementação cuidadosa, particularmente onde a inspeção do tráfego encriptado de visitantes criaria problemas operacionais e de privacidade.
O DNS tem uma vantagem diferente: os dispositivos precisam de resolução de nomes para os serviços normais. A estrutura ATT&CK da MITRE para Sistemas de Controlo Industrial regista o DNS como um mecanismo normal de C2 ao nível da camada de aplicação, incluindo a ocultação de dados em campos de DNS e a utilização de tunelamento de DNS. Aqui, o DNS não serve apenas para localizar um controlador; as próprias consultas e respostas podem transportar mensagens.
Ajuste o controlo ao canal correspondente
O e-mail pode transportar instruções através da infraestrutura de correio esperada. As verificações da gateway em ligações e anexos são úteis, mas não substituem a monitorização do caminho de comunicação mais amplo.
Para protocolos de acesso remoto, pergunte-se por que razão um dispositivo de visitante precisa, de todo, de acesso administrativo de saída. Restrinja serviços desnecessários e mantenha as redes de visitantes separadas dos sistemas de gestão. A administração remota autorizada deve ter uma rota definida em vez de uma exceção geral.
Os protocolos industriais pertencem a um contexto diferente. Um hospital ou campus com equipamento operacional deve manter esse ambiente separado do acesso de visitantes e utilizar uma monitorização que compreenda o comportamento esperado do protocolo.
A encriptação também altera o que os observadores conseguem ver. Com o DNS over HTTPS, os pedidos de resolução de nomes viajam dentro de HTTPS, pelo que a aplicação de regras pelo resolvedor precisa de ter em conta alternativas encriptadas, em vez de apenas o tráfego DNS convencional.
O erro comum consiste em tratar um protocolo permitido como uma finalidade de confiança. Uma porta familiar ou uma ligação encriptada não provam que o destino seja seguro.
Por que razão os atacantes se apoiam no DNS e em domínios rotativos
Um destino estático fornece aos defensores algo estável para bloquear. Os atacantes podem dificultar a interrupção alterando os nomes que o malware tenta alcançar.
Um algoritmo de geração de domínios, ou DGA, calcula nomes candidatos a partir de uma semente, que pode depender do tempo. Num exemplo hipotético de semente diária, o malware gera um conjunto novo de nomes todos os dias, enquanto o atacante regista um nome correspondente. A lista de bloqueio de ontem pode não conter o destino de hoje.
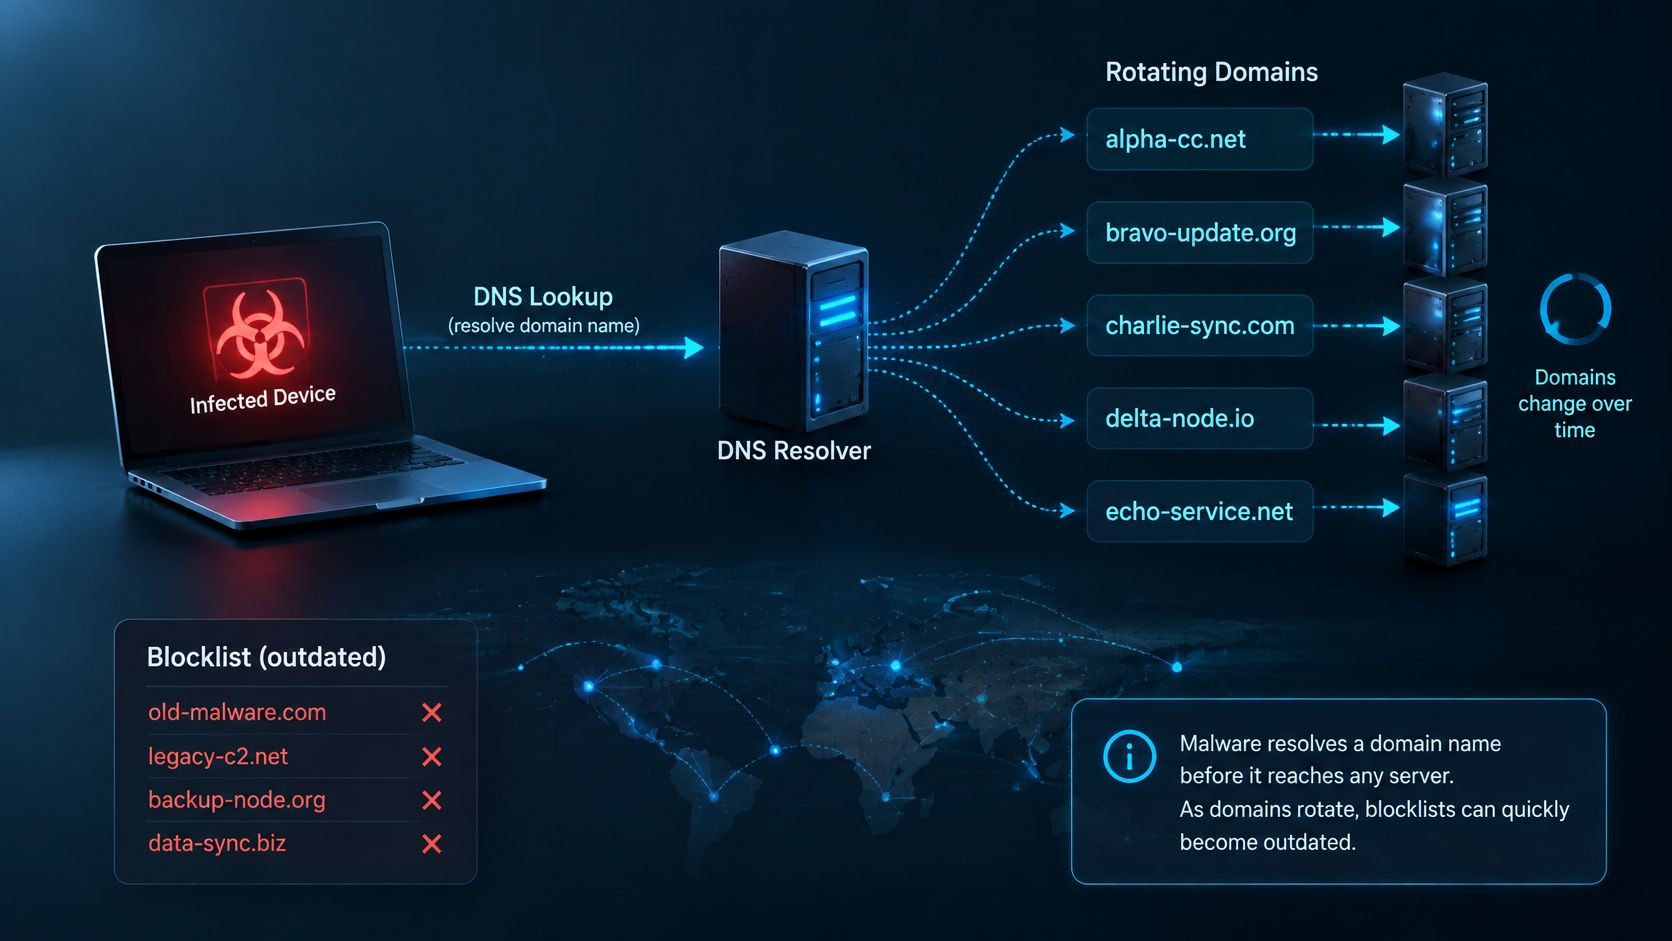
Os atacantes também podem obter endereços ou portas de destino a partir de respostas DNS, ou alterar registos através de infraestruturas DNS de terceiros comprometidas. As orientações de segurança DNS da CISA descrevem os serviços de segurança DNS como a capacidade de analisar consultas e tomar medidas de mitigação contra malware, ransomware, phishing, vírus, sites maliciosos e spyware.
Intervenha antes de aceitar o destino
Quando um resolvedor de proteção reconhece um nome malicioso, pode reter a resposta utilizável. Para uma ligação dependente dessa resposta, a infraestrutura em constante alteração do atacante nunca se torna o destino seguinte do dispositivo.
Isso não coloca o DNS em todos os caminhos de callback possíveis. Respostas em cache, endereços integrados no código (hard-coded) e rotas de resolução alternativas exigem outros controlos. No entanto, onde uma nova pesquisa for necessária, verificar o nome é mais prático do que perseguir individualmente cada endereço de servidor em mudança.
Sinais de DNS que indiciam uma chamada de retorno
Estes padrões de DNS ajudam a priorizar a investigação, mas cada um é uma pista, não uma prova de infeção.
Sinais de DNS, o que sugerem e como responder
| Sinal | O que sugere | Resposta |
|---|---|---|
| Nomes de domínio com aspeto aleatório e alta entropia | Possível domínio de C2 gerado por algoritmo | Bloquear um domínio avaliado como malicioso e rever o dispositivo de origem |
| Consultas repetidas para um nome a intervalos regulares | Possíveis check-ins de beaconing para um controlador | Alertar e identificar o segmento de rede |
| TTL muito curto nas respostas | Possível rotação de infraestrutura para escapar a listas de bloqueio | Correlacionar com outros sinais antes de agir |
| Tráfego de consultas ou respostas com elevado volume de TXT | Comandos ou dados possivelmente codificados em DNS | Investigar quanto a tunelamento e bloquear um destino malicioso |
| Consultas com falhas repetidas para um nome | Possíveis novas tentativas contra um domínio inativo ou redirecionado (sinkholed) | Verificar o dispositivo e procurar domínios alternativos de recurso |
Uma elevada entropia significa que um nome parece invulgarmente imprevisível. Os serviços legítimos também utilizam nomes gerados por computador, pelo que a aparência, por si só, não é uma regra de bloqueio fiável.
Um tempo de vida curto, ou TTL, indica a um resolvedor para não reter uma resposta por muito tempo. Isso pode suportar alterações rápidas na infraestrutura, mas os serviços legítimos também utilizam respostas de curta duração. Da mesma forma, os registos TXT têm fins legítimos, embora os atacantes os possam utilizar indevidamente para transportar conteúdo codificado.
Combine evidências antes de escalar a situação
Um domínio com aspeto aleatório torna-se mais preocupante quando a mesma origem o solicita a intervalos regulares, recebe respostas de curta duração e tenta nomes relacionados após falhas. A combinação é mais útil do que tratar cada consulta invulgar como uma emergência separada.
As fontes de inteligência sobre ameaças podem adicionar contexto de destino. Utilize esse contexto juntamente com o histórico de consultas, decisões de política e atribuição de rede, e não como um substituto para os mesmos.
Regra prática: Registe o que a rede observou separadamente do que o analista suspeita.
Por exemplo, um registo pode comprovar que uma origem solicitou um domínio bloqueado. Não comprova que o dispositivo tenha executado um comando do atacante ou que tenham saído dados da rede.
O WiFi para visitantes WiFi torna a atribuição especialmente importante. As orientações de implementação de redes de visitantes da CISA exigem que os pedidos de DNS de visitantes passem por Protective DNS e que o tráfego de visitantes seja segmentado e rotulado para que os eventos anómalos possam ser triados por grupo de origem.
Conserve o carimbo de data/hora, a informação da fonte requerente, o SSID ou VLAN, o nome consultado e o resultado da política. Limite o acesso e a retenção de acordo com os requisitos de privacidade da sua organização. Pode coordenar uma resposta sem inspecionar os ficheiros pessoais de um visitante ou recolher detalhes de identidade desnecessários.
Como as defesas ao nível do DNS interrompem uma chamada de retorno
- O dispositivo solicita um nome. A sua consulta atinge o resolutor aprovado.
- O resolutor verifica a política. As regras de inteligência sobre ameaças e de categorias determinam se o destino é permitido.
- Um destino malicioso é bloqueado. O resolutor devolve uma resposta de bloqueio em vez do endereço de destino utilizável.
- A decisão é registada. Os registos mantêm a hora e o contexto de origem, com a atribuição de SSID ou VLAN fornecida pela integração de rede.
O diagrama mostra essa decisão antes da ligação de destino.
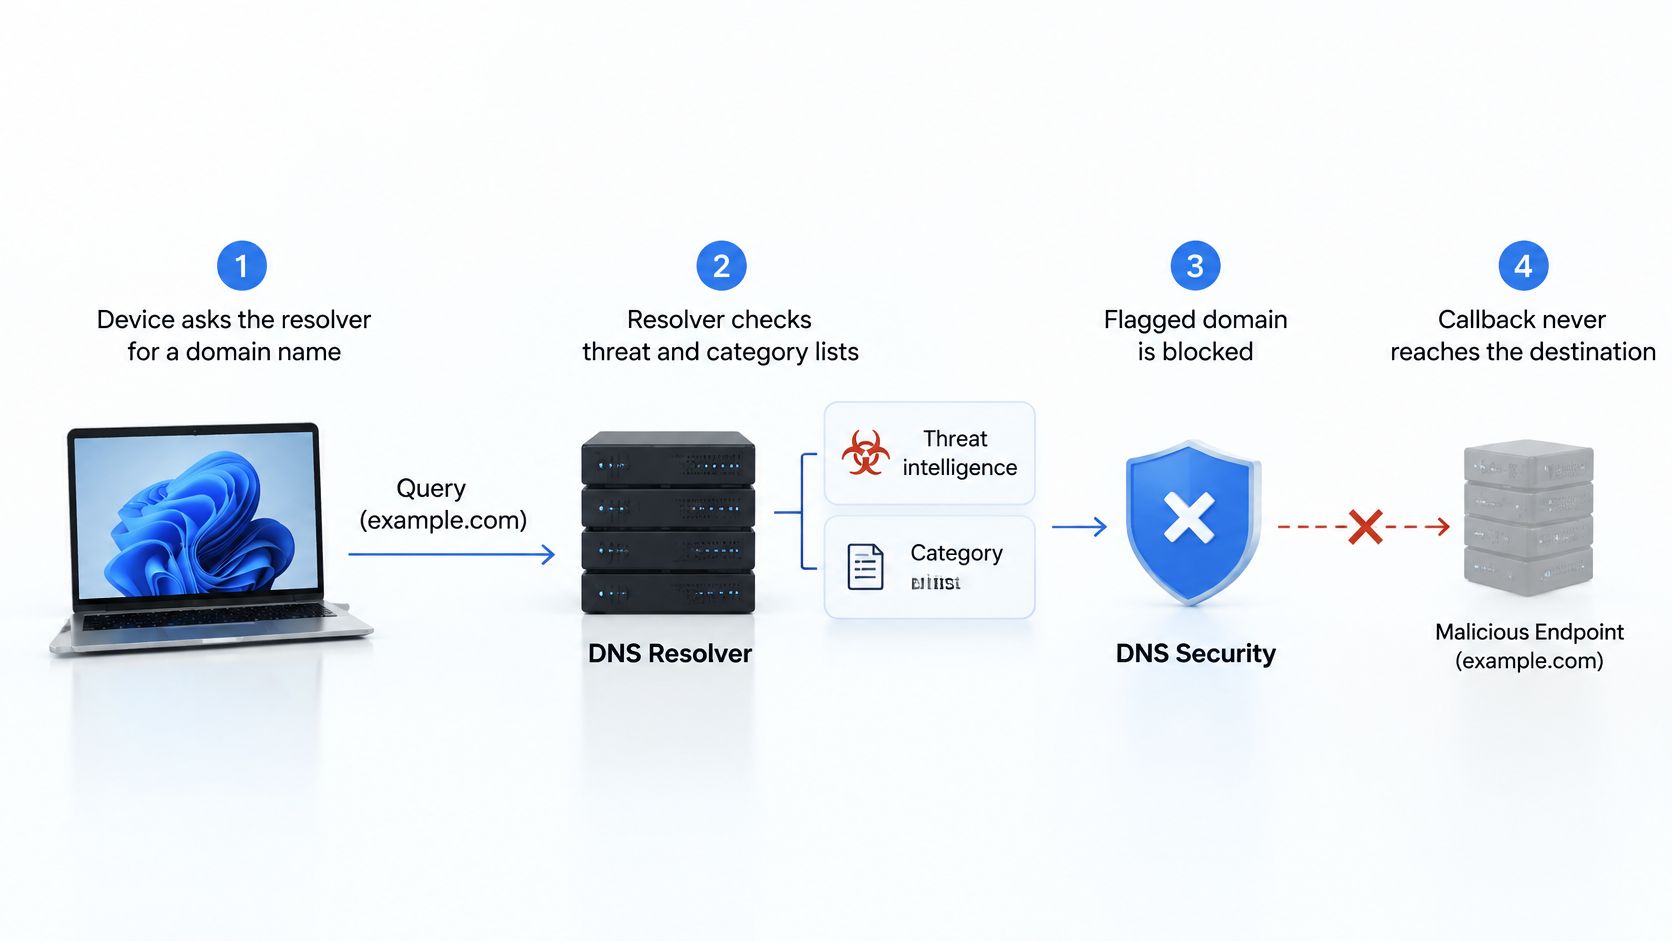
Garanta o cumprimento da política na rede WiFi para visitantes WiFi
Configure as redes de visitantes para utilizarem o resolvedor aprovado e restrinja as rotas de resolução não autorizadas. Planeie o comportamento de falha fechada (fail-closed) para que uma interrupção do serviço de políticas não permita pedidos não verificados sem deteção e teste as consequências na disponibilidade antes da implementação.
Um DNS sinkhole é outra abordagem de resposta, redirecionando uma consulta maliciosa para um destino controlado. Os seus registos devem distinguir o redirecionamento da recusa ou de outra resposta de bloqueio.
O vídeo fornece uma explicação adicional sobre a abordagem de proteção de DNS.
O filtro DNS não limpa o dispositivo. Os endereços codificados de forma rígida contornam a resolução de nomes, e as sessões já estabelecidas podem continuar; assim, combine a proteção DNS com segmentação e regras de ligação de saída.
Interromper uma pesquisa necessária bloqueia as instruções através dessa rota, mas não remove a infeção.
Verifique o bloqueio de chamadas de retorno antes de ocorrer um incidente
Utilize esta lista de verificação com a sua equipa de rede ou TIC esta semana:
- Confirme a aplicação do resolvedor. Verifique separadamente os SSIDs de visitantes, funcionários e estudantes. Confirme para onde vão os seus pedidos, em vez de confiar apenas na configuração pretendida.
- Testes os resultados permitidos e bloqueados. A partir de cada SSID, tente aceder a um destino comprovadamente seguro e ao domínio de teste inofensivo designado pelo serviço de filtragem. Não utilize infraestruturas ativas de malware.
- Testar o comportamento em caso de falha. Numa janela de manutenção aprovada, teste o que acontece quando o serviço de políticas está indisponível. Confirme se a rede segue a política pretendida de falha com bloqueio (fail-closed) e se a equipa recebe um alerta acionável.
- Inspecione a atribuição. Certifique-se de que os registos de eventos bloqueados contêm o SSID, o VLAN e a hora, quer diretamente quer através de uma correlação fiável. Verifique se um analista consegue recuperar as evidências relevantes.
- Atribua a responsabilidade pela escalada. Defina quem analisa um alerta, quem pode restringir um dispositivo de origem e quem comunica com o local, com o visitante ou com o proprietário do dispositivo.
Teste alterações sem perturbar a infraestrutura
Um teste bem-sucedido exige mais do que uma página de bloqueio visível. Preserve o resultado previsto, o resultado observado e a entrada de registo relevante para que outra pessoa possa verificar o sucedido.
Inclua a atividade normal dos visitantes no piloto. Verifique se a navegação legítima e os serviços essenciais do local permanecem utilizáveis e documente como a equipa deve tratar um bloqueio incorreto. É mais fácil dar suporte a uma política de âmbito bem definido do que a uma interrupção sem explicação.
Para clientes que gerem o controlo de alterações, planeamos um piloto num SSID com a sua equipa ou fornecedor de TIC antes que qualquer alteração mais ampla seja efetuada. Isso fornece às pessoas responsáveis pela aprovação um âmbito definido e evidências para rever.
A decisão é simples: a sua rede atual consegue provar o que bloqueou, onde aconteceu e quem deve responder? Se não conseguir, comece pela aplicação de regras no resolvedor e pela atribuição da fonte num SSID piloto, expandindo apenas depois de os testes produzirem resultados fiáveis.
O
Purple Shield bloqueia callbacks de comando e controlo e domínios conhecidos de phishing e malware na consulta DNS, de modo a que a ligação correspondente nunca seja iniciada. Visite Purple Shield para debater a proteção do seu WiFi e planeares um piloto com a sua equipa ou fornecedor de TIC.