
DNS sinkhole spiegato: come blocca i callback malevoli
Un DNS sinkhole reindirizza le ricerche dei malware verso un'esca, bloccando i callback e individuando i dispositivi infetti. Scopra come funziona e dove distribuirlo.
Published 2 novembre 2026
Un ospite connette un laptop alla WiFi della Sua caffetteriaWiFi, apre un browser e prosegue con la sua giornata. In background, un malware presente su quel laptop tenta di contattare il proprio controller. Non è possibile installare un software di sicurezza sul dispositivo di ogni visitatore, ma è possibile controllare il modo in cui la rete risponde alle richieste di destinazioni Internet provenienti da tale dispositivo.
Un DNS sinkhole offre un modo per interrompere tale callback e registrare prove utili all'analisi. La domanda fondamentale non è solo cosa blocca, ma se consente di identificare il dispositivo interessato, dimostrare l'applicabilità della politica e ripristinare l'accesso legittimo quando una regola commette un errore.
Sommario
- Che cos'è un DNS Sinkhole in parole semplici
- In che modo un Sinkhole risponde a una ricerca malevola
- L'epidemia Conficker che ha reso standard i Sinkhole
- Trasformare i contatti Sinkhole in piste per dispositivi infetti
- Modelli di implementazione per reti condivise e WiFi per ospiti
- Falsi positivi e come ripristinare rapidamente il servizio
- Decidere se un Sinkhole è adatto alla propria rete
Che cos'è un DNS sinkhole in termini semplici
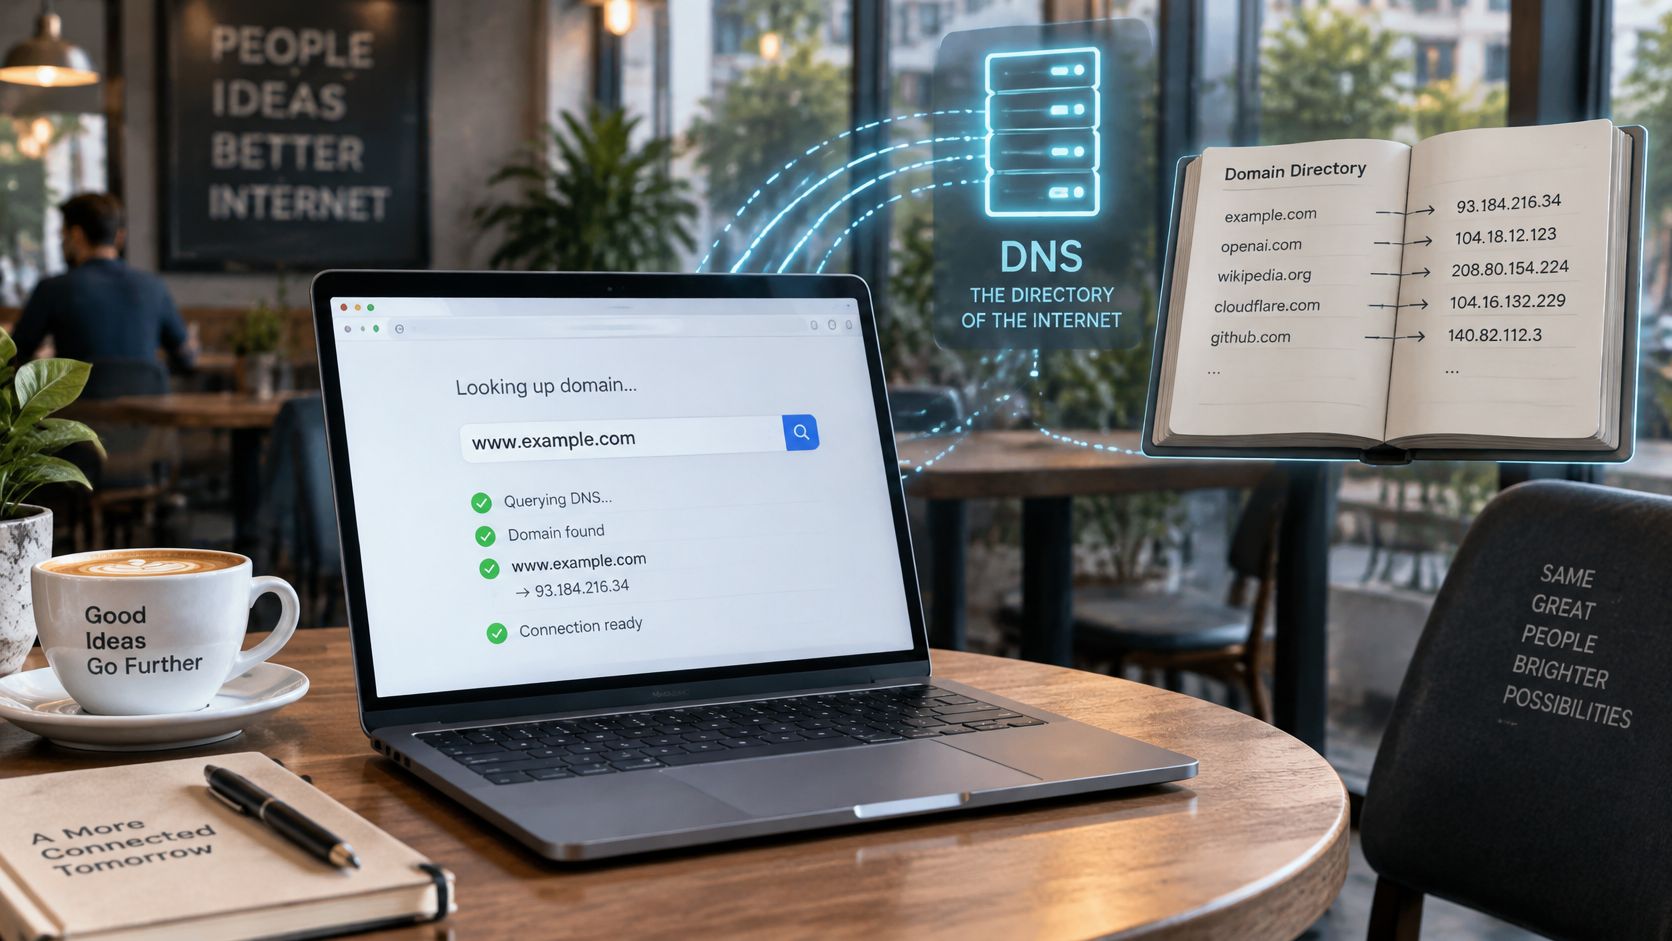
Il laptop infetto deve individuare il proprio controller prima di poter richiedere istruzioni. Se il malware utilizza un nome di dominio, il laptop richiede prima a un resolver DNS di tradurre quel nome in un indirizzo IP.
Si può pensare al DNS come a un elenco telefonico. Il dominio è il nome da cercare e l'indirizzo IP è il numero da chiamare. Un resolver protettivo verifica se è opportuno fornire tale numero.
Un DNS sinkhole sostituisce la risposta per un dominio noto come dannoso con una destinazione controllata, oppure blocca la risposta, in modo che il dispositivo non possa utilizzare quella ricerca per raggiungere l'aggressore.
In senso stretto, sinkholing significa reindirizzare il traffico verso un endpoint controllato. Gli amministratori utilizzano questo termine anche in senso più ampio per indicare le politiche DNS che sopprimono le ricerche dannose senza fornire una destinazione.
L'analogia con la rubrica aiuta a separare la ricerca del nome dalla connessione successiva.
Il blocco del DNS non equivale al blocco dell'IP
Un DNS sinkhole agisce sul nome richiesto prima che il dispositivo utilizzi la risposta per contattare tale destinazione. Una regola di firewall ordinaria valuta i pacchetti, spesso utilizzando il loro indirizzo IP di destinazione, e può rifiutare il tentativo di connessione iniziale. Un firewall non deve attendere che una connessione sia stabilita.
Tale distinzione è importante quando i servizi legittimi e quelli dannosi condividono l'infrastruttura di hosting. Il blocco di un intero indirizzo IP può influire su servizi non correlati, mentre una policy DNS può avere come obiettivo un hostname specifico. Nessuno dei due approcci sostituisce l'altro.
Sulle WiFi condivise, il resolver è utile poiché il gestore non necessita di accesso amministrativo al laptop. Tuttavia, l'interruzione di un callback non rimuove l'infezione; offre al gestore un'opportunità di contenimento e, tramite un tracciamento adeguato, una traccia per l'analisi.
Come un sinkhole risponde a una ricerca malevola
Una ricerca DNS è una richiesta di informazioni, non una connessione al sito web richiesto. La risposta del resolver determina l'operazione successiva che il dispositivo può tentare di eseguire.
Il percorso di base separa il dispositivo, la verifica della politica e la destinazione controllata.
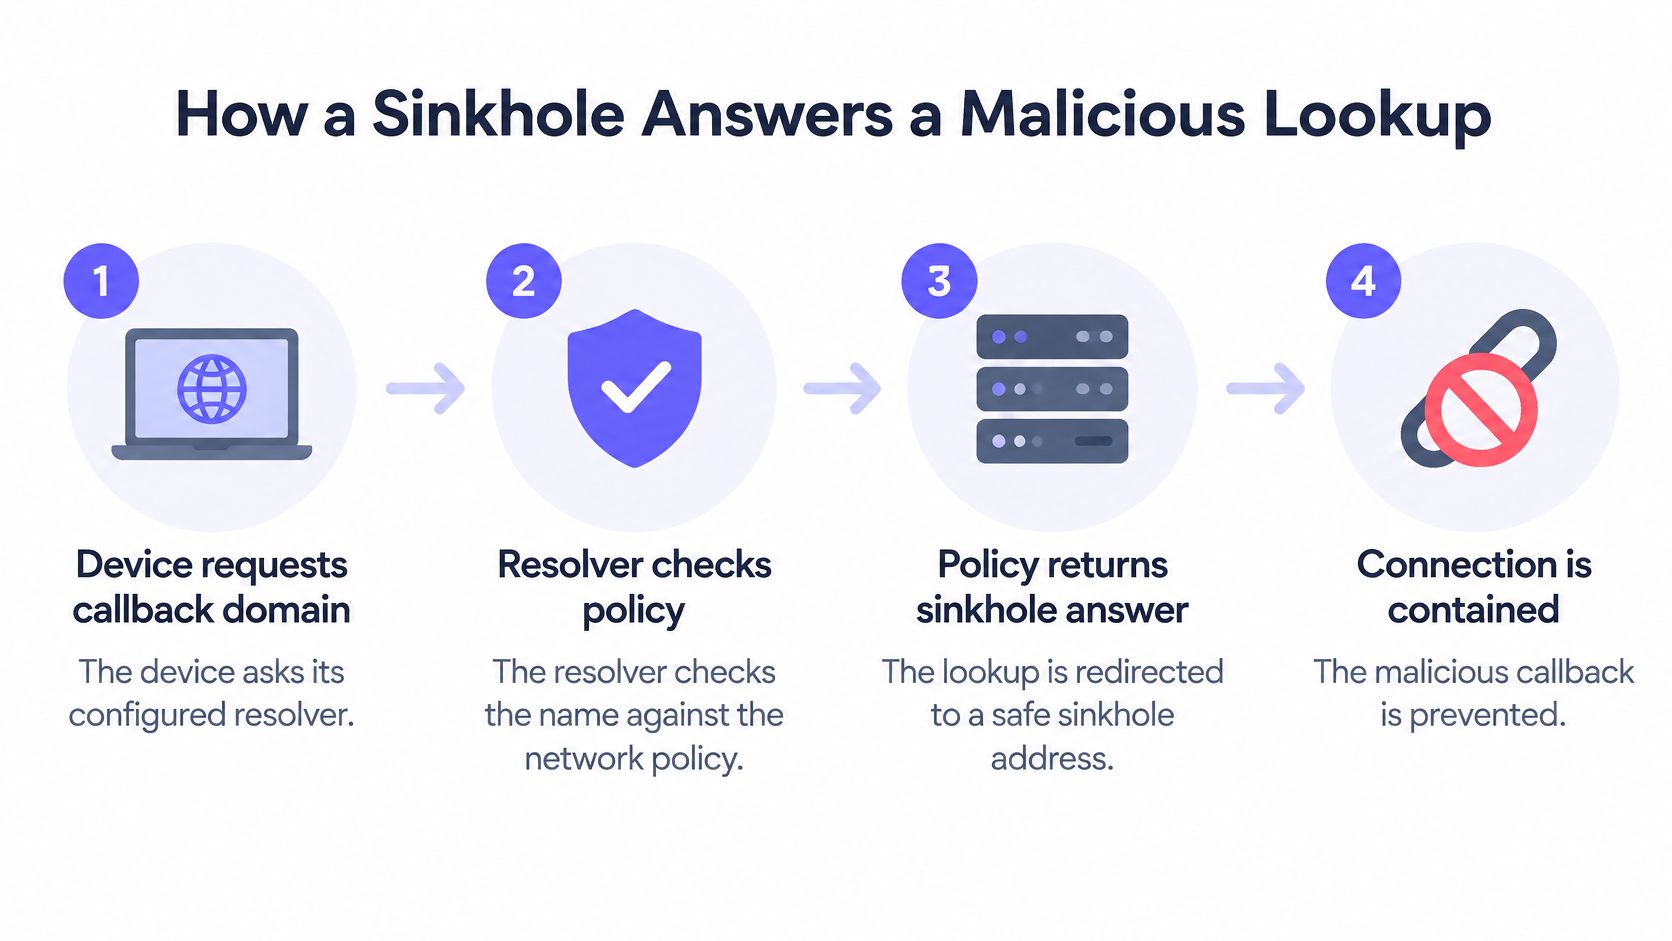
- Il dispositivo richiede il proprio dominio di callback. Invia una query al resolver configurato.
- Il resolver identifica quale policy si applica alla rete di origine, ad esempio un SSID ospiti o un VLAN del personale.
- Il nome viene verificato rispetto all'intelligence sulle minacce e alle regole locali, comprese le categorie di comando e controllo, phishing e malware.
- In caso di corrispondenza con un blocco, il resolver fornisce un indirizzo controllato, restituisce una risposta di nome inesistente, oppure rifiuta o sopprime la risposta.
- Il dispositivo tenta una connessione con il bersaglio civetta oppure non riesce a ottenere una destinazione utilizzabile. I nomi consentiti vengono risolti normalmente.
Prima che un dispositivo apra un sito o un'app, richiede al DNS dove trovarli e Shield risponde applicando la policy per quella rete. Se un dominio è bloccato, la connessione a tale destinazione non viene mai avviata e il dispositivo visualizza invece la pagina di blocco personalizzata del cliente. Tale esperienza lato utente non deve essere confusa con i tentativi di malware di ripetere una callback non riuscita.
Scegliere la risposta in base all'evidenza necessaria
Opzioni di risposta del sinkhole e cosa rivela ciascuna
| Risposta | Cosa rileva il dispositivo | Cosa apprendono i difensori | Compromesso principale |
|---|---|---|---|
| Nome inesistente (NXDOMAIN) | La ricerca fallisce e la connessione non viene mai avviata | Che un tentativo di ricerca è stato effettuato e bloccato | Interrompe il callback ma non fornisce informazioni sul comportamento di connessione successivo |
| Indirizzo sinkhole | La ricerca restituisce l'indirizzo di un server controllato | IP di origine, tempistica del callback, modello di tentativi e protocollo osservabile | Richiede un endpoint monitorato e una gestione attenta dell'archiviazione dei log |
| Risposta rifiutata o soppressa | Il resolver rifiuta la query o la lascia senza risposta | Poco oltre il tentativo stesso, a meno che non sia abilitata la registrazione dei log del resolver | Veloce da applicare, ma alcuni client riprovano in modo aggressivo |
NXDOMAIN non cancella le informazioni sull'origine o sulla marca temporale. Un resolver può registrarle entrambe. Ciò che non può raccogliere da quella ricerca non riuscita è la connessione che il malware avrebbe stabilito successivamente.
Una valutazione della cattura di pacchetti tramite sinkhole sottoposta a revisione paritaria ha riportato un miglioramento di cinque volte nella cattura dei pacchetti dannosi con un'architettura di raccolta avanzata rispetto a un'implementazione convenzionale. Questo costituisce una prova relativa all'architettura di raccolta, non una garanzia che ogni sinkhole offra il medesimo miglioramento.
Questo video offre un altro modo per seguire il meccanismo.
La risposta scelta determina il comportamento successivo che è possibile osservare. Mantenere i collector isolati e non presupporre che il reindirizzamento produca una pagina di avviso chiara per ogni applicazione crittografata.
L'epidemia di Conficker che ha reso lo standard dei sinkhole
Conficker ha mostrato come chi si occupa di difesa possa trasformare la ricerca di istruzioni del malware in una fonte di intelligence. Piuttosto che ispezionare ogni computer infetto, i ricercatori hanno intercettato le destinazioni che il worm era programmato per contattare.
L'archivio Conficker di CAIDA descrive l'epidemia rilevata per la prima volta nel novembre 2008, con le prime varianti che generavano circa 250 nomi di dominio pseudocasuali al giorno. Il worm contattava i nomi generati tramite HTTP per ottenere istruzioni o malware aggiuntivo.
I ricercatori e gli operatori di rete hanno registrato domini selezionati prima che i criminali potessero utilizzarli, per poi puntare tali nomi verso server controllati. Di conseguenza, i computer infetti hanno contattato infrastrutture gestite da chi si occupa di difesa.
La ricerca è diventata un punto di misurazione
Tali callback hanno aiutato i team di risposta a identificare i sistemi infetti, stimare la diffusione del worm e monitorare lo stato di bonifica senza comunicare direttamente con la rete di comando criminale. Un'intercettazione riuscita ha quindi fatto molto di più che negare un aggiornamento: ha registrato un computer che tentava ancora di ottenerne uno.
- Per il contenimento, gli addetti alla risposta alle emergenze hanno impedito che determinati nomi selezionati portassero a infrastrutture controllate da malintenzionati.
- Per le indagini, i registro delle chiamate di ritorno hanno identificato i sistemi che richiedevano attenzione.
- Per il tracciamento della bonifica, le chiamate di ritorno continue indicavano che la pulizia era ancora incompleta.
Le varianti successive di Conficker hanno ampliato l'insieme dei nomi generati e aggiunto l'aggiornamento peer-to-peer. Chi si è occupato della risposta ha dovuto coordinare la registrazione e il blocco anziché affidarsi a un elenco ridotto e statico.
La distribuzione storica differiva anche dalla politica di filtraggio locale di un'organizzazione. I ricercatori hanno modificato le destinazioni dei domini da loro controllati, influenzando i computer infetti che risolvevano tali nomi tramite il DNS ordinario. L'gestore di una struttura applica generalmente la politica direttamente al proprio resolver ricorsivo.
La copertura rappresentava il vincolo in entrambi i casi. I difensori potevano intercettare le chiamate di ritorno ai nomi sotto il loro controllo, ma ciò non significava che ogni possibile percorso di aggiornamento fosse scomparso. Conficker ha affermato il sinkholing sia come tecnica di contenimento sia come strumento di misurazione, non come sostituto della riparazione dei computer infetti.
Trasformare i riscontri dei sinkhole in tracce di dispositivi infetti
Un client che interroga ripetutamente un dominio di comando e controllo (C2) bloccato merita attenzione. Il modello può fornire un'indicazione utile anche quando non si dispone di un agente endpoint, dell'ispezione del payload o di record firewall dettagliati.
La dipendenza è importante: il documento sulla difesa dalle botnet dell'Università dell'Arizona spiega che un reindirizzamento DNS efficace richiede l'identificazione dell'infrastruttura C2 della botnet e la cooperazione dell'operatore DNS utilizzato dalla botnet. Un riscontro indica che una determinata richiesta ha riscontrato la Sua policy, non che sono stati individuati tutti i percorsi di comunicazione.
Mantenere un contesto sufficiente per individuare il client
Registri questi campi insieme anziché disperderli tra dashboard scollegate:
- Marca temporale: Correlare l'evento con i lease di rete e i record di autenticazione.
- SSID o VLAN: Identificare la rete e il limite di policy interessati.
- Identificatore del client: Conservare un riferimento al dispositivo utilizzabile, non solo l'indirizzo pubblico della sede.
- Dominio interrogato: Mantenere l'hostname esatto che ha attivato la regola.
- Categoria di policy: Distinguere una classificazione di minaccia da una restrizione sui contenuti.
- Azione di risposta: Registrare se il resolver ha reindirizzato, rifiutato o restituito NXDOMAIN.
Un indirizzo IP sorgente pubblico può rappresentare molti ospiti dietro lo stesso gateway. Per identificare un singolo dispositivo, correlare le osservazioni sull'endpoint con i record del resolver e della rete. Non etichettare l'intera struttura come infetta solo perché un collettore rileva il suo indirizzo condiviso.
Regola di indagine: Gestire un riscontro del sinkhole come una traccia con contesto di supporto, non come un verdetto automatico contro il proprietario del dispositivo.
Convalidare il segnale e mantenere la copertura
Confronti gli accessi ripetuti con il comportamento normale su tale rete e verifichi la classificazione rispetto ai feed di threat intelligence aggiornati. I domini generati, l'hosting che cambia rapidamente, gli indirizzi hardcoded e i canali di fallback possono lasciare lacune. L'assenza di accessi non è una prova del fatto che un dispositivo sia pulito.
Anche lo stato del dominio richiede una revisione continua. Uno studio accademico del 2019 sulla rimozione di domini dannosi ha rilevato che oltre il 14% dei domini rimossi durante i dieci mesi precedenti era successivamente tornato sul mercato commerciale dei domini.
Revisionare periodicamente la provenienza, la proprietà e la classificazione delle regole. Se si gestiscono direttamente domini sinkhole registrati, è necessario proteggerne la configurazione DNS e i rinnovi. Limitare l'accesso ai log a livello di client e impostare periodi di conservazione conformi alla legislazione locale e alle esigenze di analisi.
Modelli di implementazione per reti condivise e di ospiti
Un sinkhole protegge il percorso DNS controllato dall'utente. Il browser o l'applicazione di un ospite potrebbe invece selezionare un resolver crittografato esterno, lasciando la politica locale priva di elementi da valutare.
Un'analisi tecnica del DNS crittografato spiega perché il DNS-over-HTTPS esterno può aggirare il monitoraggio DNS convenzionale. La decisione di implementazione riguarda quindi l'applicazione dei resolver e il comportamento del client, non semplicemente la qualità di un elenco di blocco.
Modelli di implementazione del sinkhole per reti condivise
| Modello | Dove risiede il controllo | Soluzione ideale | Limite principale |
|---|---|---|---|
| Resolver di rete su WiFi per ospiti WiFi | Resolver fornito a ciascun client dalla rete | Hotel, pub, WiFi pubblico WiFi | I client con un proprio resolver hardcoded o crittografato possono aggirarlo |
| Ispezione DNS del firewall | All'interno di un firewall o gateway esistente | Uffici con una struttura firewall consolidata | L'ispezione DNS convenzionale non rileva il DoH esterno veicolato come HTTPS |
| Criterio per browser o dispositivi gestiti | Il browser o il sistema operativo imposta il resolver e disabilita il DoH alternativo | Dispositivi aziendali o scolastici gestiti | Non raggiunge i dispositivi personali non gestiti |
| Protective DNS in cloud | Resolver ospitato dal provider a cui punta il DNS di rete | Sedi e strutture multi-sito | Dipende dal tempo di attività del provider e dall'accesso alla telemetria |
Crittografia e applicazione sono scelte distinte
Il DNS crittografato migliora la riservatezza tra il client e il resolver. Ciò non indebolisce necessariamente il filtraggio: un resolver di protezione approvato può accettare query crittografate e applicare comunque la politica. Il problema di visibilità sorge quando il client sceglie un resolver esterno che non applica le Sue regole.
Per i dispositivi gestiti, le politiche del browser e del sistema operativo possono specificare il servizio approvato. Sulle reti guest, è necessaria una posizione documentata sul DNS crittografato alternativo, sulla privacy degli utenti e sulle eccezioni consentite. Bloccare tutto il traffico web crittografato per fermare DoH non è una strategia generale praticabile.
Posizionare il controllo su un confine che sia possibile testare
Distribuire il resolver approvato tramite la configurazione di rete. Limitare il DNS convenzionale in uscita diretta ai soli resolver approvati, coprendo sia i protocolli di trasporto sia entrambe le famiglie di IP. Il reindirizzamento trasparente può intercettare il DNS convenzionale inviato altrove, ma non risolve in modo trasparente il DNS crittografato arbitrario.
Utilizzare la segmentazione della rete per separare le policy del personale, degli ospiti e dei dispositivi specializzati. Una regola restrittiva per gli ospiti non dovrebbe interrompere le apparecchiature cliniche o le applicazioni del personale.
- Testare la risoluzione ordinaria: Confermare che le applicazioni consentite continuino a funzionare.
- Testare i percorsi di bypass: Verificare i resolver selezionati dal browser e gli altri tunnel consentiti.
- Testare l'attribuzione: Confermare che la corrispondenza con una politica controllata compaia in riferimento alla rete e al client corretti.
Una modifica del DNS a livello di rete può applicare il filtraggio su tutti i dispositivi partecipanti senza installare software su ciascuno di essi. Dimostrare la copertura con dei test, piuttosto che presumere che la distribuzione di un indirizzo di resolver li forzi tutti a utilizzarlo.
Falsi positivi e come ripristinare rapidamente
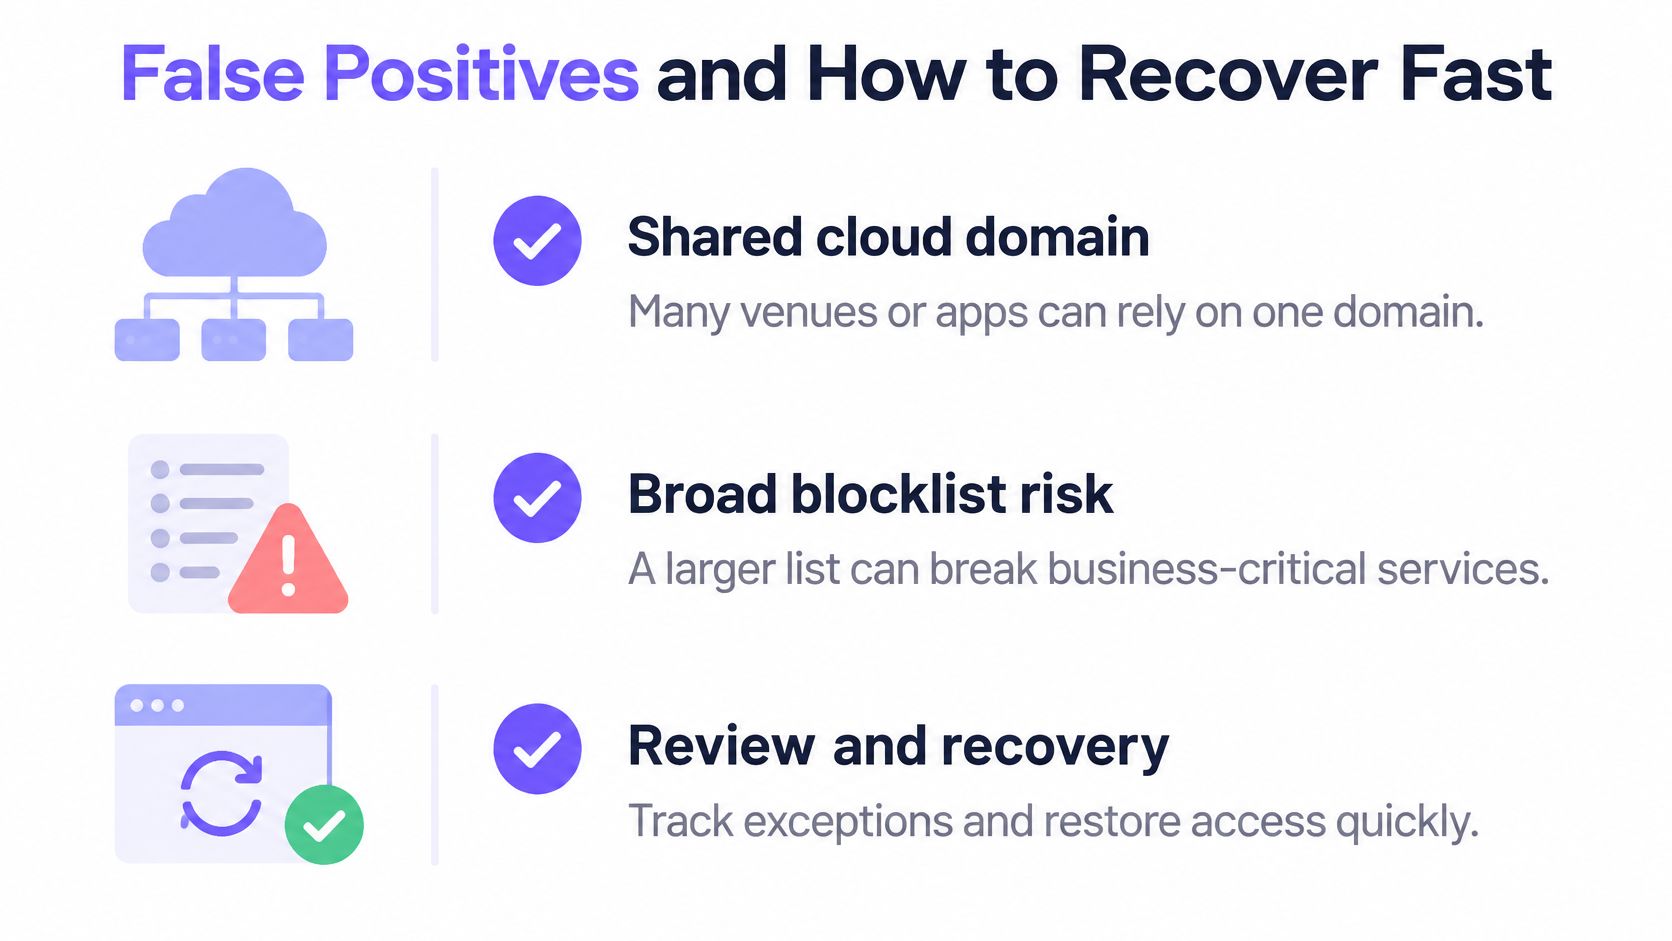
Una blocklist più estesa non è automaticamente più sicura. Una regola generica contro un'infrastruttura cloud condivisa può interrompere portali dei fornitori, flussi di lavoro di pagamento o applicazioni di apprendimento senza migliorare la protezione contro la minaccia prevista.
Uno studio sull'implementazione del sinkholing del 2025 ha segnalato falsi positivi che hanno richiesto la gestione manuale dell'allowlist e personale qualificato. La responsabilità operativa appartiene al piano di distribuzione, non solo alla coda degli incidenti.
Il processo di ripristino deve tenere conto dei servizi condivisi e delle eccezioni a ambito ristretto.
Ripristinare l'accesso senza rimuovere la protezione
Avviare le nuove politiche in modalità di soli log per un periodo di osservazione concordato. Utilizzare Capture per il client, la categoria e la regola corrispondente, in modo che le decisioni successive dispongano di una traccia di evidenze.
Sintomi del sinkhole, probabili cause e prime azioni
| Sintomo | Causa probabile | Prima azione |
|---|---|---|
| Il dispositivo del personale non riesce a raggiungere il sito di un fornitore | Dominio cloud condiviso bloccato per categoria | Verificare la categoria registrata nei log, quindi inserire in allowlist l'host esatto e non l'intero dominio |
| Un dispositivo ospite attiva hit del sinkhole ogni minuto | Dispositivo infetto o app aggressiva che riprova la connessione | Identificare e isolare il client, quindi pianificare l'ispezione del dispositivo |
| Picco di query bloccate dopo una modifica alle policy | Voce di blocklist generica o regola con carattere jolly | Annullare l'ultima modifica e rivederne l'ambito SSID o VLAN |
| Le app funzionano, ma un SSID non mostra alcun blocco | I client potrebbero utilizzare DNS crittografati all'esterno del resolver | Eseguire un test di policy controllato e ispezionare la configurazione del resolver e i percorsi DNS in uscita |
Un report vuoto da solo non dimostra l'aggiramento. La rete potrebbe semplicemente non aver generato richieste corrispondenti.
È opportuno misurare le connessioni dannose impedite, il tasso di falsi positivi, i tempi di risoluzione dei ricorsi e le eccezioni per sede. Il solo volume delle query bloccate può aumentare a causa dei ripetuti tentativi effettuati da un'applicazione.
Prima di abilitare una regola, confermare quanto segue:
- Classificazione: La categoria di minaccia del dominio è supportata.
- Uso condiviso: Le applicazioni aziendali non dipendono dallo stesso host o dominio padre.
- Rollback: La policy precedente e la procedura di ripristino vengono registrate.
- Ambito: Il SSID o VLAN previsto è esplicito.
- Titolarità: Una persona designata gestisce le richieste di eccezione e ne verifica la scadenza.
Valutare se un sinkhole è adatto alla propria rete
Per un piccolo ufficio con endpoint gestiti, si consiglia di iniziare con la registrazione DNS e la politica degli endpoint. È possibile che si disponga già dei controlli sui dispositivi necessari per indagare direttamente sulle richieste sospette, evitando così di aggiungere un collector che non si è in grado di mantenere.
Per le reti di ospiti, pubbliche o di studenti, dare la priorità all'applicazione dei limiti di perimetro e all'attribuzione dei client. I dispositivi non gestiti rendono utili i controlli a livello di resolver, ma un operatore ha comunque bisogno di un modo sicuro per analizzare o isolare un dispositivo senza accusare prematuramente il suo proprietario.
Adattare il modello operativo all'infrastruttura
Un'organizzazione con più sedi trae beneficio da una politica dei resolver gestita a livello centrale, da eccezioni specifiche per rete e da una reportistica consolidata. Confronti i servizi in base alle evidenze che mostrano e ai controlli che è possibile testare, non solo in base al numero di categorie.
Scegliere un sinkhole quando è possibile gestire l'intero processo: politiche, copertura, analisi, eccezioni e ripristino.
Iniziare con un'implementazione limitata:
- Mappare il percorso del resolver. Identificare quale resolver utilizza ciascuna rete e dove DNS alternativi o tunnel potrebbero eludere la policy.
- Eseguire un periodo documentato di sola osservazione dei log. Registrare le richieste corrispondenti con il relativo client, categoria e rete, quindi esaminare le dipendenze delle applicazioni legittime.
- Abilitare prima i blocchi ad alta affidabilità. Iniziare con le destinazioni C2 e malware confermate, mantenere un piano di ripristino scritto e assegnare un responsabile per le eccezioni.
Mantenere la remediation degli endpoint separata dal contenimento di rete. Un callback bloccato è un intervento riuscito, ma il dispositivo necessita comunque di verifiche. La distribuzione è pronta quando il personale può dimostrare sia un blocco controllato che un ripristino sicuro dell'accesso legittimo.
Purple Shield offre un DNS protettivo con policy e reportistica specifiche per la rete, consentendo di valutare il blocco dei domini dannosi unitamente agli elementi necessari per gestirlo. Visiti Purple Shield per organizzare una prova gratuita di 30 giorni, indirizzi il DNS della Sua rete verso Shield e testi il filtraggio sulla Sua rete attiva senza dover installare nuovo hardware o agenti sul dispositivo.